В статье, опубликованной 3 ноября в npj Unconventional Computing, авторы определяют концепцию современного аналогового вычисления. Работа под названием «Modern analog computing for solving differential and matrix equations» возглавляется Суном Чжонгом из Института искусственного интеллекта и Школы интегрированных схем Пекинского университета. Соавторами являются Пиерджиулио Маннокки из Политехнического университета Милана и Unconventional AI, а также Мануэль Ле Гальо и Абу Себастьян из IBM Research Europe в Цюрихе. Об этом сообщила QbitAI в тот же день.
В обзоре выделяются три основных элемента: решение дифференциальных уравнений, решение матричных уравнений и выполнение матрично-векторного умножения. Эти элементы используют общий набор операторов — сумматоры, умножители и интеграторы — и математически связаны, поскольку дискретизированные дифференциальные уравнения превращаются в матричные уравнения, которые могут решаться либо многократным матричным умножением, либо за один шаг с помощью аналоговой сети с замкнутым контуром. Авторы прослеживают реализацию от дискретных компонентов до резистивных памяти и интегральных схем на основе CMOS, а также обсуждают применимость, точность, масштабируемость, связь с вычислениями в памяти и вычислительную сложность.
По словам Суна, современный подход отличается от аналоговых компьютеров, которые были вытеснены цифровыми чипами десятилетия назад, по трем направлениям. Во-первых, он ориентирован на матричные нагрузки в области искусственного интеллекта и беспроводной связи, а не исключительно на дифференциальные уравнения. Во-вторых, он базируется на устройствах резистивной памяти, таких как мемристоры, вместо аналоговых схем на основе CMOS. В-третьих, он использует инженерные методы для достижения высокой точности и масштаба.
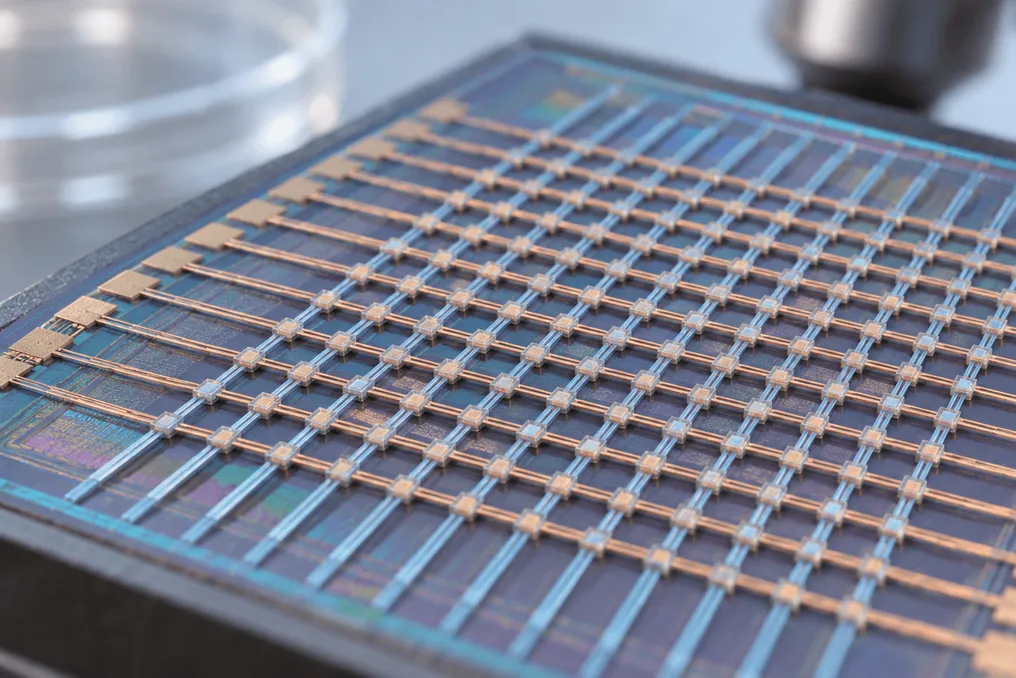
В кроссбаре таких устройств один операнд программируется как проводимость устройства, а другой подается в виде напряжения; таким образом, закон Ома выполняет каждое умножение, а закон Кирхгофа о токах суммирует каждый столбец. Соответственно, массив размером 1000 на 1000 содержит миллион умножителей, тогда как аналоговый чип на основе CMOS 2016 года, упомянутый Суном, вмещал всего четыре интегратора и восемь умножителей. Добавление обратной связи с помощью операционного усилителя позволяет схеме достигать решения матричного уравнения за наносекунды.
Данный обзор опирается на более ранние работы Суна. В 2019 году его команда продемонстрировала решение матричного уравнения за один шаг на резистивном массиве 3x3 в журнале PNAS, с погрешностью около 3%. В статье Nature Electronics 2025 года использовалось битовое нарезание с восемью состояниями проводимости на устройство для достижения фиксированной точности 24 бит, что снизило относительную ошибку до $10^{-4}$ после трех итераций, а затем до $10^{-7}$, сопоставимой с FP32, и масштабировано до матриц 512x512 с использованием блочного алгоритма. По оценкам самой команды, пропускная способность составила примерно в 1000 раз, а энергоэффективность — около 100 раз выше, чем у ядра Nvidia H100 и цифровых ASIC с точностью FP32. Эти показатели еще не прошли независимую проверку.
Обсуждаемые области применения включают управление движением роботов в реальном времени, обнаружение сигналов Massive MIMO для 6G и оптимизацию второго порядка для обучения больших моделей.