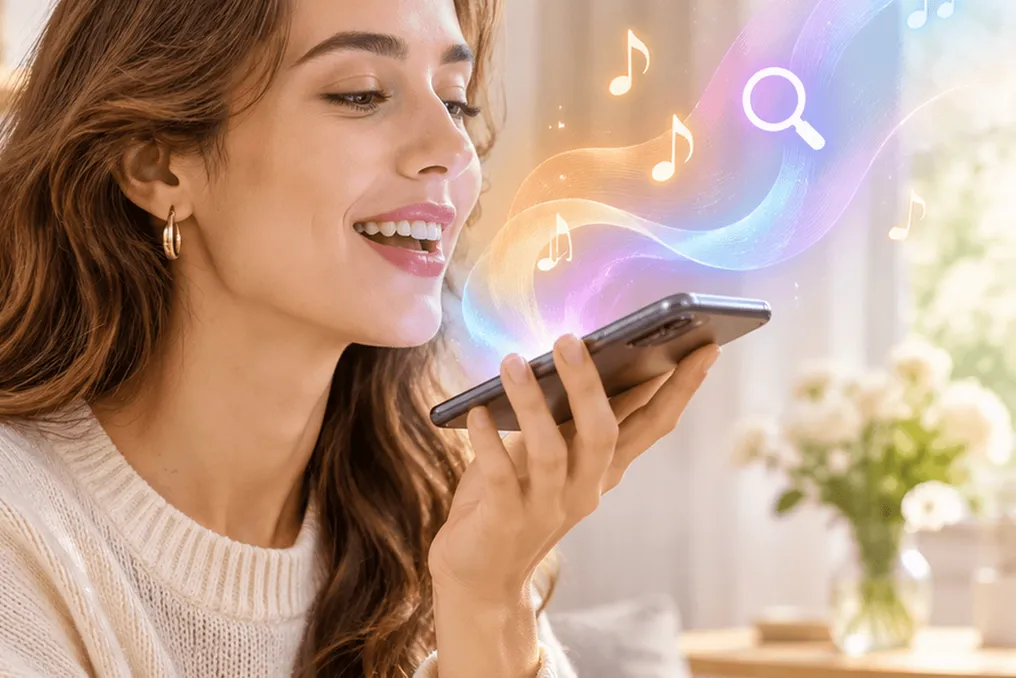
Tencent Hunyuan Hy Realtime वॉयस AI मॉडल खोज की आवश्यकता का स्वयं निर्धारण और अनुरोध पर गाने बजाने में सक्षम है
और पढ़ें
Pandaily
pandaily.com

Tencent Hunyuan Hy Realtime वॉयस AI मॉडल खोज की आवश्यकता का स्वयं निर्धारण और अनुरोध पर गाने बजाने में सक्षम है

Tencent Hunyuan ने Hy Realtime मॉडल प्रस्तुत किया है, जो एक वास्तविक समय वॉयस मॉडल है और दैनिक बातचीत में टूल कॉलिंग और गायन सुविधाओं को एकीकृत करता है। यह मॉडल पहले से ही Tencent Yuanbao प्लेटफॉर्म पर वॉयस कॉल और Tencent ग्राहक सेवा में उपलब्ध है। कंपनी ने बताया कि जल्द ही Hy Realtime को Tencent Cloud पर API के माध्यम से पेश किया जाएगा। मॉडल की घोषणा 13 नवंबर को की गई थी।

Tencent के बयानों के अनुसार, Hy Realtime को मानव भाषण की विशेषताओं को ध्यान में रखकर विकसित किया गया है। यह मॉडल बड़बड़ाने, वाक्यांशों को बाधित करने या विचार के दौरान स्व-सुधार जैसी विशेषताओं के साथ काम कर सकता है। वास्तविक अर्थ के पुनर्निर्माण के लिए आसपास की बातचीत के संदर्भ का उपयोग किया जाता है। इसके अलावा, बहु-चरणीय निर्देशों का पालन करने और संदर्भ प्रबंधन की क्षमताओं में सुधार किया गया है, जिससे मॉडल लंबी बातचीत के दौरान उपयोगकर्ता के इरादे को ट्रैक कर सकता है।

मॉडल में बाहरी उपकरणों को कॉल करने की सुविधा भी है। बातचीत की सामग्री और उपयोगकर्ता के इरादों के आधार पर, यह वेब खोज की आवश्यकता का निर्णय लेता है, फिर इस खोज का प्रबंधन करता है, टूल कॉल निष्पादित करता है और एक एकीकृत प्रक्रिया के हिस्से के रूप में एक वॉयस प्रतिक्रिया प्रदान करता है। आउटपुट गुणवत्ता के मामले में, Tencent का दावा है कि मॉडल ऑडियो गुणवत्ता, उच्चारण, प्रोसोडी और भावनात्मक अभिव्यक्ति में अपने पूर्ववर्ती से बेहतर है, जिससे बातचीत के दौरान अधिक प्राकृतिक स्वर परिवर्तन सुनिश्चित होते हैं।

गायन कार्यक्षमता Tencent Music Entertainment की एआई टीम के सहयोग से विकसित की गई है। उपयोगकर्ता कलाकार, एल्बम, शैली, भाषा, रिलीज वर्ष या लोकप्रियता जैसे मापदंडों का उल्लेख करके रचनाओं का अनुरोध कर सकते हैं, और बाद की प्रतिक्रियाओं में इन शर्तों को संयोजित और परिष्कृत कर सकते हैं। Tencent के उदाहरण में, उपयोगकर्ता ने 2010 और 2020 के बीच जारी एक अंग्रेजी लोक गीत का अनुरोध किया, और मॉडल ने उपयुक्त विकल्प ढूंढ लिया और उसे गा दिया। Tencent बताता है कि उन्होंने अभिव्यक्ति, प्राकृतिक वाक्यांशण, श्वास, साथ ही धुन और लय देने के लिए वोकल को ट्यून किया है।

Tencent ने खोज और उत्तर कार्यों के विशेषज्ञों द्वारा आंतरिक ब्लाइंड परीक्षणों, साथ ही नो-थिंकिंग मोड और कई सार्वजनिक वॉयस बेंचमार्क के लिए आंतरिक परीक्षण सेट में सकारात्मक परिणाम बताए हैं। कंपनी इन सार्वजनिक परीक्षणों पर अपने समग्र परिणामों को अग्रणी बताती है। यह ध्यान रखना महत्वपूर्ण है कि ये कंपनी के अपने मूल्यांकन हैं, और प्रकाशित पाठ में नमूना आकार या परीक्षण सेटिंग्स का उल्लेख नहीं किया गया है।

उपयोगकर्ता नवीनतम Yuanbao ऐप में Chuyu नामक आवाज चुनकर वॉयस कॉल के माध्यम से या Tencent Cloud पर वेब डेमो के माध्यम से मॉडल का परीक्षण कर सकते हैं। Tencent द्विदिश इंटरैक्शन, दीर्घकालिक व्यक्तिगत स्मृति और मुख्य वार्ता एजेंट और पृष्ठभूमि एजेंटों के बीच समन्वय की दिशा में आगे विकास की योजना बना रहा है।

समान कहानियाँ

MOSS-Live सिस्टम वॉयस मेट्रिक्स में उच्च प्रदर्शन प्रदर्शित करती है, लेकिन मल्टी-टर्न कार्यों में GPT-Live-1 से पीछे रहती है
और पढ़ें
pandaily.com

MOSS-Live सिस्टम वॉयस मेट्रिक्स में उच्च प्रदर्शन प्रदर्शित करती है, लेकिन मल्टी-टर्न कार्यों में GPT-Live-1 से पीछे रहती है

फूडान विश्वविद्यालय की ओपनMOSS टीम और MOSI इंटेलिजेंस ने अपनी फुल-डुप्लेक्स वॉयस इंटरैक्शन सिस्टम MOSS-Live का विस्तृत मूल्यांकन प्रस्तुत किया। इस सिस्टम की तुलना OpenAI के मॉडलों, जैसे GPT-Live-1 और GPT Realtime 2.1, के साथ-साथ ByteDance के Doubao SeedDuplex और दो Qwen Audio 3.0 मॉडलों से की गई। 13 नवंबर के ओपनMOSS ब्लॉग पोस्ट में MOSS-Live की ताकत और कमजोर क्षेत्रों का विवरण दिया गया है। यह ध्यान रखना महत्वपूर्ण है कि प्रस्तुत सभी आंकड़े विक्रेताओं द्वारा प्रदान किए गए डेटा हैं, और सैंपल साइज़, अनिश्चितता मूल्यांकन और पूर्ण परीक्षण स्थितियों के बारे में जानकारी प्रकट नहीं की गई है।

छह घोषित फुल-डुप्लेक्स इंटरैक्शन मेट्रिक्स पर MOSS-Live ने पहला स्थान हासिल किया। सिस्टम केवल 2% मामलों में ऐसे भाषण पर प्रतिक्रिया करता था जो उसे संबोधित नहीं किया गया था, जो GPT-Live-1 के 68% और Doubao SeedDuplex के 75% की तुलना में काफी बेहतर है। इसके अलावा, यह उपयोगकर्ता के विराम के दौरान केवल 1.44% मामलों में हस्तक्षेप करता था, जबकि प्रतिस्पर्धियों में यह क्रमशः 10.37% और 14.29% था। सिस्टम ने 68% मामलों में बाहरी रुकावटों को सही ढंग से नजरअंदाज किया, जबकि अन्य मॉडलों के आंकड़े 21% और 13% थे, और इसने 'हम्म' जैसी संक्षिप्त पुष्टि के दौरान अपनी व्यवहार रेखा को 98.17% मामलों में बनाए रखा।

अन्य मापदंडों पर परिणाम मिश्रित रहे। FDB v3 टूलकिट का उपयोग करते हुए, MOSS-Live ने 51% सफलता दर दिखाई, जिसने इसे Doubao SeedDuplex के साथ अग्रणी के रूप में स्थापित किया और GPT-Live-1 के 45% से आगे निकल गया। हालांकि, टूल उपयोग परिदृश्यों में सिस्टम की प्रतिक्रिया समय 2.36 सेकंड था, जो GPT Realtime 2.1 के 1.61 सेकंड से धीमा था। बहु-चरणीय कार्यों के बेंचमार्क τ-Voice में, MOSS-Live ने 57.93% अंक प्राप्त किए, जो GPT-Live-1 के 67.68% से कम थे, लेकिन Doubao के 17.38% से काफी अधिक थे। दो सेकंड के भीतर बोलने का अधिकार छोड़ने वाले मामलों का प्रतिशत 52.49% था, जो Qwen Audio मॉडलों के 93% से काफी कम था। बिग-बेंच ऑडियो पर ऑडियो समझ में MOSS-Live ने 88.40% दिखाया, जो Doubao के 90.50% से कम था। बहु-चरणीय निर्देशों का पालन करते समय सिस्टम ने 5 में से 3.35 अंक प्राप्त किए, जबकि GPT-Live-1 ने 3.72 अंक प्राप्त किए, हालांकि MOSS-Live ने रुकावटों के बाद उत्तर की गुणवत्ता में नेतृत्व किया, जो 4.88 तक पहुंच गया।

MOSS-Live आर्किटेक्चर एक बैकग्राउंड मॉडल को जोड़ता है जो सुनने, क्यूइंग प्रबंधन और भाषण का कार्य करता है, एक बैकग्राउंड मॉडल के साथ जो तर्क, टूल कॉलिंग और लंबी अवधि के कार्यों के लिए जिम्मेदार है। ये दोनों मॉडल समन्वय स्तर के माध्यम से मेमोरी, संदर्भ और कार्य स्थिति का आदान-प्रदान करते हैं, जिससे होटल खोज या अन्य ऑपरेशन के दौरान संवाद जारी रह सकता है। सिस्टम स्ट्रीमिंग वीडियो, स्क्रीन डेमो और वास्तविक समय व्याख्या का भी समर्थन करता है।

यह सिस्टम ऑनलाइन सैंडबॉक्स और मॉडल आईडी moss-live-1.0 के तहत WebSocket realtime API के माध्यम से उपलब्ध है। MOSI इंटेलिजेंस, जो शंघाई इनोवेशन इंस्टीट्यूट के इनक्यूबेटर में स्थित है, ने ओपनMOSS टीम के साथ मिलकर पहले MOSS-Image और MOVA मॉडल जारी किए थे।

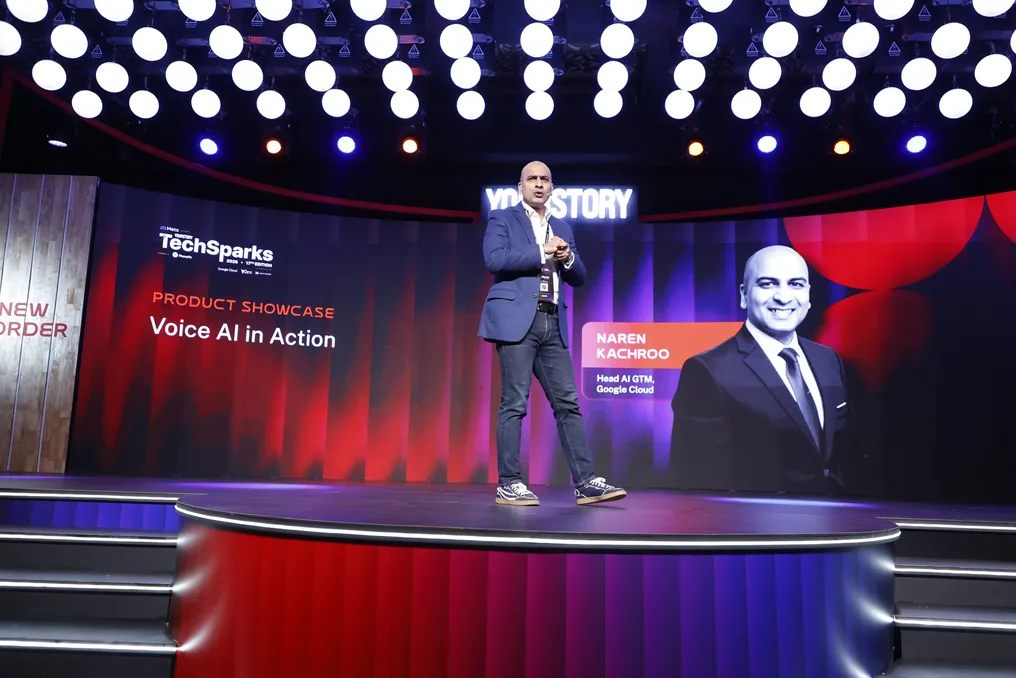
Google Cloud में Naren Kachroo ने TechSparks 2026 में वॉयस एआई के विकास का प्रदर्शन किया
और पढ़ें
yourstory.com

Google Cloud में Naren Kachroo ने TechSparks 2026 में वॉयस एआई के विकास का प्रदर्शन किया

नरेन कछरू, गूगल क्लाउड में बिक्री और जीटीएम एआई के प्रमुख, ने कहा कि सबसे मूल्यवान कृत्रिम बुद्धिमत्ता वह है जो सौंपे गए कार्य को पूरी तरह से पूरा कर सके। उन्होंने इस बात पर जोर दिया कि मूल्य तभी बनता है जब एआई की मदद से कार्य वास्तव में पूरा हो जाता है।

TechSparks 2026 कार्यक्रम में, 'वॉयस एआई इन एक्शन' नामक उत्पाद का प्रदर्शन करते हुए, कछरू ने गूगल के नवीनतम वॉयस मॉडल, ग्राहकों द्वारा उपयोग किए जाने वाले उदाहरणों और छोटे व्यवसायों के लिए विकसित एक लाइव डेमो का प्रदर्शन किया। उनका मुख्य विचार यह था कि आवाज लोगों और एआई के बीच बातचीत का प्राथमिक तरीका बन रही है, और भारत में यह बदलाव स्थानीय भाषाओं और लहजों में होगा।

कछरू ने उल्लेख किया कि उद्योग जनरेटिव एआई की अवधारणा से हट गया है, जिसे केवल प्रश्नोत्तर उपकरण के रूप में देखा जाता था। उन्होंने समझाया कि ध्यान अब ऐसे एआई पर केंद्रित हो गया है जिसके पास डेटा, उपकरण और क्षमताएं हैं जो व्यक्ति की ओर से कार्रवाई करने की अनुमति देते हैं।

गूगल ने हाल ही में जेमिनी 3.8 लाइव और जेमिनी 3.8 लाइव एक्सटेंडेड थिंकिंग प्रस्तुत किया है। जेमिनी 3.8 लाइव मॉडल एक ही बातचीत के भीतर 97 समर्थित भाषाओं को पहचानने और उनके बीच स्विच करने में सक्षम है। कछरू ने समझाया कि व्यवसाय इन दोनों मॉडलों के बीच कैसे चयन कर सकते हैं।

जेमिनी 3.8 लाइव मॉडल संवाद और एजेंट कार्यों से जुड़ी सरल समस्याओं के लिए उपयुक्त है, जैसे कि बुनियादी टूल कॉलिंग के साथ वॉयस चैट। जबकि एक्सटेंडेड थिंकिंग उन संवादों के लिए डिज़ाइन किया गया है जिनके लिए गहन तर्क, संदर्भ स्विचिंग और कई चरणों के निष्पादन की आवश्यकता होती है। उन्होंने यह भी उल्लेख किया कि एक्सटेंडेड थिंकिंग प्रति टोकन अधिक महंगा है।

दोनों मॉडल 'वॉयस टू वॉयस' प्रकार के हैं, जो एक ही सिस्टम के भीतर इनपुट और आउटपुट दोनों के रूप में भाषण को संसाधित करते हैं। डेवलपर्स के लिए जिन्हें इस प्रक्रिया के केवल एक हिस्से की आवश्यकता है, गूगल टेक्स्ट-टू-स्पीच, स्पीच-टू-टेक्स्ट और लाइव ट्रांसलेशन के लिए अलग-अलग मॉडल भी प्रदान करता है।

कछरू ने बताया कि टेक्स्ट-टू-स्पीच के लिए नवीनतम जेमिनी मॉडल ने भारतीय भाषाओं, लहजों और स्वर के उपयोग के साथ गूगल के आंतरिक परीक्षणों में उच्च परिणाम दिखाए हैं। उन्होंने संभावित उपयोग के परिदृश्यों की श्रृंखला दिखाने के लिए कई छोटे प्रदर्शन किए।

पहले उदाहरण में, शॉपिफाई सहायक, साइडकिक, ने विक्रेता को शॉपिफाई एडमिन पैनल के माध्यम से डोमेन कनेक्ट करने में चरण-दर-चरण मदद की। दूसरे उदाहरण में, एक वॉयस एजेंट ने आठ लोगों के लिए एक रेस्तरां में टेबल बुक की। कॉल के दौरान, कॉलर ने पूछा कि क्या केक की अनुमति है, समीक्षाओं से एक फोटो साझा की ताकि पता चल सके कि व्यंजन शाकाहारी है या नहीं, और बुकिंग की पुष्टि करने से पहले अन्य शाकाहारी विकल्पों के बारे में जानकारी मांगी। इस दूसरे परिदृश्य में एजेंट को कई संवाद चरणों के दौरान संदर्भ को ट्रैक करने, प्राथमिकताओं को याद रखने और कई टूल कॉल्स को निष्पादित करने की आवश्यकता थी, जो कछरू के अनुसार एक्सटेंडेड थिंकिंग के लिए आदर्श है।

उन्होंने लाइव अवतार का भी प्रदर्शन किया, जो जेमिनी की लाइव आवाज को वास्तविक समय वीडियो जनरेशन और लिप सिंक के साथ जोड़ता है, जिससे उपयोगकर्ताओं को केवल आवाज सुनने के बजाय एक एनिमेटेड चेहरा देखने की अनुमति मिलती है। गूगल ने हाल ही में जेमिनी एंटरप्राइज के माध्यम से व्यवसायों को लाइव अवतार प्रदान किया है, उत्पन्न ऑडियो और वीडियो सामग्री पर सिंथआईडी अदृश्य वॉटरमार्क लगाया है। सिटी एक पायलट ग्राहक के रूप में उभरा: इसका सिटी स्काई सहायक, जिसे गूगल डीपमाइंड और जेमिनी लाइव एपीआई की वास्तविक समय अवतार तकनीक का उपयोग करके बनाया गया है, अमेरिकी कल्याण क्षेत्र के ग्राहकों को निर्णय लेने में मदद करता है, जैसे कि जमा प्रमाणपत्र को भुनाने के संबंध में।

कछरू ने उल्लेख किया कि जेमिनी 3.8 लाइव तुलनीय मॉडलों में प्रति टर्न सबसे कम लागत वाला है, और एक्सटेंडेड थिंकिंग स्पीच-टू-स्पीच रूपांतरण की गुणवत्ता में उद्योग मानक स्थापित करता है। गूगल ने दावा किया है कि आर्टिफिशियल एनालिसिस से स्पीच-टू-स्पीच रूपांतरण गुणवत्ता सूचकांक पर एक्सटेंडेड थिंकिंग ने 82.6 अंक प्राप्त किए हैं, जो उच्चतम है।

उन्होंने स्पष्ट किया कि कम कीमत का कारण यह है कि गूगल पूरे स्टैक का प्रबंधन स्वयं करता है - टीपीयू चिप्स और बुनियादी ढांचे से लेकर मॉडल और एप्लिकेशन तक, और इस दक्षता को ग्राहकों को प्रदान करता है। यह गूगल को उच्च गुणवत्ता वाले मॉडल और अधिक किफायती वर्कहॉर्स दोनों की पेशकश करने की अनुमति देता है।

वॉयस एआई के उपयोग के उदाहरणों के रूप में, कछरू ने दो ग्राहकों का उल्लेख किया: ऑटोट्रेडर, जो पुरानी कारों की खरीद और बिक्री के लिए इस तकनीक का उपयोग करता है, और इक्वल एआई, एक भारतीय स्टार्टअप जिसका सहायक उपयोगकर्ता के फोन उठाने से पहले कॉल का जवाब देता है और उसे संभालता है।

सत्र का केंद्रीय बिंदु माइक्रो, लघु और मध्यम उद्यमों (एमएसएमई) के लिए सहायक का लाइव डेमो था, जिसे कछरू की टीम ने लगभग एक दिन में विकसित किया था। यह एक बड़ा संभावित बाजार है: एमएसएमई मंत्रालय के आंकड़ों के अनुसार, फरवरी 2026 तक उद्यम सरकार पोर्टल पर 7.8 करोड़ से अधिक उद्यम पंजीकृत हैं। कछरू ने पहले ही एक जोखिम के बारे में चेतावनी दी थी: उन्होंने होटल नेटवर्क से कनेक्ट न हो पाने के बाद मोबाइल हॉटस्पॉट के माध्यम से डेमो शुरू किया था।

डेमो में सुरक्षात्मक गियर बनाने वाली एक काल्पनिक कंपनी और उसके मालिक, राजेश, शामिल थे, जिन्हें अभी-अभी लगभग 500 हेलमेट मिले थे। सहायक से बात करते हुए, राजेश ने पूछा कि उसके पास हेलमेट के लिए कितने संभावित ग्राहक हैं। सहायक ने दो पाए: मुंबई में एक निर्माण कंपनी जिसे 500 हेलमेट की आवश्यकता थी, और आग्र में एक हार्डवेयर स्टोर जिसे 50 की आवश्यकता थी। राजेश ने सहायक को छोटे ऑर्डर को छोड़ने, मुंबई के खरीदार को व्यावसायिक प्रस्ताव भेजने और सौदे को अंतिम रूप देने के लिए उसे कॉल करने का निर्देश दिया। उसने एक शर्त रखी: कीमत प्रति हेलमेट 400 रुपये से ऊपर रहनी चाहिए, और सहायक को बिना दोबारा अनुमोदन के ऑर्डर दे सकता था। फिर सहायक ने खरीदार को कॉल किया और हिंदी में बातचीत की। कछरू ने उल्लेख किया कि सहायक ने बाहरी कॉल के दौरान राजेश के साथ आंतरिक बातचीत से संदर्भ बनाए रखा, कंपनी की ओर से बातचीत की और सौदा बंद कर दिया।

कछरू के अनुसार, यही एंड-टू-एंड प्रक्रिया वॉयस एआई के विकास की दिशा है। उनका मानना है कि 3.8 लाइव मॉडल के साथ, उद्यम अब अपने प्रक्रियाओं में वॉयस एजेंटों को एकीकृत कर सकते हैं जो स्वतंत्र रूप से कार्य करते हैं। कछरू ने जोड़ा कि यह सहायक तमिल, तेलुगु, मलयालम, कन्नड़, मराठी और अन्य भाषाओं में भी ऐसा ही संवाद कर सकता था। उन्होंने इस बात पर जोर दिया कि यह महत्वपूर्ण है क्योंकि भारतीय उपभोक्ता तेजी से वॉयस इंटरैक्शन पर निर्भर हो रहा है। जेमिनी लाइव अब 25 से अधिक भारतीय भाषाओं और बोलियों का समर्थन करता है। IAMAI-Kantar इंटरनेट इन इंडिया 2024 रिपोर्ट के अनुसार, भारत के 886 मिलियन सक्रिय इंटरनेट उपयोगकर्ताओं में से 98% भारतीय भाषाओं में सामग्री प्राप्त करते हैं, और पांच में से एक नेटवर्क में बाहर निकलने के लिए वॉयस कमांड का उपयोग करता है।

उन्होंने निष्कर्ष निकाला, 'मेरा मानना है कि आवाज भविष्य है।' उन्होंने जोड़ा कि भारत में वॉयस एआई को उन भाषाओं, लहजों और चीजों के अनुकूल होना चाहिए जिनकी लोग बात करते हैं और जिनसे वे परिचित हैं। कछरू ने बताया कि गूगल डीपमाइंड में बेंगलुरु में एक टीम है जो भारतीय लहजों और सांस्कृतिक बारीकियों पर ध्यान केंद्रित करते हुए आवाज पर शोध कर रही है। गूगल इंडियन इंस्टीट्यूट ऑफ साइंस और ARTPARK द्वारा कार्यान्वित प्रोजेक्ट वाणी को भी वित्त पोषित करता है, जिसने 165 जिलों से 105 भाषाओं में 31,000 से अधिक घंटों की आवाज खोली है।

अंत में, कछरू ने संस्थापकों और डेवलपर्स से मॉडलों का परीक्षण करने, अनुभव का उपयोग करने और प्रतिक्रिया साझा करने का आग्रह किया, जिसमें यह भी जानकारी शामिल है कि क्या काम नहीं कर रहा है, ताकि गूगल की अनुसंधान और विकास टीमों उन्हें बेहतर बना सकें। उनका व्यापक विचार यह था कि वॉयस एआई साधारण संचार से वास्तविक निष्पादन की ओर बढ़ने के लिए तैयार है, और भारत, अपनी भाषाई विविधता और उपयोगकर्ताओं के आवाज पर ध्यान केंद्रित करने के कारण, उन बाजारों में से एक है जहां यह बदलाव सबसे पहले परखा जाएगा।
Tencent Hunyuan का शोध एजेंट Hyra 2.0 प्रोटीन, गणितीय प्रमाण और चिप्स के साथ काम करने के लिए उपकरण स्वयं बनाता है
और पढ़ें
pandaily.com

Tencent Hunyuan का शोध एजेंट Hyra 2.0 प्रोटीन, गणितीय प्रमाण और चिप्स के साथ काम करने के लिए उपकरण स्वयं बनाता है

Tencent Hunyuan ने Hyra 2.0 जारी किया है, जो अपने स्वायत्त अनुसंधान एजेंट का दूसरा संस्करण है, जिसे 2 नवंबर को प्रस्तुत किया गया था। Hyra 1.0 के विपरीत, जो एकल कार्यों को हल करने पर केंद्रित था, जैसे कि Hy3 मॉडल का उपयोग करके योग बनाम अंतर के घातांक समस्या को हल करना, नया संस्करण पुन: प्रयोज्य अनुसंधान उपकरणों के निर्माण के लिए डिज़ाइन किया गया है। कार्य परिणाम और संबंधित कोड Apache 2.0 लाइसेंस के तहत GitHub पर रिपॉजिटरी में उपलब्ध हैं।

Hyra 2.0 एक त्रि-स्तरीय प्रणाली के रूप में कार्य करता है, जिसमें सामान्य, मिशन और कार्य एजेंट शामिल हैं। ये एजेंट एक सामान्य अनुसंधान बोर्ड और एक स्थायी कार्य कतार के माध्यम से समन्वय करते हैं। एक विशेष कार्य एजेंट परिणामों की जाँच करता है, एजेंट बहु-स्तरीय मेमोरी का समर्थन करते हैं, और सामान्य ज्ञान आधार प्राप्त सीखों को लागू कौशल में सारांशित करता है।

सिस्टम द्वारा बनाए गए उपकरण

Tencent ने इस सिस्टम द्वारा विकसित कई उपकरणों का प्रदर्शन किया। इनमें HyInv शामिल है - 1.96 मिलियन मापदंडों वाला एक प्रोटीन रिवर्स फोल्डिंग मॉडल। यह मॉडल ProteinMPNN की तुलना में 57 गुना तेज चलता है, बेहतर संरचनात्मक अनुरूपता प्रदर्शित करता है और केवल 50 मिलीसेकंड में 128 अनुक्रमों को डिजाइन करने में सक्षम है।

प्रोटीन के लिए भाषा मॉडल HyPLM-Flash भी पेश किया गया था, जिसमें 650 मिलियन पैरामीटर हैं और 726 बिलियन टोकन पर प्रशिक्षित किया गया है। यह 12 तुलना किए गए मॉडलों में सबसे तेज़ साबित हुआ और 35 कार्यों के औसत में तीसरे स्थान पर रहा, जो एक H20 प्रोसेसर पर प्रति सेकंड लगभग 130,000 अवशेष संसाधित करता है।

HyFF बल क्षेत्र परिवार, जिसमें 83 तत्वों के साथ 2.3 मिलियन से 1.2 बिलियन तक के मापदंडों वाले पांच वेरिएंट शामिल हैं, 16 अन्य मॉडलों की तुलना में सटीकता और गति के पैरेटो फ्रंट पर स्थित है। Tencent का दावा है कि उनका Largo मॉडल न्यूनतम ऊर्जा त्रुटि - परमाणु पर 0.364 मेवी दिखाता है, और इस कॉम्प्लेक्स ने 100 नैनोसेकंड के भीतर 60,000 परमाणुओं वाली एक्वापोरिन प्रणाली का अनुकरण किया।

गणित और क्वांटम कंप्यूटिंग में उपलब्धियां

गणित के क्षेत्र में HyProver घटक ने दो परिणाम हासिल किए। इसने पांच-आयामी अंतरिक्ष में समबाहु समुच्चयों पर पेटी की परिकल्पना को हल किया, जिससे अधिकतम हल किया गया आयाम चार से बढ़ गया। वृत्त की क्रिया पर याउ की परिकल्पना के संबंध में, GitHub विवरण में असीमित रूप के लिए एक प्रतिउदाहरण प्रस्तुत किया गया है - एक बंद सात-आयामी मैनिफोल्ड जो केवल जुड़ा हुआ नहीं है; जबकि केवल जुड़ा हुआ संस्करण एक खुली समस्या बनी हुई है।

क्वांटम त्रुटि सुधार के क्षेत्र में HyQEC ने कोड [[488,123,22]] खोजा, जिसे Tencent के अनुसार, qLDPC मीट्रिक पर पिछले लीडर से लगभग 48% बेहतर बनाता है।

रोबोटिक्स और चिप्स

इसके अलावा, Hyra ने एक अनुकरण रोबोटिक हाथ तंत्र डिजाइन किया, जो संदर्भ डिजाइन की तुलना में 28.6% तेज निकला। XiangShan RISC-V ओपन प्रोसेसर पर, एजेंट ने क्षेत्रफल में केवल 0.3% की वृद्धि करते हुए और दस त्रुटियों का पता लगाते हुए, SPECint2006 स्कोर को गीगाहर्ट्ज़ में 5.79% बढ़ाया। Tencent बताता है कि Hyra का अब अगली Hy श्रृंखला के मॉडल को प्रशिक्षित करने के लिए उपयोग किया जाता है।

यह ध्यान रखना महत्वपूर्ण है कि सभी प्रस्तुत परिणाम Tencent के हैं और अभी तक स्वतंत्र रूप से सत्यापित नहीं किए गए हैं।

लोकप्रिय