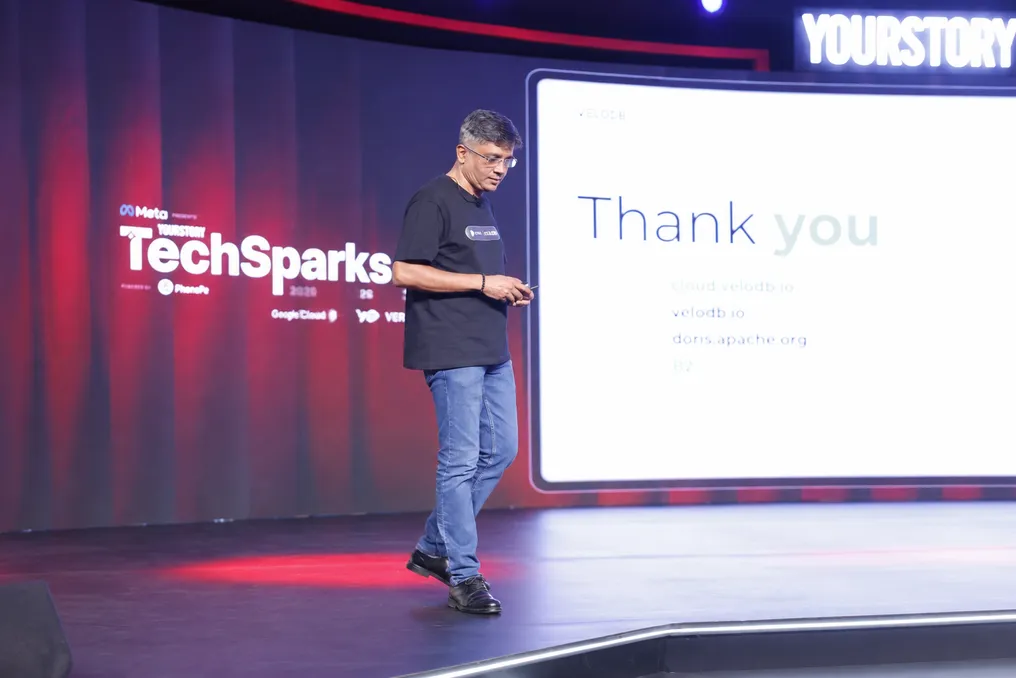
VeloDB के नितिन वागुल्डे ने डेमो चरण के बाद एआई एजेंट विफलताओं के कारणों की व्याख्या की
और पढ़ें
YourStory [india, en]
yourstory.com

VeloDB के नितिन वागुल्डे ने डेमो चरण के बाद एआई एजेंट विफलताओं के कारणों की व्याख्या की

कृत्रिम एजेंट अक्सर पायलट परीक्षण चरण में अच्छे परिणाम दिखाते हैं, क्योंकि ऐसी स्थितियों में अनुप्रयोग का क्षेत्र संकीर्ण होता है, डेटा नियंत्रित होता है और अनुरोध अनुमानित होते हैं। हालांकि, उत्पादन वातावरण अलग होता है, और यही अंतर कई परियोजनाओं को रोक देता है।

गार्टनर का अनुमान है कि 2027 के अंत तक एजेन्ट एआई परियोजनाओं में से 40% से अधिक बढ़ती लागतों, अनिश्चित व्यावसायिक मूल्य या अपर्याप्त जोखिम नियंत्रण के कारण रद्द कर दी जाएंगी। VeloDB में एशिया-प्रशांत क्षेत्र के क्षेत्रीय निदेशक नितिन वागुल्डे के अनुसार, समस्या का एक बड़ा हिस्सा मॉडल में नहीं, बल्कि डेटा के स्तर में निहित है।

'स्केल पर एआई एजेंट: प्रदर्शन के बाद जीवित रहना' नामक अपने भाषण में, नितिन ने विस्तार से बताया कि एआई एजेंट मनुष्यों की तुलना में डेटा का उपयोग कैसे करते हैं, उन्हें बड़े पैमाने पर विश्वसनीय रूप से काम करने के लिए क्या आवश्यक है, और कंपनियां इन प्रणालियों का समर्थन करने के लिए अपनी डेटा इन्फ्रास्ट्रक्चर को कैसे पुनर्गठित कर रही हैं।

नितिन ने एक उदाहरण से शुरुआत की: पारंपरिक प्रणाली में, एक प्रबंधक तैयार रिपोर्ट चलाकर पिछले वर्ष की बिक्री का डेटा प्राप्त कर सकता था। स्थिति मौलिक रूप से बदल जाती है जब आप एआई एजेंट से पिछले तीन तिमाहियों में बिक्री में गिरावट की व्याख्या करने के लिए कहते हैं। एजेंट को ईआरपी और सीआरएम सिस्टम से ऑर्डर रिकॉर्ड निकालने, प्रमुख ग्राहकों की समस्याओं के लिए सपोर्ट टिकट और चैट का विश्लेषण करने, और क्षेत्रों की गतिशीलता पर बिक्री विभाग की रिपोर्ट का अध्ययन करने के लिए मजबूर होना पड़ता है। यदि उसकी धारणा अधूरी है, तो वह अतिरिक्त जानकारी के लिए वापस जाता है।

उन्होंने टिप्पणी की: 'जो पहले एक साधारण खोज या एक साधारण अनुरोध से पूरा हो जाता था, अब उसी जानकारी को प्राप्त करने के लिए सैकड़ों खोज संचालन की आवश्यकता होती है।' पहले व्यावसायिक डेटा के मुख्य उपभोक्ता लोग और रिपोर्ट थे, और सिस्टम स्पष्ट सीमाओं वाली निश्चित रिपोर्टों के आसपास बनाए गए थे।

अब, नितिन के अनुसार, एआई इन डेटा का नया ग्राहक बन गया है, और यह पूरी तरह से अलग तरीके से व्यवहार करता है। एजेंट चौबीसों घंटे काम करते हैं, एक साथ कई प्रश्न पूछते हैं और एक पुनरावृत्तीय चक्र में कार्य करते हैं: पूछना, सोचना, खोजना और उत्तर प्राप्त होने तक प्रयास दोहराना। उनके प्रश्न भी पहले से लिखे हुए नहीं होते हैं, जो डेटा परत पर एक मजबूत और अप्रत्याशित भार पैदा करता है।

जटिलता इस तथ्य से बढ़ जाती है कि व्यावसायिक डेटा कई स्थानों पर वितरित होता है: लेनदेन रिकॉर्ड, चैट मेमोरी, दस्तावेज़, डैशबोर्ड और अर्थपूर्ण खोज के लिए वेक्टर स्टोर। एजेंट को जवाब देने से पहले इन सभी स्रोतों में खोजना और परिणामों को संयोजित करना पड़ता है।

डेटा के प्रत्येक अतिरिक्त अनुरोध से लागत बढ़ती है। यदि डेटा पुराना है, तो उत्तर गलत होगा। नितिन ने इसकी तुलना गलत ट्रैफिक मानचित्र पर गाड़ी चलाने से की। इसके अलावा, जब डेटा कई स्रोतों से आता है, तो उत्तर के स्रोत की पहचान करना कठिन हो जाता है, जिससे विश्वास की समस्या उत्पन्न होती है।

उन्होंने इस स्थिति की तुलना किसी व्यक्ति को कागजात इकट्ठा करने के लिए पांच कार्ड कैटलॉग अलमारियों में भेजने से की। जब तक व्यक्ति पांचवीं अलमारी से लौटता है, पहली अलमारी से जानकारी पुरानी हो सकती है।

नितिन ने चार आवश्यकताओं को रेखांकित किया जिन्हें एजेंटों को पायलट मोड से पूर्ण संचालन में जाने के लिए पूरा करना चाहिए। VeloDB का उत्तर एक एकीकृत इंजन है जो इन सभी आवश्यकताओं को पूरा करता है। कंपनी की स्थापना 2023 में मूल Apache Doris डेवलपर्स द्वारा की गई थी, जो ओपन-सोर्स रियल-टाइम एनालिटिक्स डेटाबेस है, जो जून 2022 में Apache सॉफ्टवेयर फाउंडेशन की शीर्ष-स्तरीय परियोजना बन गया। VeloDB के आंकड़ों के अनुसार, Apache Doris को GitHub पर 14,000 से अधिक स्टार और 700 योगदानकर्ता प्राप्त हैं, और इसका उपयोग दुनिया भर में 5,000 से अधिक उद्यम करते हैं।

एजेंटों के काम को धीमा करने वाले वापस आने वाले अनुरोधों की संख्या को कम करने के लिए, VeloDB हाइब्रिड क्वेरी का समर्थन करता है। एक क्वेरी SQL, वेक्टर खोज और टेक्स्ट खोज को मिलाकर निर्धारित और संभाव्य खोजों को समानांतर में निष्पादित कर सकती है। परिणाम बिखरे हुए डेटा के बजाय एक एकल विश्वसनीय स्रोत होता है।

नितिन ने दो कंपनियों के उदाहरण प्रस्तुत किए जो इस आर्किटेक्चर का उपयोग अपने काम में करती हैं। पहला - 120 मिलियन से अधिक उपयोगकर्ताओं वाला एक प्रमुख क्रिप्टोकरेंसी एक्सचेंज, जिसका उन्होंने नाम नहीं लिया। एक्सचेंज एआई एजेंटों को लेनदेन डेटा प्रदान करता है, जिन्हें खुदरा निवेशक किसी विशेष संपत्ति पर बड़े व्यापारियों की स्थिति देखने के लिए अनुरोध कर सकते हैं। उन्होंने बताया कि उसके एजेंट चौबीसों घंटे काम करते हुए लगभग 3 मिलीसेकंड की अंतिम विलंबता के साथ लगभग 33,000 संवाद संसाधित करते हैं।

दूसरा उदाहरण - चीनी एआई कंपनी MiniMax है, जो जनवरी 2026 में हांगकांग स्टॉक एक्सचेंज में सूचीबद्ध हुई और 200 से अधिक देशों में 212 मिलियन उपयोगकर्ताओं को सेवा प्रदान करती है। MiniMax ने Grafana Loki को छोड़ने के बाद अपना लॉगिंग सिस्टम Apache Doris पर पुनर्निर्माण किया, क्योंकि लॉग सूचना का एक मूल्यवान स्रोत बन गए थे जिसे सहेजना और अनुरोध करना उचित था।

नितिन ने स्पष्ट किया कि MiniMax 10 जीबीपीएस की गति से डेटा लोड करती है और दो सेकंड से भी कम समय में लगभग 10 पेटाबाइट तक क्वेरी कर सकती है, साथ ही लागत में 70% की कमी लाती है। VeloDB ने विशेष रूप से बताया कि डोरिस पर आधारित सिस्टम अब पेटाबाइट पैमाने पर MiniMax के सभी व्यावसायिक क्षेत्रों में लॉग का समर्थन करता है जिसमें 99.9% से अधिक की उपलब्धता है।

नितिन ने जोड़ा कि ये समस्याएं शुरुआती चरण के स्टार्टअप्स के लिए भी प्रासंगिक हैं जो एजेंट बना रहे हैं। VeloDB फिनटेक स्टार्टअप्स के साथ सहयोग करता है जो MiniMax या क्रिप्टो एक्सचेंज जैसी ही स्केलिंग समस्याओं का सामना कर रहे हैं, बस एक शुरुआती चरण में।

उनका अंतिम तर्क यह था कि एजेंट हमेशा सैकड़ों प्रश्न पूछेंगे, इसलिए बुनियादी ढांचे को यह सुनिश्चित करना चाहिए कि उनमें से प्रत्येक सस्ता, तेज़ और वर्तमान हो। नितिन के लिए, एआई एजेंटों का स्केलिंग बेहतर मॉडल खोजने पर कम और एक ही स्रोत से एजेंटों को विश्वसनीय वास्तविक समय डेटा प्रदान करने पर अधिक निर्भर करता है। उनका तर्क था कि जो कंपनियां डेटा स्तर को सही ढंग से कॉन्फ़िगर करेंगी, वे तेजी से निर्णय ले पाएंगी, लागत कम कर पाएंगी और आत्मविश्वास के साथ अपने एजेंटों को पायलट मोड से परिचालन में स्थानांतरित कर पाएंगी।

समान कहानियाँ

एआई खर्च और डेटा सेंटर विस्तार की चिंताओं के कारण नैस्डैक इंडेक्स में गिरावट
और पढ़ें
techcentral.co.za

एआई खर्च और डेटा सेंटर विस्तार की चिंताओं के कारण नैस्डैक इंडेक्स में गिरावट

गुरुवार को अपने रिकॉर्ड क्लोजिंग के बाद नैस्डैक इंडेक्स में उल्लेखनीय गिरावट आई, जिसमें 10% से अधिक की हानि हुई। यह गति कृत्रिम बुद्धिमत्ता पर बड़े पैमाने पर खर्च और डेटा सेंटर विस्तार पर बढ़ते नियंत्रण के बारे में चिंता के कारण संभावित सुधार की शुरुआत का संकेत देती है।

नैस्डैक का समग्र सूचकांक, जो प्रौद्योगिकी क्षेत्र पर बहुत अधिक निर्भर करता है, न्यूयॉर्क में दिन के कारोबार के दौरान लगभग 4% गिर गया। यह गिरावट 6 अक्टूबर को प्राप्त रिकॉर्ड उच्च क्लोजिंग से 10% से अधिक थी।

गुरुवार की गिरावट ने पिछली दैनिक बढ़त को मिटा दिया, क्योंकि डेमोक्रेट्स ने कांग्रेस दोनों सदनों में जीत हासिल की। निवेशकों ने एआई के लिए बुनियादी ढांचे के आगे के निर्माण पर अधिक बारीकी से ध्यान देने की क्षमता का मूल्यांकन करना शुरू कर दिया।

वेल्स फार्गो इन्वेस्टमेंट इंस्टीट्यूट में वरिष्ठ वैश्विक बाजार रणनीतिकार समीर समाना ने टिप्पणी की कि एक पार्टी के पूर्ण एकीकृत नियंत्रण से दूसरी पार्टी के पूर्ण एकीकृत नियंत्रण में बदलाव महत्वपूर्ण अनिश्चितता, विभाजन और नीति में तेज बदलाव ला सकता है।

उन्होंने आगे कहा कि जब ऐसा लग रहा था कि डेमोक्रेट्स प्रतिनिधि सभा और सीनेट दोनों में महत्वपूर्ण बहुमत प्राप्त करेंगे, तो विश्लेषकों ने अनुमान लगाया था कि इससे बाजारों में कम से कम अस्थायी विराम आएगा।

पिछले रिकॉर्ड उच्च से 10% की गिरावट को व्यापक रूप से एक सुधार के रूप में देखा जाता है, और यह इस वर्ष नैस्डैक का दूसरा सुधार होगा। पिछले कुछ हफ्तों में एआई से संबंधित शेयरों के प्रति भावनाएं खराब हुई हैं, और नैस्डैक ने अक्टूबर में 2.5 ट्रिलियन डॉलर से अधिक का बाजार पूंजीकरण खो दिया है।

कई बड़ी प्रौद्योगिकी कंपनियां एआई के विकास के लिए आवश्यक डेटा सेंटर, चिप्स और अन्य बुनियादी ढांचे के लिए बहु-अरब डॉलर के निवेश को वित्तपोषित करने के लिए ऋण बाजारों को आकर्षित कर रही हैं।

निवेशक तेजी से इस बात पर सवाल उठा रहे हैं कि ये निवेश लाभ में कितनी जल्दी बदलेंगे, खासकर मध्य पूर्व में चल रहे भू-राजनीतिक तनाव और लंबे समय तक चलने वाली मुद्रास्फीति की चिंताओं के मद्देनजर, जो उच्च उधार दरों को बनाए रखती हैं।

पिछले महीने अल्फाबेट और मेटा द्वारा प्रकाशित रिपोर्टों ने, जो दुनिया के सबसे बड़े डेटा सेंटर बनाने और संचालित करने वाले दो प्रमुख हाइपरस्केलर हैं, एआई खर्च से रिटर्न के बारे में निवेशकों को आश्वस्त नहीं कर पाईं, जिससे एआई से जुड़े परिसंपत्तियों की सामान्य बिकवाली को बढ़ावा मिला।

आर्टिफिशियल इंटेलिजेंस की मुख्य समस्या मॉडल में नहीं, बल्कि डेटा इंफ्रास्ट्रक्चर में निहित है
और पढ़ें
yourstory.com

आर्टिफिशियल इंटेलिजेंस की मुख्य समस्या मॉडल में नहीं, बल्कि डेटा इंफ्रास्ट्रक्चर में निहित है

आर्टिफिशियल इंटेलिजेंस मॉडलों की बढ़ती उपलब्धता के बावजूद, उन्हें विश्वसनीय वाणिज्यिक उत्पादों में बदलना एक जटिल कार्य बना हुआ है, खासकर जब उद्यम बिखरे हुए डेटा इंफ्रास्ट्रक्चर का सामना करते हैं।

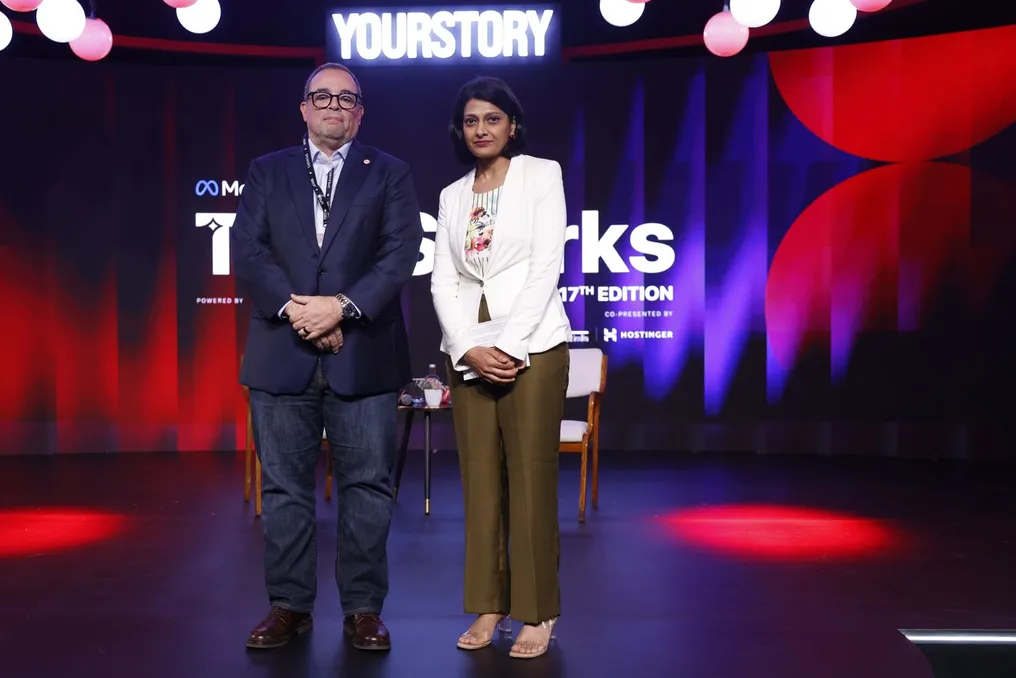
TechSparks 2026 कार्यक्रम में, Couchbase के एशिया-प्रशांत क्षेत्र, जापान और भारत के बिक्री उपाध्यक्ष माइकल क्रोनिन ने YourStory के वरिष्ठ निदेशक रणनीतिक सामग्री और वीडियो शिवानी मुत्तन्ना के साथ चर्चा में भाग लिया। उन्होंने प्रयोगों से पूर्ण उत्पादन तक AI के संक्रमण, प्रबंधन की समस्याओं, ग्राहक अनुभव और AI नवाचारों में भारत की बढ़ती भूमिका पर चर्चा की।

दशकों से, बड़ी कंपनियों ने विशिष्ट कार्यों को हल करने के लिए विभिन्न डेटाबेस और अत्यधिक विशिष्ट समाधान लागू किए हैं। हालांकि प्रत्येक ने एक तत्काल समस्या का समाधान किया, परिणाम अक्सर डेटा का एक खंडित स्तर होता है, जो कई प्रणालियों से बना होता है जो एक दूसरे के साथ खराब तरीके से इंटरैक्ट करती हैं।

क्रोनिन इस विखंडन को AI को अपनाने में एक गंभीर बाधा मानते हैं। वह उद्योग अनुमानों का हवाला देते हैं कि AI विकास परियोजनाओं में से 70-80% कभी भी उत्पादन चरण तक नहीं पहुंचती हैं, और एमआईटी के एक अध्ययन से पता चला है कि ऐसी 95% परियोजनाएं लाभदायक नहीं बनती हैं।

Couchbase का परिचालन डेटा प्लेटफॉर्म इस समस्या को दूर करने के लिए डिज़ाइन किया गया है, जो कंपनियों को अपने डेटा इंफ्रास्ट्रक्चर को समेकित करने में मदद करता है। सब कुछ एक बार में ठीक करने की कोशिश करने के बजाय, क्रोनिन ने कंपनियों को छोटी शुरुआत करने की सलाह दी, और डेटा स्तर के विखंडन से जूझ रहे संस्थापकों और उद्यमों को सबसे महत्वपूर्ण उपयोग के मामलों को पहले चुनने की सलाह दी।

उन्होंने यूनाइटेड किंगडम के खुदरा विक्रेता Tesco का उदाहरण दिया, जिसका बेंगलुरु में एक बड़ा वैश्विक компетенस सेंटर (GCC) है। इस खुदरा विक्रेता की कई प्रणालियाँ ग्राहक अनुभव पर नकारात्मक प्रभाव डाल रही थीं, खासकर ब्लैक फ्राइडे और सप्ताहांत जैसे व्यस्त खरीदारी अवधियों के दौरान। Tesco ने एक इंस्टेंस और एक उपयोग के मामले से शुरुआत करके अपने डेटा स्तर को समेकित करना शुरू किया, इससे पहले कि वह अपने पूरे तकनीकी स्टैक पर प्रयास फैलाए। इस समेकन ने खुदरा विक्रेता को मिलीसेकंड से कम विलंबता के साथ प्रति सेकंड लाखों लेनदेन को संसाधित करने में सक्षम बनाया। क्रोनिन के अनुसार, यह उदाहरण दर्शाता है कि कंपनियां अपने पूरे संचालन पर बदलाव फैलाने से पहले एक उपयोग के मामले के माध्यम से विखंडन की समस्या का समाधान कैसे शुरू कर सकती हैं।

AI उत्पादों के विकास का दबाव कई उद्यमों को मॉडल और अनुप्रयोगों पर प्राथमिकता देने के लिए प्रेरित करता है। हालांकि, पायलट प्रोजेक्ट अक्सर नियंत्रित वातावरण में छोटे डेटासेट पर किए जाते हैं, जो संगठनों को वास्तविक उत्पादन की मांगों के लिए तैयार नहीं करता है। क्रोनिन ने मशीन ट्रैफिक के बढ़ते पैमाने पर ध्यान दिलाया। उन्होंने कहा: 'आठारह महीनों में मशीन ट्रैफिक ने इंटरनेट पर मानव ट्रैफिक को पीछे छोड़ दिया। यह AI का पैमाना है। यह मशीन गति का पैमाना है जिस पर उद्यमों को काम करना चाहिए।'

जब AI एप्लिकेशन वास्तविक दुनिया के वर्कलोड का सामना करते हैं, तो खंडित डेटा सिस्टम उन्हें बड़े पैमाने पर विश्वसनीय रूप से कार्य करने से रोक सकते हैं। AI एजेंटों के बढ़ते उपयोग से यह समस्या और बढ़ जाती है। चूंकि एजेंट अधिक स्वायत्त होते जा रहे हैं और निर्णय लेने के कार्यों को संभाल रहे हैं, इसलिए उद्यमों को यह सुनिश्चित करना होगा कि वे उचित शासन संरचनाओं के भीतर आवश्यक डेटा तक पहुंच सकते हैं।

खंडित सिस्टम संचार और प्रबंधन को बाधित कर सकते हैं, जिससे एजेंटों की स्वायत्त रूप से कार्य करने की क्षमता सीमित हो जाती है। क्रोनिन ने उद्यमों से AI में निवेश वितरण के दृष्टिकोण पर पुनर्विचार करने का भी आग्रह किया। हालांकि मॉडल तेजी से विकसित हो रहे हैं, कॉर्पोरेट डेटा एक महत्वपूर्ण संपत्ति बना हुआ है। उन्होंने जोर देकर कहा: 'मॉडल किराए पर लिए जा सकते हैं। आज का सर्वश्रेष्ठ मॉडल कल का अखबार है। उद्यम के लिए वास्तविक संपत्ति डेटा है।'

जैसे ही उद्यमों ने महसूस करना शुरू किया कि खंडित डेटा उनकी AI पहलों को धीमा कर रहा है, उनमें से कई ने मौजूदा सिस्टम को जोड़ने के लिए एपीआई और कनेक्टर्स जोड़कर प्रतिक्रिया दी। हालांकि, क्रोनिन ने चेतावनी दी कि ऐसा तरीका मुख्य समस्या को हल करने के बजाय अतिरिक्त जटिलता पैदा कर सकता है। प्रत्येक अतिरिक्त कनेक्शन विलंबता, जोखिम बढ़ाता है और एक और संभावित विफलता बिंदु बनाता है।

इसके बजाय, उन्होंने डेटा स्तर को समेकित करने की सिफारिश की ताकि AI एप्लिकेशन और एजेंट उससे अधिक सीधे इंटरैक्ट कर सकें, डेटा को ग्राहकों के करीब ला सकें। क्रोनिन के अनुसार, भारत में बड़े GCC सहित कई उद्यम अब डेटा विखंडन को दूर करने के लिए अपनी वास्तुकला की समीक्षा कर रहे हैं। इन परिवर्तनों के बिना, AI विकास में आगे का निवेश उन्हीं समस्याओं को जन्म दे सकता है।

डेटा समेकन ग्राहक अनुभव को भी बेहतर बना सकता है, जिससे सिस्टम बढ़ती मांग को संभालने, सुलभ बने रहने और तेजी से प्रतिक्रिया करने में मदद मिलती है। चूंकि ग्राहक AI-आधारित सेवाओं से अधिक की उम्मीद करते हैं, इसलिए परिधि पर डेटा की उपस्थिति अधिक महत्वपूर्ण होती जा रही है।

क्रोनिन ने उल्लेख किया कि एशिया-प्रशांत क्षेत्र में व्यावसायिक संस्कृतियां भिन्न होती हैं, लेकिन डेटा इंफ्रास्ट्रक्चर का विखंडन AI को अपनाने के लिए एक सामान्य समस्या बनी हुई है। साथ ही, भारत AI नवाचार और निर्णय लेने का एक महत्वपूर्ण केंद्र बन रहा है। उन्होंने उल्लेख किया कि Couchbase के शीर्ष 50 वैश्विक ग्राहकों में से 80% का भारत में महत्वपूर्ण उपस्थिति है, और उनके अधिकांश AI नवाचार और नेतृत्व इस देश में आधारित हैं। Couchbase भी भारत में अपनी उपस्थिति का विस्तार कर रहा है, अपने एशिया-प्रशांत मुख्यालय को बेंगलुरु स्थानांतरित कर रहा है। भारत में Couchbase के कॉर्पोरेट ग्राहकों में एयर इंडिया, एयरटेल, बिगबास्केट और महिंद्रा फाइनेंस शामिल हैं। क्रोनिन के अनुसार, वैश्विक व्यवसाय में भारत की भूमिका लागत बचत से परे चली गई है; यहां नवाचार, नेतृत्व और महत्वपूर्ण व्यावसायिक निर्णय अधिक बार हो रहे हैं। उन्होंने एयर इंडिया के अगली पीढ़ी के मनोरंजन प्लेटफॉर्म का उल्लेख किया, जो Couchbase पर बनाया जा रहा है। इस प्लेटफॉर्म का उद्देश्य विमान में नेटवर्क कनेक्टिविटी की अनुपस्थिति में भी यात्रियों को व्यक्तिगत खरीदारी और मनोरंजन अनुभव प्रदान करना है। क्रोनिन के लिए, यह परियोजना दर्शाती है कि भारतीय उद्यम वास्तविक परिचालन स्थितियों में ग्राहक अनुभव को बेहतर बनाने के लिए प्रौद्योगिकी का उपयोग कैसे करते हैं।

Forge Code के विशेषज्ञ ने समझाया कि प्रभावी सॉफ्टवेयर विकास के लिए AI-आधारित 'सॉफ्टवेयर फैक्ट्री' क्यों आवश्यक है
और पढ़ें
yourstory.com

Forge Code के विशेषज्ञ ने समझाया कि प्रभावी सॉफ्टवेयर विकास के लिए AI-आधारित 'सॉफ्टवेयर फैक्ट्री' क्यों आवश्यक है

भले ही आर्टिफिशियल इंटेलिजेंस अभूतपूर्व गति से कोड उत्पन्न करने में सक्षम हो, लेकिन इसके परीक्षण, सत्यापन और उत्पादन वातावरण में तैनाती की प्रक्रिया एक अलग जटिल कार्य प्रस्तुत करती है। इंजीनियरिंग टीमें कोड लिखने, त्रुटियों को ठीक करने और नई सुविधाएँ बनाने के लिए तेजी से AI एजेंटों का उपयोग कर रही हैं, हालांकि कोडिंग में तेजी सॉफ्टवेयर वितरण में तेजी की गारंटी नहीं देती है।

जैसे-जैसे कोड जनरेशन गति पकड़ रहा है, जांचों की संख्या बढ़ रही है, परीक्षण धीमा हो रहा है, और टीमों के लिए परिवर्तनों की बढ़ती मात्रा का समन्वय करना मुश्किल होता जा रहा है।

TechSparks 2026 सम्मेलन में, Forge Code के सीईओ तुषार मातुर ने अपने सत्र 'सॉफ्टवेयर फैक्ट्री की शारीरिक रचना' में इस समस्या पर प्रकाश डाला। उन्होंने समझाया कि AI-उन्मुख इंजीनियरिंग संगठन व्यक्तिगत कोडिंग कार्यों के स्वचालन से परे जाकर सॉफ्टवेयर डेवलपमेंट लाइफसाइकिल (SDLC) के पूरे जीवन चक्र को प्रबंधित करने वाली प्रणालियाँ कैसे बना सकते हैं।

मातुर ने उल्लेख किया कि केवल इसलिए कि कोड जनरेशन आसान और तेज हो गया है, इसका मतलब यह नहीं है कि समग्र SDLC तेज हो जाएगा। उन्होंने याद दिलाया कि पारंपरिक विकास दृष्टिकोण प्रभावी ढंग से कोड लिखने पर केंद्रित था, जिसके लिए टीमों को कार्यान्वयन चरण पर बोझ कम करने के लिए आवश्यकताओं को परिभाषित करने, विनिर्देश तैयार करने और वास्तुकला डिजाइन करने की आवश्यकता होती थी।

हालांकि, चूंकि AI कोडिंग का अधिकांश काम संभाल रहा है, इसलिए बाधाएं अन्य क्षेत्रों में स्थानांतरित हो जाती हैं। मातुर ने उस स्थिति का वर्णन किया जब संगठनों को समीक्षा की प्रतीक्षा कर रहे मर्ज अनुरोधों (पुल रिक्वेस्ट) की भारी मात्रा, लंबे परीक्षण चक्र और मौजूदा रिग्रेशन सेट द्वारा पता लगाए जा सकने वाले त्रुटियों की तुलना में अधिक त्रुटियों का सामना करना पड़ता है।

उन्होंने जोर दिया कि समस्या का समाधान जरूरी नहीं कि अधिक इंजीनियरों को नियुक्त करने या अधिक AI एजेंटों को चलाने में निहित हो। अतिरिक्त कर्मचारी समन्वय लागत बढ़ा सकते हैं, और प्रभावी फीडबैक तंत्र के बिना एजेंटों को जोड़ने से ऐसा कोड बन सकता है जो सत्यापन और परीक्षण प्रणालियों पर अत्यधिक भार डालता है।

मातुर ने समझाया, 'इसका कारण यह है कि कोई संकेत मौजूद नहीं है,' यह समझाते हुए कि स्वचालित चरणों को बस जोड़ने से एक प्रभावी सॉफ्टवेयर फैक्ट्री क्यों नहीं बनती है।

मातुर ने Forge Code को एक सॉफ्टवेयर फैक्ट्री के रूप में प्रस्तुत किया जो पूरे विकास चक्र के दौरान AI एजेंटों का समन्वय करता है। प्रक्रिया अनुरोधों को छांटने, विनिर्देश बनाने और सुविधाओं को लागू करने से शुरू होती है। फिर एजेंटों द्वारा तैनाती से पहले परिवर्तनों की जाँच की जाती है, जिसमें मानव इंजीनियर तब हस्तक्षेप करते हैं जब समाधान या प्रतिक्रिया की आवश्यकता होती है।

यह प्रणाली कार्य वातावरण में निगरानी भी करती है, प्राप्त डेटा का उपयोग भविष्य के कार्यों को सूचित करने के लिए करती है। यह एक फीडबैक लूप बनाता है, जिससे फैक्ट्री समस्याओं की पहचान कर सकती है, अपनी कार्यप्रणाली में सुधार कर सकती है और प्राप्त अनुभव के आधार पर नया काम उत्पन्न कर सकती है। प्रस्तुति के दौरान, मातुर ने बताया कि Forge Code ने सुविधाओं, संगतता और त्रुटि का पता लगाने पर काम करने के लिए पृष्ठभूमि में लगभग 100 एजेंटों का उपयोग किया था।

उन्होंने एक प्रभावी सॉफ्टवेयर फैक्ट्री बनाने के लिए छह सिद्धांतों की रूपरेखा प्रस्तुत की: स्वायत्तता, मापनीयता, आर्थिक दक्षता, मापनीयता, स्व-सुधार और व्यावसायिक लक्ष्यों के साथ संरेखण। अंतिम सिद्धांत विशेष महत्व रखता है।

फैक्ट्री को प्रत्येक अनुरोध के लिए कोड लिखने के कार्य के रूप में काम नहीं करना चाहिए, बल्कि ग्राहक प्रतिधारण बढ़ाने या नियामक अनुपालन सुनिश्चित करने जैसे विशिष्ट परिणामों को प्राप्त करने पर केंद्रित होना चाहिए। फिर टीमें मूल्य के आधार पर सुविधाओं को प्राथमिकता दे सकती हैं। इस मॉडल में, इंजीनियर प्रत्येक कार्य के प्रबंधन में कम समय बिताते हैं और परिणामों की निगरानी करने, संकेतों का विश्लेषण करने और स्वयं प्रणाली में सुधार करने में अधिक समय बिताते हैं। व्यवसाय के नेता भी सीधे अनुरोध और प्राथमिकताएं प्रदान कर सकते हैं, जिससे फैक्ट्री संगठनात्मक लक्ष्यों को विकास बैकलॉग में बदल सकती है।

कोड लिखने की गति अच्छी है, लेकिन बेहतर सॉफ्टवेयर बनाना ही वास्तविक जीत है। इंजीनियरिंग टीमों के लिए कुंजी AI द्वारा प्रदान की गई गति को विश्वसनीय उत्पादों, मापने योग्य प्रगति और वास्तविक व्यावसायिक परिणामों में बदलना है।

लोकप्रिय