हुआवेई एस्केंड ने एटलस A3 और एस्केंड 950 सुपरपोड्स के लिए किमी K3.1 प्रो का समर्थन जोड़ा
और पढ़ें
Pandaily
pandaily.com

हुआवेई एस्केंड ने एटलस A3 और एस्केंड 950 सुपरपोड्स के लिए किमी K3.1 प्रो का समर्थन जोड़ा

हुआवेई एस्केंड की कंप्यूटिंग सिस्टम टीम ने 2.8 ट्रिलियन पैरामीटर वाले Kimi K3.1 Pro मॉडल के इन्फेरेंस के लिए अनुकूलन पूरा करने की घोषणा की। IT Home और ifeng Tech द्वारा रिपोर्ट किए जाने के अनुसार, Moonshot AI ने 4 नवंबर को इस मॉडल के पूर्ण वज़न जारी किए थे, जैसा कि हुआवेई कंप्यूटिंग के आधिकारिक खाते पर बताया गया था।

vLLM Ascend और SGLang का उपयोग करते हुए, डेवलपर्स अब इसे Atlas 800 A3 सर्वर, Atlas 900 A3 SuperPoD क्लस्टर और इसके लॉन्च के बाद से Ascend 950 SuperPoD श्रृंखला पर तैनात कर सकते हैं।

Kimi K3.1 Pro Moonshot AI की K3.1 श्रृंखला का पहला मॉडल है। यह एक मिश्रण-ऑफ-एक्सपर्ट्स प्रकार का मॉडल है जिसमें नेटिव विज़ुअल प्रोसेसिंग और लगभग दस लाख टोकन की संदर्भ विंडो है, जो इन्फेरेंस के प्रत्येक चरण में लगभग 104 बिलियन पैरामीटर सक्रिय करता है। मॉडल K3 पर आधारित हाइब्रिड लीनियर अटेंशन को बनाए रखता है, जो Kimi Delta Attention (KDA) लेयर्स पर आधारित है, और लंबी संदर्भ मॉडलिंग की लागत को कम करने के लिए कुछ फुल अटेंशन लेयर्स के स्थान पर DSA स्पार्स अटेंशन लेयर्स जोड़ता है।

अनुकूलन का अधिकांश काम विशेष रूप से इस आर्किटेक्चर से संबंधित था। हुआवेई ने कहा कि उसकी इन्फेरेंस टीम ने पिछली Kimi K3 अनुकूलन पर भरोसा किया, नए मॉडल का पूर्व विश्लेषण किया और समानांतर में मॉडल एकीकरण, ऑपरेटर विकास और सेवा सत्यापन पर काम किया। KDA और MoE के पहले से मौजूद समर्थन के कारण, टीम ने मौजूदा इन्फेरेंस फ्रेमवर्क में सेवा कार्यों को बनाए रखते हुए एक नया स्पार्स अटेंशन पाथ और मल्टीमॉडल इन्फेरेंस जोड़ा।

हुआवेई से मिली जानकारी के अनुसार, अनुकूलन में ऐतिहासिक जानकारी चयन, स्पार्स अटेंशन गणना, प्रीप्रोसेसिंग और अवशेष गणना के लिए मुख्य ऑपरेटरों को शामिल किया गया था, जिसे लंबे संदर्भ इन्फेरेंस और उत्पादन रखरखाव का समर्थन करने के लिए वितरित कैशिंग और फ्रेमवर्क स्तर के कार्यों के साथ जोड़ा गया था। कंपनी का लक्ष्य यह निर्धारित करना था कि उपयोगकर्ता और डेवलपर मॉडल के रिलीज के पहले दिन से ही एप्लिकेशन परीक्षण और परिनियोजन शुरू कर सकें।

vLLM Ascend दस्तावेज़ीकरण इंगित करता है कि Kimi K3.1 Pro को vLLM Ascend 0.30.0 संस्करण में प्रायोगिक मोड में समर्थित किया जाता है। इसकी संदर्भ संरचना आठ नोड्स पर प्रीफाइल और डिकोडिंग विभाजन का उपयोग करती है, जिसमें चार प्रीफाइल नोड्स और चार डिकोडिंग नोड्स शामिल हैं, जिसमें एक मिलियन टोकन की लंबी संदर्भ कॉन्फ़िगरेशन भी शामिल है। Atlas 800I A3 सर्वर W4A8 क्वांटाइज्ड चेकपॉइंट के साथ काम करते हैं, जबकि 950DT उत्पाद W4A8 MXFP संस्करण का उपयोग करते हैं; दिशानिर्देश बताते हैं कि Atlas A2 और 950PR उत्पाद अभी तक समर्थित नहीं हैं।

मॉडल का आकार हार्डवेयर समर्थन को एक व्यावहारिक प्रश्न बनाता है। IT Home बताता है कि BF16 प्रारूप में वज़न लगभग 5.6 TB लेते हैं और INT4 क्वांटाइजेशन पर अभी भी लगभग 1.4 TB की आवश्यकता होती है, जो एक उपभोक्ता जीपीयू का उपयोग करने को असंभव बना देता है। हुआवेई ने अपनी A3 और 950 SuperPoD प्रणालियों को इस ट्रिलियन-पैरामीटर MoE इन्फेरेंस वर्ग के लिए तैनात किया है, और Kimi K3.1 Pro का रिलीज उस दिन समर्थित अंतिम ओपन मॉडल था।
समान कहानियाँ

होंगयून ने Huawei Ascend 950DT और Atlas 850E SuperPoD के समर्थन के साथ HyperLM V2.5 जारी किया
और पढ़ें
pandaily.com

होंगयून ने Huawei Ascend 950DT और Atlas 850E SuperPoD के समर्थन के साथ HyperLM V2.5 जारी किया

बीजिंग स्थित एआई कंपनी होंगयून ने बड़े मॉडल के संयुक्त प्रशिक्षण और अनुमान के लिए अपने प्लेटफॉर्म का नया संस्करण HyperLM V2.5 पेश किया। यह जानकारी आईटी होम और इफेंग टेक द्वारा 3 नवंबर को दी गई। कंपनी का दावा है कि यह पहली कंपनी है जिसने Huawei Ascend 950DT चिप के साथ गहन अनुकूलन किया है, जो एयर-कूल्ड Atlas 850E SuperPoD सिस्टम के साथ पूरी तरह से संगत है और Ascend Native के लिए Huawei द्वारा तकनीकी प्रमाणन प्राप्त कर चुका है।

होंगयून का मानना है कि जब किसी मॉडल को केवल टोकन स्थापित करने और उत्पन्न करने के बाद समर्थित माना जाता है तो समर्थन की परिभाषा अक्सर बहुत अस्पष्ट होती है। कंपनी का लक्ष्य सरकारी और कॉर्पोरेट ग्राहकों की मदद करना है जो निजी परिनियोजन का उपयोग करते हैं, ताकि वे नए एक्सेलेरेटर से अधिकतम प्रदर्शन प्राप्त कर सकें।

कंपनी Ascend 950DT को उच्च थ्रूपुट वाले कार्यों के लिए एक फ्लैगशिप चिप के रूप में वर्णित करती है, जैसे कि चैट में लंबी बातचीत, लंबे दस्तावेज़ों का प्रसंस्करण और एजेंटों का निरंतर तर्क। इसके अलावा, यह उल्लेख किया गया है कि एयर-कूल्ड Atlas 850E सिस्टम को बुनियादी ढांचे के आधुनिकीकरण की आवश्यकता के बिना मौजूदा डेटा केंद्रों में एकीकृत किया जा सकता है।

HyperLM V2.5 कई स्तरों पर अनुकूलित होता है। इंटरकनेक्ट स्तर पर, प्लेटफॉर्म Huawei की UnifiedBus 2.0 तकनीक का समर्थन करता है, जो सिस्टम इंटरकनेक्ट थ्रूपुट को 13.4 TB/s तक प्रदान करता है, जिससे कार्डों के बीच ट्रैफ़िक हस्तांतरण में बाधाएं नहीं आती हैं, जो लंबे संदर्भ या प्रीफिलिंग और डिकोडिंग चरणों के विभाजन के लिए महत्वपूर्ण है। ऑपरेटर स्तर पर, सिस्टम mxFP4 अनुमान के लिए अनुकूलित है, जिससे एक नोड पर 14.2 PFLOPS का उपयोग किया जा सकता है।

प्लेटफॉर्म Qwen, GLM और DeepSeek सहित नवीनतम ओपन-सोर्स मॉडल का समर्थन करता है, और इसके शेड्यूलर को 950DT के मेमोरी प्रोफाइल और थ्रूपुट को ध्यान में रखते हुए फिर से बनाया गया है।

HyperLM V2.5 के लॉन्च में पांच नई क्षमताएं शामिल हैं। प्रीफिलिंग और डिकोडिंग का पृथक्करण दो चरणों को स्वतंत्र संसाधन पूल में अलग करने की अनुमति देता है ताकि वे चरम भार के दौरान प्रतिस्पर्धा न करें। मल्टी-लेवल KV कैशिंग दोहराए जाने वाले सिस्टम प्रॉम्प्ट्स, अक्सर आने वाले संदर्भों और निश्चित सत्र टेम्पलेट्स का पुन: उपयोग करती है ताकि दोहराए जाने वाले गणनाओं की मात्रा कम हो सके। vNPU वर्चुअलाइजेशन Ascend 950DT, 910C और 910B चिप्स को सेगमेंट करता है, AI कोर और HBM मेमोरी के लिए दानेदार कोटा और अलगाव प्रदान करता है, और हार्डवेयर विफलता पर हॉट माइग्रेशन और स्वचालित पुन: शेड्यूलिंग का समर्थन करता है।

एक एकीकृत गेटवे मॉडल भी जोड़ा गया है, जो OpenAI प्रोटोकॉल के साथ संगत है, जो रूटिंग, दर सीमितता, बीटा रिलीज़ और A/B परीक्षण का प्रबंधन करता है। पूरे स्टैक की व्यापक निगरानी लोड, मेमोरी उपयोग, थ्रूपुट, विलंबता और QPS को ट्रैक करती है, अलर्ट और स्वचालित दोष स्थानीयकरण प्रदान करती है।

सरकारी प्रशासन, ऊर्जा, परिवहन और वित्त जैसे विनियमित उद्योगों के लिए, प्लेटफॉर्म प्रशासक, सुरक्षा और ऑडिटर की भूमिकाओं के विभाजन, बहु-स्तरीय वर्गीकरण नियंत्रण और पूर्ण ऑपरेशन लॉग प्रदान करता है, साथ ही कंप्यूटिंग क्षमताओं, मॉडल कॉल ऑडिट और प्रत्येक परियोजना के लिए उपयोग सांख्यिकी को भी ट्रैक करता है।

होंगयून को चाइनीज एकेडमी ऑफ साइंसेज के वेस्टर्न इंस्टीट्यूट ऑफ कम्प्यूटेशनल टेक्नोलॉजी द्वारा इनक्यूबेट किया गया था, और इसकी मुख्य टीम इंस्टीट्यूट ऑफ कम्प्यूटेशनल टेक्नोलॉजी और सुगोन के कर्मचारियों से बनी है। कंपनी ने 2020 में Huawei के Ascend पार्टनर कार्यक्रम में शामिल हो गया था। कंपनी Ascend और Hygon DCU हार्डवेयर पर विकास जारी रखने की योजना बना रही है, जिसमें विषम शेड्यूलिंग, अनुमान त्वरण, कैशिंग और एजेंट अनुप्रयोगों पर विशेष ध्यान दिया जाएगा।

Lenovo ने 35B मॉडल को स्थानीय रूप से चलाने के लिए Zhaoxin KX-7000 प्रोसेसर और NPU Houmo LQ50 के साथ AI होस्ट Kaitian पेश किया
और पढ़ें
pandaily.com

Lenovo ने 35B मॉडल को स्थानीय रूप से चलाने के लिए Zhaoxin KX-7000 प्रोसेसर और NPU Houmo LQ50 के साथ AI होस्ट Kaitian पेश किया

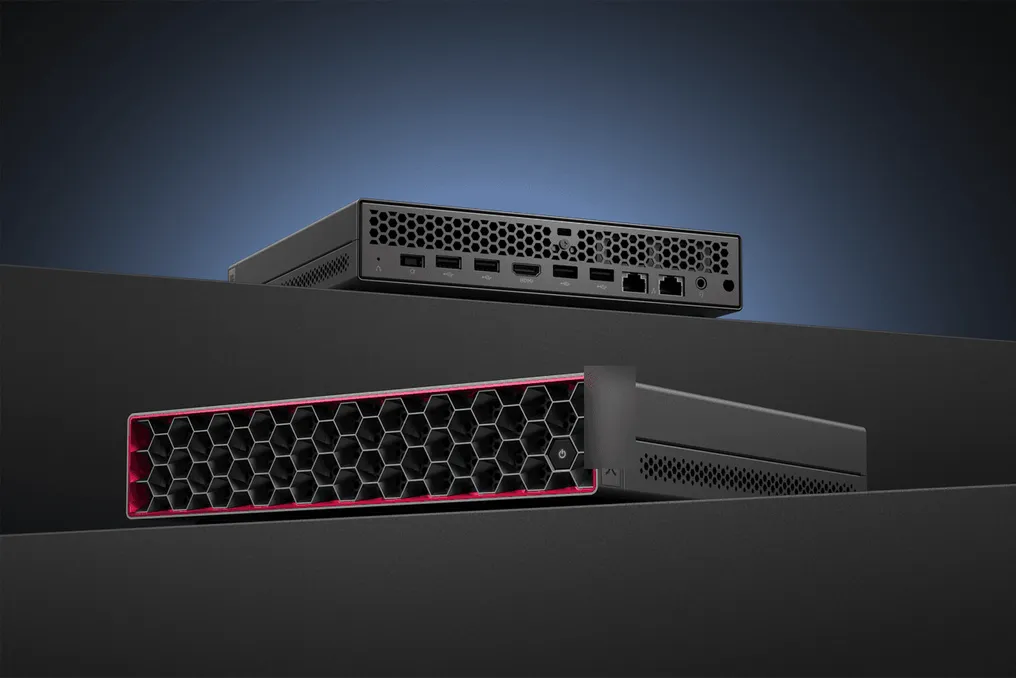
Lenovo ने चीन के आईटी नवाचार बाजार (Xinchuang) के लिए Kaitian श्रृंखला में पहला AI होस्ट सिस्टम जारी किया है। यह 1.6 लीटर का डेस्कटॉप कंप्यूटर Zhaoxin प्रोसेसर को Houmo के AI NPU के साथ जोड़ता है, जिससे लगभग 35 बिलियन पैरामीटर वाले मॉडल को स्थानीय रूप से चलाया जा सकता है।

डिवाइस में आठ-कोर Zhaoxin KX-7000 प्रोसेसर और Houmo Liqing LQ50 NPU लगा हुआ है। मानक कॉन्फ़िगरेशन में सिस्टम INT8 प्रारूप में 160 TOPS की कंप्यूटिंग शक्ति प्रदान करता है, और NPU विकल्प के साथ यह शक्ति 320 TOPS तक पहुंच सकती है। NPU में 153.6 GB/s बैंडविड्थ के साथ 24 GB समर्पित मेमोरी है। होस्ट Kylin OS पर चलता है और Lenovo के Tianxi AI Pro एजेंट के साथ प्री-इंस्टॉल किया गया है।

कंपनी ने Qwen3.5 और Qwen3.6-35B-A3B सीरीज़ सहित ओपन मॉडल का उपयोग करके डिवाइस का परीक्षण किया। 24 GB NPU और W4A8 क्वांटाइजेशन का उपयोग करते हुए, Qwen3.6-35B-A3B मॉडल ने स्थानीय आउटपुट पर प्रति सेकंड लगभग 28.99 टोकन की गति से टेक्स्ट उत्पन्न किया। सिस्टम लंबी दस्तावेज़ों और मल्टी-टर्न कार्यों को संसाधित करने के लिए 200,000 टोकन तक डेटा इनपुट का समर्थन करता है। Houmo प्लेटफॉर्म डेवलपर्स को मॉडल प्रोफाइलिंग, संकलन, निष्पादन समय प्रबंधन और क्वांटाइजेशन के लिए उपकरण प्रदान करता है।

Lenovo इस होस्ट को एक स्थायी डिजिटल कर्मचारी के रूप में प्रस्तुत करता है जिसे चौबीसों घंटे काम करने के लिए डिज़ाइन किया गया है। यह एजेंटों को स्थानीय ज्ञान की खोज, दस्तावेज़ तैयार करने और जानकारी को सारांशित करने जैसे निर्धारित कार्यों को करने की अनुमति देता है, जबकि आउटपुट प्रोसेसिंग सीधे डिवाइस पर होती है, न कि क्लाउड टोकन के माध्यम से, जिससे डेटा स्थानीय रूप से सुरक्षित रहता है। Tianxi AI Pro कार्यक्रम में, परीक्षकों ने मोबाइल ऑपरेटर एप्लिकेशन की जांच करने का एक निर्देश दिया, और डिवाइस ने टेस्ट कॉल किया, सत्यापन कोड विलंबता को मापा और एक रिपोर्ट प्रदान की।

थर्मल प्रबंधन के संबंध में, प्रोसेसर और NPU में हेक्सागोनल फ्रंट पैनल के पीछे उच्च दबाव वाले पंखों के साथ अलग वायु चैनल हैं। Lenovo बताता है कि कमरे के तापमान 25 डिग्री सेल्सियस पर होने पर आइडल मोड में केस का तापमान लगभग 33 डिग्री सेल्सियस होता है, और पूर्ण लोड पर 41 डिग्री सेल्सियस होता है। 35 डिग्री सेल्सियस के कमरे में पूर्ण लोड पर तापमान लगभग 46 डिग्री तक पहुंच जाता है। निष्क्रिय मोड में शोर का स्तर 19.4 dB और पूर्ण NPU इन्फेरेंस के दौरान लगभग 29.5 dB है। डिवाइस का वजन लगभग 1.5 किलोग्राम है और इसमें दो स्वतंत्र 2.5GbE पोर्ट लगे हैं।

यह ध्यान रखना महत्वपूर्ण है कि Kaitian होस्ट अक्टूबर में Houmo M50 और CIX P1 चिप्स के साथ पेश किए गए Lenovo AI Host P7 से अलग है।

असेन्ड 950DT पर 1024 NPU के साथ पहला सुपरपोड क्लस्टर उहान में केवल एक महीने में लॉन्च हुआ
और पढ़ें
pandaily.com

असेन्ड 950DT पर 1024 NPU के साथ पहला सुपरपोड क्लस्टर उहान में केवल एक महीने में लॉन्च हुआ

हुआवेई के 1024 असेन्ड 950DT कार्डों पर निर्मित पहले कंप्यूटिंग क्लस्टर को उहान शहर में सक्रिय किया गया। यह लॉन्च 28 अक्टूबर को हुआ था, जो हुआवेई के हुबेई प्रांत के लिए आर्टिफिशियल इंटेलिजेंस सम्मेलन का हिस्सा था, जो हुआवेई रोड शो 2026 के तहत आयोजित किया गया था।

इस क्लस्टर में निवेश हुबेई प्रांतीय विज्ञान और प्रौद्योगिकी निवेश समूह द्वारा प्रदान किया गया, जो प्रांत का सरकारी निवेशक है। इस समूह के आंकड़ों के अनुसार, परियोजना को काम शुरू होने से लेकर संचालन में आने तक केवल एक महीने का समय लगा, जो इतने बड़े पैमाने की प्रणाली के लिए अपेक्षाकृत कम समय है।

डिप्लॉयमेंट एक एकीकृत लिक्विड-कूल्ड सुपरपोड है। एक नोड में 1024 असेन्ड NPU एक्सेलेरेटर कार्ड लगे हैं। कम्प्यूटेशनल और इंटरकनेक्ट कैबिनेट दोनों तरल शीतलन प्रणालियों से पूरी तरह सुसज्जित हैं। यह सिस्टम FP8 प्रारूप में 1 EFLOPS प्रदर्शन प्रदान करने में सक्षम है और इसमें 256 TB वैश्विक रूप से एकीकृत मेमोरी है। कार्डों के बीच थ्रूपुट टेराबाइट प्रति सेकंड तक पहुंचता है, और एंड-टू-एंड विलंबता माइक्रोसेकंड होती है।

डिज़ाइन आर्किटेक्चर यूनिफाइडबस पर आधारित है, जो सुपरपोड के लिए हुआवेई की आंतरिक इंटरकनेक्शन आर्किटेक्चर है। यह तकनीक क्लस्टर में प्रत्येक कार्ड को अन्य कार्डों तक सीधे पहुंचने की अनुमति देती है, जिससे 1024 NPU कई अलग-अलग सर्वरों के बजाय एक बड़े त्वरक के रूप में कार्य करते हैं जो मानक नेटवर्क के माध्यम से जुड़े होते हैं। हुआवेई इस इंस्टॉलेशन को ट्रिलियन पैरामीटर वाले मॉडल को प्रशिक्षित करने और एआई एजेंटों के इन्फेरेंस को चलाने के लिए लक्षित करती है।

सुपरपोड दृष्टिकोण का मुख्य लाभ सीधा एक्सेस है। बड़े मॉडल को प्रशिक्षित करते समय, काफी समय चिप्स के बीच डेटा स्थानांतरित करने में खर्च होता है। पूरे पॉड और उसके भीतर इंटरकनेक्ट आर्किटेक्चर में एकीकृत मेमोरी बनाए रखने से उस ट्रैफ़िक की मात्रा कम हो जाती है जिसे धीमी चैनलों के माध्यम से गुजरना पड़ता है।

क्लस्टर स्थानीय जरूरतों को पूरा करने के लिए डिज़ाइन किया गया है। इसका उद्देश्य हुबेई में मॉडल डेवलपर्स और कंपनियों को बड़े मॉडल को प्रशिक्षित करने के लिए कंप्यूटिंग क्षमताओं का एक सुलभ स्रोत प्रदान करना है, साथ ही उद्योग-विशिष्ट एआई एजेंटों के निर्माण, ट्यूनिंग और संचालन के लिए भी उपलब्ध कराना है। स्थानीय स्रोतों ने उल्लेख किया है कि यह प्रांत में उच्च-प्रदर्शन कंप्यूटिंग आपूर्ति में कमी को पूरा करता है।

उहान में लॉन्च असेन्ड 950 पीढ़ी के प्रारंभिक व्यावहारिक कार्यान्वयन का भी प्रतीक है। इसी साल हुआवेई ने असेन्ड 950 पर आधारित भौतिक सुपरपोड का प्रदर्शन किया था और तब बताया था कि पिछले पीढ़ी के 750 से अधिक असेन्ड 384 सुपरपोड वाणिज्यिक रूप से तैनात किए जा चुके थे। उहान में 950DT क्लस्टर प्रदर्शनकारी उपकरण से क्षेत्रीय एआई कंप्यूटिंग केंद्रों में नई सुपरपोड संरचना के संक्रमण को दर्शाता है।

हुआवेई ने क्लस्टर की ऊर्जा खपत या उपयोग के विस्तृत आंकड़े जारी नहीं किए हैं; ऊपर दिए गए संख्यात्मक मान लॉन्च कार्यक्रम में बताए गए थे।

लोकप्रिय