GPUWorks ने एक क्लस्टर में Ascend, PPU, Hygon और NVIDIA के समर्थन के साथ इन्फेरेंस के लिए प्लेटफॉर्म लॉन्च किया
और पढ़ें
Pandaily
pandaily.com

GPUWorks ने एक क्लस्टर में Ascend, PPU, Hygon और NVIDIA के समर्थन के साथ इन्फेरेंस के लिए प्लेटफॉर्म लॉन्च किया

GPUWorks, जो आर्टिफिशियल इंटेलिजेंस इन्फेरेंस के लिए एक हल्का एंटरप्राइज प्लेटफॉर्म है, को 4 नवंबर को Apache-2.0 लाइसेंस के तहत ओपन सोर्स के रूप में जारी किया गया था। इस बारे में जानकारी IT Home प्रकाशन द्वारा प्रकाशित की गई थी। कोड FlitAI संगठन पर GitHub पर उपलब्ध है, जिससे उद्यम और डेवलपर्स इसे उपयोग कर सकते हैं, संशोधित कर सकते हैं या इन्फेरेंस और चिप अनुकूलन टेम्पलेट्स में योगदान दे सकते हैं।

यह प्लेटफॉर्म विभिन्न निर्माताओं और स्रोतों से एक्सेलेरेटर को एक एकीकृत प्रबंधित पूल में जोड़ता है। यह हार्डवेयर के साथ मॉडल का मिलान करता है, GPU मेमोरी आवश्यकताओं का आकलन करता है, और टेम्पलेट से मॉडलों को डिप्लॉय करता है, जिसके बाद उन्हें OpenAI के साथ संगत API के माध्यम से एक्सेस प्रदान किया जाता है। समर्थित चिप्स में NVIDIA और AMD के अलावा Huawei Ascend, T-Head PPU और Hygon DCU शामिल हैं।

बेयर-मेटल सर्वर, वर्चुअल मशीन और क्लाउड कंटेनर एक ही क्लस्टर में काम कर सकते हैं, चाहे वे कंपनी के अपने डेटा सेंटर में हों, निजी क्लाउड में हों या सार्वजनिक क्लाउड में हों।

प्लेटफॉर्म की विशेषताएं और प्रदर्शन

डेवलपर्स समाधान की कॉम्पैक्टनेस पर विशेष जोर देते हैं: इंस्टॉलर का वजन 40 एमबी से थोड़ा अधिक है, यह लगभग 60 सेकंड में एक कमांड से स्थापित हो जाता है और इसके लिए Kubernetes का उपयोग करने की आवश्यकता नहीं होती है। आंतरिक नेटवर्क के उपयोगकर्ता ऑफ़लाइन मोड में इंस्टॉलर, मॉडल फ़ाइलें और रनटाइम इमेज डाउनलोड कर सकते हैं। कैटलॉग में लगभग 400 मॉडलों के लिए एक हजार से अधिक कॉन्फ़िगरेशन शामिल हैं, जिसमें प्रत्येक मॉडल और चिप संयोजन के लिए एक इमेज, इन्फेरेंस इंजन, वेट संस्करण और लॉन्च ध्वज पैक किए जाते हैं।

एक AI-आधारित सहायक विफलताओं का निदान करने में मदद करता है, और शेड्यूलर प्रत्येक निर्णय को समझाता है जो प्लेसमेंट के बारे में लिया गया है। टीम के स्वयं के परीक्षणों के अनुसार, एक GPUWorks सर्वर 1003 GPU सर्वरों का प्रबंधन कर सका और चार मिनट में 500 से अधिक इन्फेरेंस प्रतिकृतियां शुरू कर सका। इस दौरान, केवल नौ सीपीयू कोर और 1.6 जीबी मेमोरी का उपयोग करते हुए, आउटपुट प्रति सेकंड 69,000 टोकन तक पहुंच गया। डीपसीक-V4.1-फ्लैश के डिप्लॉयड होने का समय केवल 3.6 सेकंड था।

जागने की सुविधा कई बड़े मॉडलों को एक ही GPU का बारी-बारी से उपयोग करने की अनुमति देती है। पहले स्तर का स्लीप मोड मॉडल वेट को होस्ट मेमोरी में सहेजता है, जिससे इंजन को पुनरारंभ करने या स्टोरेज से वेट को फिर से लोड करने की आवश्यकता समाप्त हो जाती है। आठ NVIDIA H20 कार्डों पर परीक्षण के दौरान, जहां तीन बड़े मॉडल सभी आठ कार्डों पर वितरित थे, NFS स्टोरेज से कोल्ड स्टार्ट में 16 से 17.5 मिनट लगते थे, जबकि मेमोरी से जागने के बाद सेवा की बहाली में लगभग चार सेकंड लगे, जो लगभग 200 गुना सुधार दर्शाता है। व्यवस्थापक प्राथमिकता नीतियों, निष्क्रियता पर रिलीज या अनुसूचित रोटेशन को कॉन्फ़िगर करने में सक्षम हैं।

अधिक बड़े वर्कलोड के लिए, प्लेटफॉर्म मल्टी-नोड पैरेललिज्म, एकाधिक प्रतिकृतियां और प्रीप्रोसेसिंग और डिकोडिंग के विभाजन का समर्थन करता है, जिससे RDMA नेटवर्किंग या Ascend HCCS चैनलों को कॉन्फ़िगर करना संभव होता है। स्केलिंग से पहले थ्रूपुट और विलंबता की जांच के लिए अंतर्निहित लोड परीक्षण भी प्रदान किए जाते हैं। सिस्टम प्रत्येक API कुंजी, मॉडल और डिप्लॉयमेंट के लिए टोकन उपयोग और कैश हिट्स, साथ ही मिलियन आउटपुट टोकन प्रति कार्ड घंटे और अप्रयुक्त GPU को ट्रैक करता है। नोड के रखरखाव के दौरान, प्लेटफॉर्म पुराने को हटाना शुरू करने से पहले प्रतिकृतियां जोड़ता है, और यदि मशीन विफल हो जाती है तो स्वचालित रूप से दूसरे उपयुक्त नोड पर सेवाओं को पुनर्स्थापित करता है।

समान कहानियाँ

मूअर थ्रेड्स का वुक्सी क्लस्टर 2112 जीपीयू के साथ वाणिज्यिक संचालन शुरू होने के बाद 92.9% उपयोग पर पहुंच गया
और पढ़ें
pandaily.com

मूअर थ्रेड्स का वुक्सी क्लस्टर 2112 जीपीयू के साथ वाणिज्यिक संचालन शुरू होने के बाद 92.9% उपयोग पर पहुंच गया

मूअर थ्रेड्स के MTT S5000 ग्राफिक्स प्रोसेसर पर निर्मित घरेलू कंप्यूटिंग क्लस्टर का वाणिज्यिक संचालन उसी में शुरू हुआ। 2 नवंबर की झिडक्स रिपोर्ट के अनुसार, इस केंद्र ने जून में अपना पहला चरण शुरू किया, जुलाई में परीक्षण मोड में प्रवेश किया और अक्टूबर में वाणिज्यिक सेवा शुरू की।

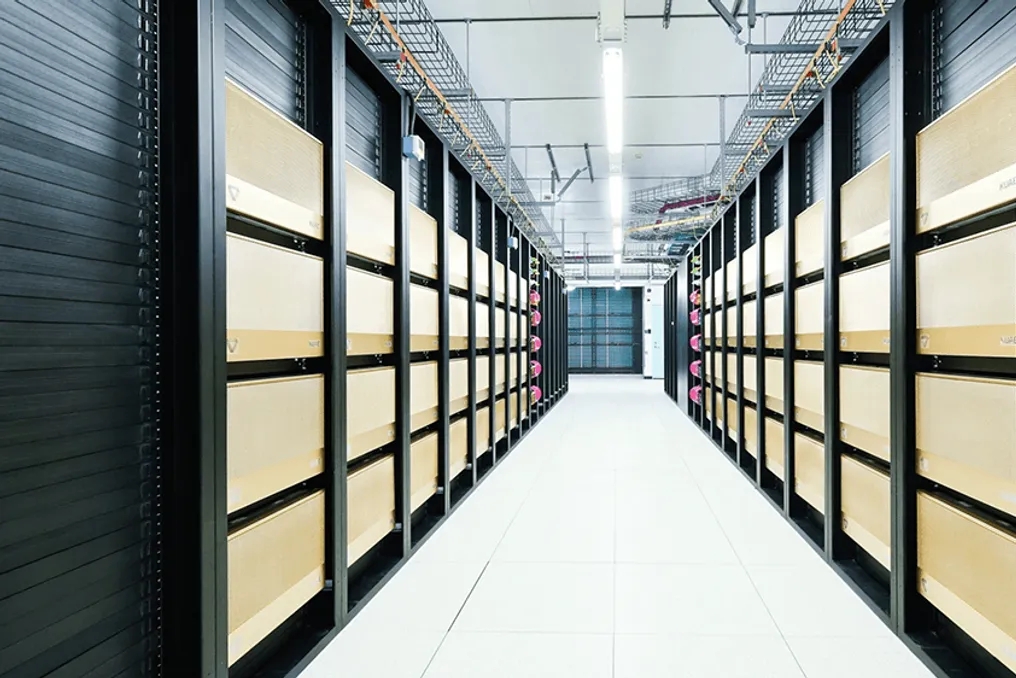
क्लस्टर के वर्तमान चरण में 264 सर्वर शामिल हैं, जिनमें 2112 S5000 कार्ड लगे हैं। झिडक्स द्वारा प्रदान किए गए डेटा से पता चलता है कि क्लस्टर का उपयोग 92.9% तक पहुंच गया है। परीक्षण अवधि के दौरान 55 ग्राहकों को आकर्षित किया गया और 33 मॉडल लागू किए गए। 62% से अधिक वर्कलोड मॉडल प्रशिक्षण पर पड़ता है, जबकि मिश्रित प्रशिक्षण और अनुमान 14.7% और शुद्ध अनुमान 23.1% बनाते हैं।

क्लस्टर चार मॉड्यूल से संरचित है, जिनमें से प्रत्येक में लगभग 500 कार्ड हैं, और इसे तैयार रूप में प्रदान किया गया था। लॉन्च के तीन महीनों के भीतर इसने पूर्ण भार प्राप्त कर लिया। सिस्टम Qwen, GLM, DeepSeek, Kimi और MiniMax सहित 30 से अधिक मॉडल परिवारों का समर्थन करता है।

S5000 पूल और DeepSeek V4 Flash मॉडल का उपयोग करके अनुमान परीक्षण के दौरान, 7 हजार इनपुट और 2 हजार आउटपुट टोकन पर, एक मशीन की थ्रूपुट दर 994.97 टोकन प्रति सेकंड और प्रभावी आउटपुट 1241 टोकन प्रति सेकंड दर्ज की गई। सिस्टम ने लक्षित सेवा स्तर पर 48 समवर्ती अनुरोधों को संभाला, जिसे रिपोर्ट में समान परीक्षण के लिए H800 कॉन्फ़िगरेशन के 92% स्तर पर निर्धारित किया गया है। यह ध्यान रखना महत्वपूर्ण है कि ये आंकड़े क्लस्टर ऑपरेटरों द्वारा प्रस्तुत किए गए थे और स्वतंत्र रूप से सत्यापित नहीं किए गए थे।

क्लस्टर मिश्रित परिनियोजन का विकल्प भी प्रदान करता है, जो प्रीलोडिंग और डिकोडिंग के विखंडन के माध्यम से S5000 कार्डों को अन्य एक्सेलेरेटर के साथ जोड़ता है। रिपोर्ट में उल्लिखित एक विन्यास में, दो H20 कार्डों के साथ तीन S5000 कार्डों ने नौ H20 कार्डों के तुलनीय थ्रूपुट प्रदान किया, जो आधार स्तर से लगभग 1.87 गुना अधिक है, साथ ही पहले टोकन के समय को लगभग आधा कर दिया।

ऑटोनॉमस व्हीकल निर्माता नियोलिक्स इस साइट पर अपने स्वायत्त ड्राइविंग मॉडल के लिए प्रशिक्षण करने की योजना बना रहा है, जिसमें मांग 10,000 कार्ड के स्तर के करीब है, जो क्लस्टर में वर्तमान कार्डों की संख्या से लगभग पांच गुना अधिक है। पहले, मूअर थ्रेड्स ने दावा किया था कि उसका 10,000 कार्ड वाला S5000 आधारित क्लस्टर 90% कुशल प्रशिक्षण समय और 95% रैखिक स्केलिंग दक्षता के साथ 10 EFLOPS कम्प्यूटेशनल शक्ति प्रदान करता है। वुक्सी में विस्तार चरणबद्ध तरीके से किया जाएगा, और रिपोर्ट में उल्लेख है कि मूअर थ्रेड्स JD क्लाउड के साथ 100,000 कार्ड के क्लस्टर के निर्माण पर भी सहयोग कर रही है।

उसी में स्थित यह साइट चीन में क्षेत्रीय कंप्यूटिंग केंद्रों की बढ़ती संख्या का हिस्सा है, जो घरेलू एक्सेलेरेटर पर निर्मित हैं, क्योंकि ऑपरेटर प्रदर्शन सेटअप से हटकर बड़े पैमाने पर मॉडल डेवलपर और रोबोटिक्स कंपनियों को सेवा देने वाले क्लस्टर की ओर बढ़ रहे हैं।

मूर थ्रेड्स ने अपने स्वयं के जीपीयू पर ट्रिलियन पैरामीटर वाले MoE मॉडल को प्रशिक्षित करने के लिए मेगैट्रॉन-म्यूसा-टाइटन जारी किया
और पढ़ें
pandaily.com

मूर थ्रेड्स ने अपने स्वयं के जीपीयू पर ट्रिलियन पैरामीटर वाले MoE मॉडल को प्रशिक्षित करने के लिए मेगैट्रॉन-म्यूसा-टाइटन जारी किया

मूर थ्रेड्स ने मेगाट्रॉन-म्यूसा-टाइटन प्रोजेक्ट को सार्वजनिक कर दिया है, जिसमें बड़े मॉडल को प्रशिक्षित करने के लिए बुनियादी ढांचा प्रस्तुत किया गया है जिसे उन्होंने अपने स्वयं के ग्राफिक्स प्रोसेसिंग यूनिट्स पर उपयोग के लिए विकसित किया है। यह प्रोजेक्ट मूर थ्रेड्स के 10,000 से अधिक जीपीयू वाले क्लस्टरों पर ट्रिलियन पैरामीटर वाले 'एक्सपर्ट्स का मिश्रण' (mixture-of-experts) प्रकार के मॉडलों के साथ काम करने के लिए डिज़ाइन किया गया है, और इसमें प्री-ट्रेनिंग और रीइन्फोर्समेंट लर्निंग दोनों शामिल हैं।

प्रोजेक्ट का कोड गिटहब पर उपलब्ध है। कंपनी का दावा है कि इस सिस्टम का लगातार उपयोग 10,000 जीपीयू के क्लस्टरों पर ट्रिलियन पैरामीटर वाले MoE की प्री-ट्रेनिंग के लिए किया गया था, जहां लंबे प्रशिक्षण सत्रों ने मॉडल के FLOPs के उच्च उपयोग और प्रक्रिया की स्थिरता सुनिश्चित की।

रिपॉजिटरी में 1 ट्रिलियन पैरामीटर वाले Kimi-K2 शैली के MoE मॉडल के लिए एक कॉन्फ़िगरेशन उदाहरण प्रस्तुत किया गया है। डिजाइन का केंद्रीय सिद्धांत मौजूदा समाधानों के करीब रहना था। मेगाट्रॉन-म्यूसा-टाइटन NVIDIA के मेगाट्रॉन-एलएम फ्रेमवर्क पर बनाया गया है। torch_musa के माध्यम से PyTorch के एकीकरण और MUSA C की CUDA C के साथ संगतता के कारण, MUSA वातावरण वाले डेवलपर्स आधिकारिक मेगाट्रॉन-एलएम, स्लाइम और माइल्स रिपॉजिटरी को क्लोन कर सकते हैं और स्रोत कोड को संशोधित किए बिना मूर थ्रेड्स जीपीयू पर प्रशिक्षण शुरू कर सकते हैं।

प्रोजेक्ट इंगित करता है कि सामान्य एल्गोरिदम और बग फिक्स को उच्च स्तरीय परियोजनाओं में भेजा जाना चाहिए, जबकि मूर थ्रेड्स दो प्रकार के परिवर्तनों पर ध्यान केंद्रित करता है: हार्डवेयर और मूर थ्रेड्स क्लस्टरों के लिए अनुकूलित बड़े पैमाने पर अनुकूलन, और MUSA की विशिष्ट समस्याओं के लिए वर्कअराउंड।

प्री-ट्रेनिंग सुविधाओं में FP8 प्रारूप में ब्लॉक ट्रेनिंग शामिल है, जो मूर थ्रेड्स के MT-TransformerEngine पर निर्भर करता है। MoE टोकन डिस्पैचिंग और फ्यूजन को कंपनी के Async Copy Engine पर चलने वाले DeepEP द्वारा तेज किया जाता है, जो गणनाओं के समानांतर विशेषज्ञ संचार की भी अनुमति देता है। अन्य विकल्पों में वर्चुअल पाइपलाइन समानांतरवाद का उपयोग करके एक्टिवेशन ऑफलोडिंग और एक फॉरवर्ड पास और एक बैकवर्ड पास की शेड्यूलिंग, साथ ही Mooncake RDMA के माध्यम से गणनाओं के साथ पाइपलाइन समानांतर संचार शामिल है।

वितरित ट्रेसिंग विश्लेषण टूल प्रत्येक जीपीयू से PyTorch ट्रेस को पढ़कर पाइपलाइन बबल्स और कम प्रदर्शन वाले नोड्स जैसे बाधाओं का पता लगाता है। प्रोजेक्ट का दावा है कि यह 10,000 जीपीयू पर 1 ट्रिलियन पैरामीटर वाले MoE रन का विश्लेषण केवल कुछ घंटों में कर सकता है।

रीइन्फोर्समेंट लर्निंग के लिए, स्टैक स्लाइम और माइल्स फ्रेमवर्क का समर्थन करता है; मेगाट्रॉन प्रशिक्षण संभालता है, और MUSA-बिल्ड SGLang रन उत्पन्न करता है, जिससे एक ही आधार प्रणाली प्री-ट्रेनिंग और RL दोनों को सेवा दे सकती है। स्वायत्त इन्फेरेंस के लिए अनुकूलन इस प्रोजेक्ट के दायरे में नहीं आता है।

उन डेवलपर्स के लिए जो घरेलू एक्सेलेरेटर पर विचार कर रहे हैं, व्यावहारिक प्रश्न यह है कि मौजूदा प्रशिक्षण कोड का कितना हिस्सा काम करेगा। मूर थ्रेड्स का उत्तर है कि मेगाट्रॉन इकोसिस्टम का कोड किसी संशोधन की मांग नहीं करता है।

Iluvatar CoreX ने Tiangai 300 GPU के प्रदर्शन का प्रदर्शन किया, H200 से 1.05x अधिक प्रदर्शन का दावा किया
और पढ़ें
pandaily.com

Iluvatar CoreX ने Tiangai 300 GPU के प्रदर्शन का प्रदर्शन किया, H200 से 1.05x अधिक प्रदर्शन का दावा किया

इलुवतार कोरएक्स (Iluvatar CoreX) ने 28 अक्टूबर को शंघाई में अपने मीडिया दिवस के दौरान, वास्तविक हार्डवेयर पर सामान्य-उद्देश्यीय ग्राफिक्स प्रोसेसर Tiangai 300 को पहली बार कार्यशील अवस्था में प्रस्तुत किया। इससे पहले, कंपनी की चिप के बारे में सार्वजनिक सामग्री केवल वास्तुकला और रोडमैप पर केंद्रित थी, न कि कार्यात्मक प्रणालियों पर।

मुख्य घोषणा प्रदर्शन की तुलना है। इलुवतार कोरएक्स का दावा है कि Tiangai 300 पहला घरेलू सामान्य-उद्देश्यीय जीपीयू है जिसका मापा गया प्रदर्शन NVIDIA H200 के स्तर तक पहुंचता है। इसके अलावा, डेटा रूपांतरण के बाद तीसरे पक्ष के परीक्षणों से पता चला कि एक कार्ड की कुल थ्रूपुट H200 की तुलना में 1.05 गुना अधिक है। यह ध्यान रखना महत्वपूर्ण है कि कंपनी ने परीक्षण पद्धति, उपयोग किए गए मॉडल या कार्यभार की स्थितियों का खुलासा नहीं किया है, इसलिए इस परिणाम की अभी स्वतंत्र रूप से पुष्टि नहीं की जा सकती है।

यह चिप IXL144 सुपरनोड में लागू करने के लिए डिज़ाइन की गई है, जिसे पहले कंपनी ने चाइना इंटरनेशनल इंडस्ट्रियल एक्सपो में पेश किया था। एक ऐसा IXL144 रैक 144 जीपीयू, 18 सीपीयू और लगभग 10.1 टीबी जीपीयू मेमोरी को जोड़ता है, जिसे इलुवतार कोरएक्स उद्योग में सबसे सघन जीपीयू सुपरनोड कहती है। अपने अनुमानों के अनुसार, यह कॉन्फ़िगरेशन प्रमुख अंतरराष्ट्रीय समाधानों की तुलना में प्रति मिलियन प्रभावी टोकन पर लागत को 40% कम करता है।

ओपन डे पर विषम तैनाती (heterogeneous deployment) के बारे में भी जानकारी प्रस्तुत की गई। इलुवतार कोरएक्स ने बताया कि उसने जीपीयू और XPU के बीच पहली घरेलू AFD डीएग्रीगेशन योजना लागू की है, जिससे इन्फेरेंस विलंबता में 60% की कमी आई है। AFD डीएग्रीगेशन में आमतौर पर मॉडल गणना चरणों, जैसे अटेंशन लेयर्स और फॉरवर्ड पास, को विभिन्न प्रकार के प्रोसेसर के बीच विभाजित करना शामिल होता है ताकि प्रत्येक उस काम को करे जिसमें वह सबसे अधिक कुशल हो।

पेरिफेरल उपकरणों के संबंध में, कंपनी ने दावा किया कि उसका Tongyang TY1200 चिप किए गए परीक्षणों में NVIDIA Thor T5000 से बेहतर प्रदर्शन करता है, हालांकि विवरण प्रकाशित नहीं किए गए हैं। TY1200, जिसे पहले एआई और इमर्सिव इंटेलिजेंस वाले पीसी के लिए 300 TOPS गहन कंप्यूटिंग के साथ घोषित किया गया था, उसे MuJoCo-Warp पर आधारित जीपीयू त्वरण के साथ भौतिकी सिमुलेशन चलाने में सक्षम पहला घरेलू पेरिफेरल उत्पाद भी कहा जाता है - एक ऐसी सुविधा जो सिमुलेशन में रोबोट प्रशिक्षण के लिए महत्वपूर्ण है।

कुल मिलाकर, ये प्रदर्शन इलुवतार कोरएक्स की अगली पीढ़ी के उत्पाद लाइन को कागजी विनिर्देशों से कार्यशील प्रणालियों की ओर ले जाते हैं। अगला बिंदु जिस पर नजर रखी जानी चाहिए, वह स्पष्ट कार्यभार के साथ स्वतंत्र बेंचमार्क होंगे।

लोकप्रिय