DeepSeek, Qwen और MiniMax के नेताओं ने उचजेन में शिखर सम्मेलन में खुले मॉडल के जोखिमों पर चर्चा की
और पढ़ें
Pandaily
pandaily.com

DeepSeek, Qwen और MiniMax के नेताओं ने उचजेन में शिखर सम्मेलन में खुले मॉडल के जोखिमों पर चर्चा की

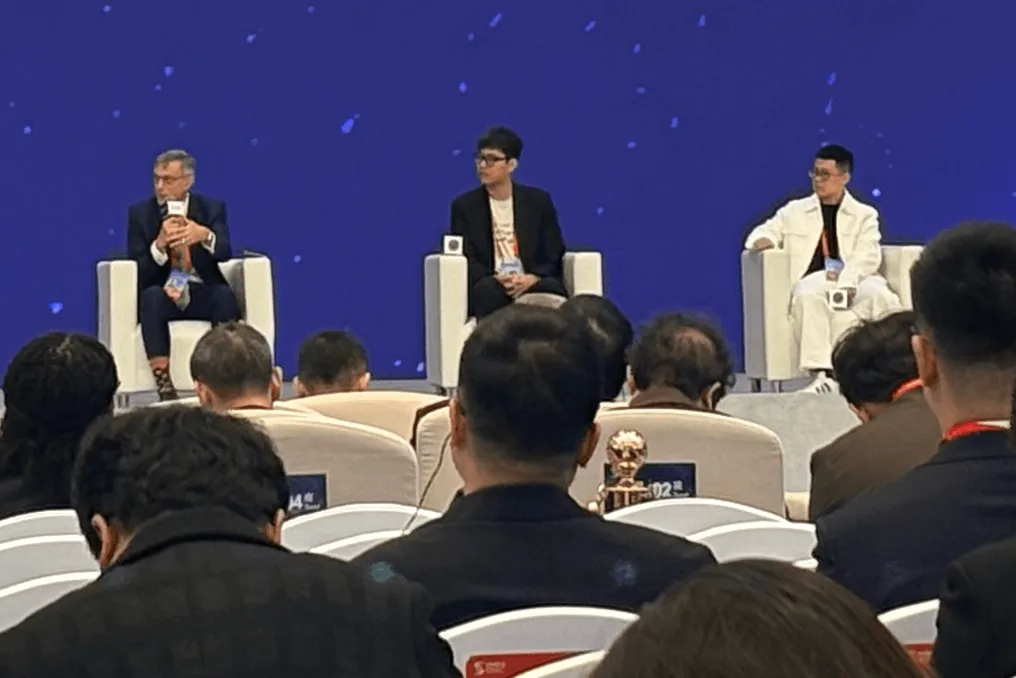
चीन के तीन प्रमुख ओपन-सोर्स मॉडल डेवलपर्स - DeepSeek, अलीबाबा की Qwen टीम और MiniMax - ने अपने मॉडलों को सार्वजनिक रूप से जारी करने के कारणों और खुले मॉडलों को कैसे विनियमित किया जाना चाहिए, इस पर चर्चा में भाग लिया। यह कार्यक्रम 3 नवंबर को उचजेन में वर्ल्ड इंटरनेट कॉन्फ्रेंस समिट में आयोजित किया गया था।

'उचजेन ऑन आर्टिफिशियल इंटेलिजेंस डायलॉग' नामक सत्र की अध्यक्षता चाइनीज एकेडमी ऑफ इंजीनियरिंग के अकादमिक और झेजियांग लैब के निदेशक وان जियान ने की। चर्चा में शामिल थे DeepSeek के इंजीनियर सि गाओ, Qwen LLM प्रोजेक्ट लीड दाईहेंग ल्यू, MiniMax के मुख्य आर्किटेक्ट और ओपन प्लेटफॉर्म हेड वेन फेंग, और अंतर्राष्ट्रीय एआई गवर्नेंस एसोसिएशन के अध्यक्ष जॉन हिगिंस।

सि गाओ ने कहा कि DeepSeek का खुला स्रोत में लक्ष्य सरल है: सामान्य कृत्रिम बुद्धिमत्ता को तेजी से प्राप्त करना। उनके विचार में, एआई प्रयोगशालाओं के लिए मुख्य प्रतियोगी अन्य कंपनियां नहीं, बल्कि समय है। उन्होंने उल्लेख किया कि तकनीकी बाधाएं प्रतिद्वंद्वियों को अस्थायी रूप से धीमा कर सकती हैं, लेकिन शोध प्रकाशित करने से DeepSeek के काम के आधार पर अधिक परिष्कृत मॉडल बनाने के लिए सक्षम सहयोगियों को आकर्षित करता है।

दाईहेंग ल्यू ने बताया कि Qwen ने तीन साल पहले पहली पीढ़ी के लॉन्च होने के बाद से 460 से अधिक मॉडल जारी किए हैं, जिसमें 4 बिलियन से अधिक वैश्विक डाउनलोड और 330,000 से अधिक व्युत्पन्न मॉडल जमा हुए हैं। उनका तर्क है कि ओपन सोर्स कोड नवाचार को गति देता है और एआई को व्यापक रूप से सुलभ बनाता है, जिससे न केवल मॉडल का उपयोग करने का अवसर मिलता है, बल्कि उनमें योगदान करने का भी मिलता है।

अपनी ओर से, वेन फेंग ने समझाया कि MiniMax विभिन्न मोडलिटियों के लिए मॉडल जारी करके और इंजीनियरिंग अनुभव साझा करके विभेदित मूल्य लाने का प्रयास करता है, जिसमें उत्पन्न हुई समस्याओं, किए गए प्रयोगों, डेटा संशोधनों और उपकरणों की जानकारी शामिल है।

जोखिमों के संबंध में, ल्यू ने खुले मॉडलों की दो विशेषताएं बताईं। पहला - अपरिवर्तनीयता: एक बार जारी होने के बाद, मॉडल व्यापक रूप से फैल जाता है और इसे तैनात मॉडल की तरह ठीक नहीं किया जा सकता है। दूसरी समस्या - बाहरी सुरक्षा प्रणालियों की कमी, क्योंकि सुरक्षा अंतर्निहित सावधानियों पर निर्भर करती है जिन्हें तीसरे पक्ष के डेवलपर्स द्वारा दरकिनार करने का प्रयास किया जा सकता है। उन्होंने जोर दिया कि केवल मॉडल प्रतिबंध पर्याप्त नहीं हैं, और उन्होंने कानूनों, उद्योग मानकों और सहायक बुनियादी ढांचे के निर्माण की वकालत की।

ल्यू ने यह भी जोड़ा कि खुलापन सुरक्षा को बढ़ावा देता है, क्योंकि पारदर्शी वास्तुकला वाले मॉडल अधिक शोधकर्ताओं को उनका अध्ययन करने की अनुमति देते हैं, और खुले मॉडलों का उपयोग साइबर सुरक्षा में किया जा सकता है। उन्होंने अनुमान लगाया कि वर्तमान क्षमताओं को कम आंका जा सकता है, यह देखते हुए कि 1.5 बिलियन पैरामीटर वाले मॉडल को भी नए फाइन-ट्यूनिंग तरीकों का उपयोग करके सक्रिय किया जा सकता है।

वेन फेंग ने प्रतिवाद किया कि खुले मॉडल अक्सर उद्योग के लिए अधिक नियंत्रित विकल्प होते हैं, क्योंकि कंपनियां उन्हें अनुकूलित और गोपनीय रूप से तैनात कर सकती हैं। सि गाओ ने स्वीकार किया कि ओपन सोर्स कोड एआई सुरक्षा जोखिमों को बढ़ा सकता है, और उन्होंने कहा कि DeepSeek इन प्रसारों को रोकने की जिम्मेदारी लेता है और समाधान खोजने पर काम कर रहा है।
समान कहानियाँ

WIC वूझेन 2026 शिखर सम्मेलन खुले स्रोत कृत्रिम बुद्धिमत्ता पर जोर देते हुए शुरू हुआ
और पढ़ें
cgtn.com

WIC वूझेन 2026 शिखर सम्मेलन खुले स्रोत कृत्रिम बुद्धिमत्ता पर जोर देते हुए शुरू हुआ

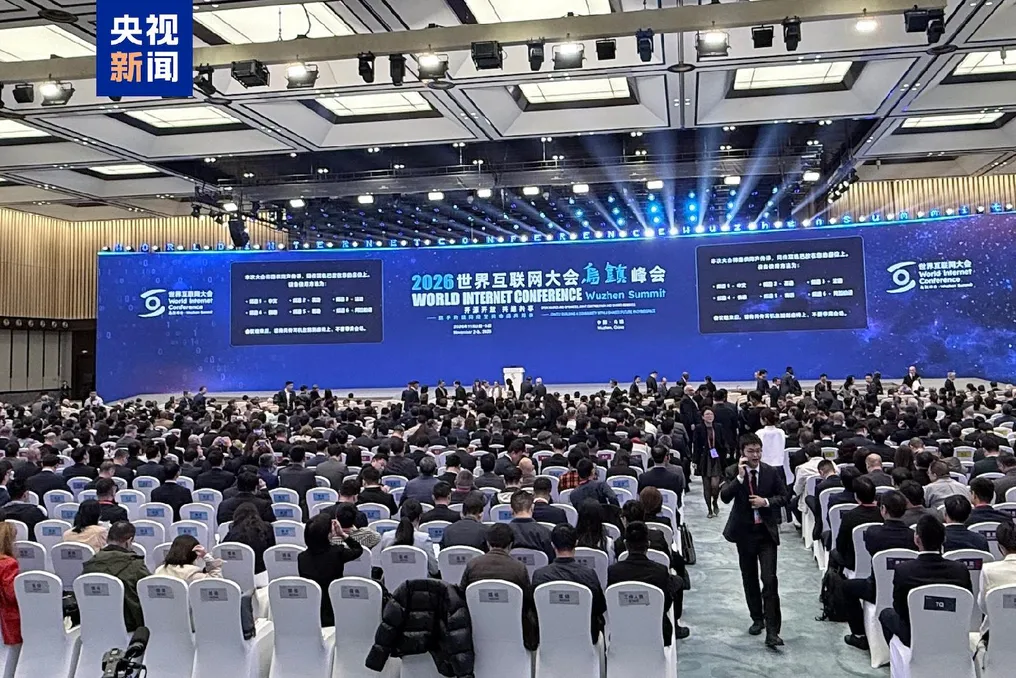
चीन के पूर्वी प्रांत झेजियांग के उचजेन शहर में मंगलवार को वर्ल्ड इंटरनेट कॉन्फ्रेंस (WIC) वूझेन शिखर सम्मेलन का उद्घाटन हुआ। इस कार्यक्रम में दुनिया भर से सरकारों, अंतरराष्ट्रीय संगठनों, व्यवसायों और शैक्षणिक क्षेत्रों के प्रतिनिधियों ने भाग लिया।

इस वर्ष का विषय 'ओपन सोर्स और ओपननेस, सहयोगात्मक विकास और साझा लाभ - साइबरस्पेस में एक साझा भविष्य के साथ समुदाय का सह-निर्माण' के रूप में तैयार किया गया था। शिखर सम्मेलन का मुख्य ध्यान खुले कृत्रिम बुद्धिमत्ता पर है, जिसमें तकनीकी नवाचार, सुरक्षा प्रबंधन, सांस्कृतिक आदान-प्रदान और अंतर्राष्ट्रीय सहयोग जैसे क्षेत्र शामिल हैं।

मुख्य मंच का केंद्रीय तत्व उचजेन में एआई संवाद था, जिसने वैश्विक खुले एआई पारिस्थितिकी तंत्र के निर्माण के मार्गों का अध्ययन करने के लिए प्रमुख वैश्विक प्रौद्योगिकी कंपनियों, ओपन-सोर्स बड़े भाषा मॉडल वाली कंपनियों के नेताओं और एआई वैज्ञानिकों को एक साथ लाया। इसके अलावा, शिखर सम्मेलन में ग्लोबल गवर्नेंस पहल के तहत साइबरस्पेस सहयोग, डिजिटल और बौद्धिक युग में सिद्धांत और नीति, और रोबोटिक्स और एम्बेडेड इंटेलिजेंस जैसे विषयों पर 27 उप-फोरम शामिल हैं।

अंतर्राष्ट्रीय भागीदारी केस प्रतियोगिताओं और तकनीकी पुरस्कारों में देखी गई। साइबरस्पेस में एक साझा भविष्य के साथ समुदाय के सह-निर्माण के उत्कृष्ट उदाहरण प्रस्तुत करने के आह्वान पर 80 देशों और क्षेत्रों से 360 आवेदन प्राप्त हुए, जिनमें से 22 देश पहली बार भाग ले रहे थे। ग्यारह सर्वश्रेष्ठ मामलों का चयन किया गया। इस बीच, नवीन विज्ञान और प्रौद्योगिकी के लिए वर्ल्ड इंटरनेट कॉन्फ्रेंस के पुरस्कारों के लिए 43 देशों और क्षेत्रों से 430 से अधिक आवेदन प्राप्त हुए; अठारह देशों और क्षेत्रों ने पहली बार अपने काम प्रस्तुत किए, और अंतर्राष्ट्रीय आवेदनों की संख्या पिछले वर्ष की तुलना में 21% बढ़ गई। कुल मिलाकर, 20 परियोजनाओं को पुरस्कार मिले।

चीनी इंजीनियरिंग अकादमी के अकादमिक वान जियान ने राय व्यक्त की कि WIC चीन में एआई के विकास में महत्वपूर्ण भूमिका निभाता रहेगा। उन्होंने उल्लेख किया कि चूंकि ओपन सोर्स और ओपननेस वैश्विक प्रकृति के हैं, इसलिए उचजेन में शिखर सम्मेलन वैश्विक एआई विकास में चीन के योगदान को बढ़ावा दे सकता है।

GSMA Ltd. के सीईओ जॉन हॉफमैन ने कहा कि उचजेन शिखर सम्मेलन सभी के लिए सुलभ खुले इंटरनेट के निर्माण के बारे में जानकारी साझा करने और विचारों को एकजुट करने के लिए एक मंच के रूप में कार्य करता है। उन्होंने आगे कहा कि इस वर्ष का विषय शिखर सम्मेलन की 'किसी को पीछे न छोड़ने' के सिद्धांत और भविष्य की दुनिया के लिए अवसर पैदा करने की पुरानी प्रतिबद्धता को दर्शाता है।

QpiAI के संस्थापक नागेंद्र 나가रादजा पारंपरिक एआई के बजाय बुद्धिमत्ता मॉडलिंग का समर्थन करते हैं
और पढ़ें
yourstory.com

QpiAI के संस्थापक नागेंद्र 나가रादजा पारंपरिक एआई के बजाय बुद्धिमत्ता मॉडलिंग का समर्थन करते हैं

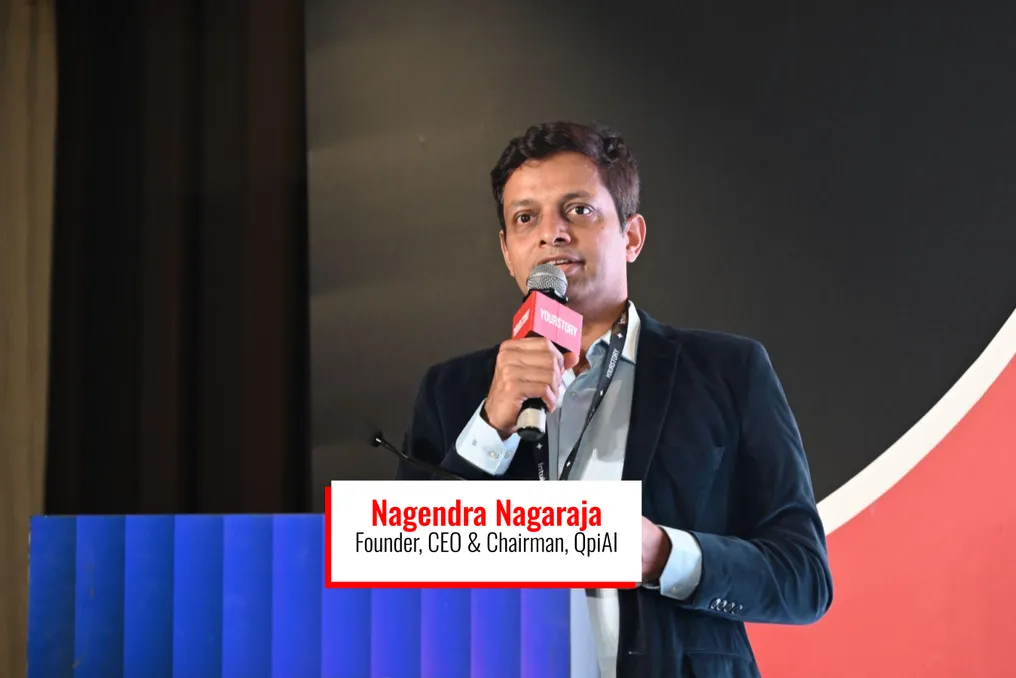
नागेंद्र 나가रादजा, QpiAI के संस्थापक, मुख्य कार्यकारी अधिकारी और निदेशक मंडल के अध्यक्ष, का मानना है कि कृत्रिम बुद्धिमत्ता को गलत समझा जाता है। उन्होंने टेकस्पार्क्स कार्यक्रम में अपने मुख्य भाषण के दौरान 'एआई' के बजाय 'बुद्धिमत्ता मॉडलिंग' शब्द का उपयोग करना पसंद करने की बात कही, जो योरस्टोरी का प्रमुख तकनीकी स्टार्टअप इवेंट है।

उनके अनुसार, पारंपरिक एआई मुख्य रूप से डिजिटाइज़ किए गए मानव ज्ञान का उपयोग करके कार्यों को स्वचालित करता है, न कि मानव समझ का विस्तार करता है। 나가रादजा का तर्क है कि वास्तविक बुद्धिमत्ता के लिए प्रतिमान में मौलिक बदलाव की आवश्यकता है। वह बुद्धिमत्ता को नई चीजें जानने की क्षमता के रूप में परिभाषित करते हैं जो पहले अज्ञात थीं।

आज का एआई बूम क्लासिक माइक्रोप्रोसेसर पर आधारित है, जो बाइनरी कोड (शून्य और एक) का उपयोग करके जानकारी संसाधित करते हैं। हालांकि, सिलिकॉन सेमीकंडक्टर प्रदर्शन के पैमाने पर भौतिक सीमाओं का सामना कर रहे हैं। विद्युत प्रतिरोध के कारण गर्मी उत्पादन चिप डिजाइन में समस्याएं पैदा करता है, जिससे कंपनियों को चिप्स के लिए उन्नत पैकेजिंग विधियों को अपनाने के लिए मजबूर होना पड़ता है, जिसमें थ्री-डी स्टैकिंग शामिल है।

इसके समानांतर, बड़े डेटा सेंटर बिजली ग्रिडों पर बढ़ती मांग रखते हैं, जिनमें से कुछ गीगावाट बिजली की खपत करते हैं। 나가रादजा ने उल्लेख किया कि कई एआई कंपनियां ग्राफिक्स प्रोसेसिंग यूनिट्स (GPUs) के उपयोग के लिए 'एनवीडिया टैक्स' का भुगतान करने के लिए मजबूर हैं।

इसके अलावा, मानव पाठ पर प्रशिक्षित बड़े भाषा मॉडल (LLMs) डेटा संतृप्ति तक पहुंच रहे हैं और अरबों डॉलर के निवेश की आवश्यकता के बावजूद कम रिटर्न दे रहे हैं। 나가रादजा के अनुसार, वर्तमान एआई की मूलभूत सीमा मानव पाठ पर उसकी पूर्ण निर्भरता है, जो वैश्विक जानकारी का एक नगण्य हिस्सा है।

ब्रह्मांड में अधिकांश डेटा, जो इलेक्ट्रॉनों, अणुओं, डीएनए और क्रिस्टलीय सामग्रियों में एन्कोड किया गया है, एक गैर-क्वांटम, क्वांटम अवस्था में मौजूद है जिसे क्लासिक जीपीयू संसाधित नहीं कर सकते हैं। क्लासिक सुपरकंप्यूटर पर एनपी-हार्ड जैसे जटिल गणितीय समस्याओं को संसाधित करने में $10^{25}$ साल लग सकते हैं। क्वांटम कंप्यूटिंग इस समस्या का समाधान क्यूबिट्स का उपयोग करके करती है, जो बहुआयामी डेटा को घातीय रूप से तेजी से संसाधित करते हैं।

나가रादजा ने कार्य की तात्कालिकता पर जोर दिया: 'जैसे मानवता, पिछले 5000 वर्षों में हम $10^{10}$ अणुओं को जानते हैं... हमें $10^{50}$ अणुओं को जानना होगा। और हमारे पास 25,000 साल नहीं हैं। हमें इसे एक दशक में करना होगा।'

나가रादजा ने तर्क दिया कि मानव निर्मित पाठ से प्राकृतिक प्रणालियों के मॉडलिंग में बदलाव पूरे उद्योगों को बदल सकता है। उन्होंने बताया कि दुनिया में केवल दो प्रमुख उद्योग हैं - ऊर्जा और कंप्यूटिंग; बाकी सभी उनसे व्युत्पन्न हैं।

उन्होंने पौधों द्वारा उर्वरकों के अवशोषण और प्रसंस्करण से संबंधित जटिल रासायनिक प्रतिक्रियाओं के मॉडलिंग की समस्या का उदाहरण दिया। 나가रादजा के अनुसार, ऐसी समस्याएं बड़े पैमाने पर क्लासिक गणनाओं के लिए दुर्गम हो सकती हैं। उन्होंने अनुमान लगाया कि 3000 तार्किक क्यूबिट्स वाला एक क्वांटम सिस्टम - त्रुटि सुधार वाले क्यूबिट्स जिन्हें भौतिक क्यूबिट्स की तुलना में अधिक विश्वसनीय संचालन के लिए डिज़ाइन किया गया है - ऐसी प्रतिक्रियाओं का मॉडल बना सकता है, जिससे कृषि उत्पादन में संभावित परिवर्तन आ सकता है।

इसी तरह, क्वांटम हाइब्रिड मॉडल, जो क्लासिक सॉफ्टवेयर को क्वांटम हार्डवेयर के साथ जोड़ते हैं, बड़े बैंकों में वित्तीय धोखाधड़ी का पता लगाने की दक्षता को काफी कम ऊर्जा खपत के साथ बढ़ा रहे हैं।

इन क्षमताओं को उजागर करने के लिए उन्नत हार्डवेयर और त्वरित त्रुटि सुधार की आवश्यकता होती है, यानी वास्तविक समय में क्वांटम शोर को दूर करना। 나가रादजा ने बताया कि QpiAI बेंगलुरु में एशिया में सबसे बड़े क्वांटम फैब्रिकेशन उद्यम का प्रबंधन करता है, जो 1.4 माइक्रोसेकंड की त्रुटि सुधार दर पर 25 और 64 क्यूबिट वाले चिप्स का उत्पादन करता है, जो अंतरराष्ट्रीय मानकों से बेहतर है। कंपनी वर्तमान में 100 क्वांटम कंप्यूटरों से सुसज्जित दस एकड़ का क्वांटम डेटा सेंटर बना रही है, और 1000 क्यूबिट वाले चिप्स विकसित करने की भी योजना बना रही है।

निष्कर्ष में, 나가रादजा ने कहा कि भारत ने महत्वपूर्ण प्रगति की है, पांच देशों में से एक बन गया है जहां 50 से अधिक क्यूबिट का उत्पादन होता है। अंततः, एआई की वर्तमान सीमाओं को पार करने के लिए मानवता को प्रकृति का 'बहुत अच्छा छात्र' बनना होगा ताकि उसके अनंत डेटा का उपयोग किया जा सके।

DeepSeek ने Nvidia और Huawei चिप्स के समर्थन के साथ DeepInfer के लिए एक फ्रेमवर्क जारी किया
और पढ़ें
technode.com

DeepSeek ने Nvidia और Huawei चिप्स के समर्थन के साथ DeepInfer के लिए एक फ्रेमवर्क जारी किया

DeepSeek कंपनी ने DeepInfer जारी किया है, जो इन्फेरेंस निष्पादन के लिए एक फ्रेमवर्क है और यह उनकी बड़े मॉडल सेवाओं का आधार है। यह रिलीज़ 20 अक्टूबर को हुई।

DeepInfer में Nvidia ग्राफिक्स प्रोसेसर के साथ-साथ Huawei Ascend प्रोसेसर का भी समर्थन है। यह फ्रेमवर्क वितरित इन्फेरेंस, सट्टा डिकोडिंग और संरचित आउटपुट सहित कई सुविधाएँ प्रदान करता है।

DeepSeek के बयान के अनुसार, इस रिलीज़ का उद्देश्य डेवलपर्स और उद्यमों को कंप्यूटिंग लागत और ऊर्जा खपत को कम करते हुए थ्रूपुट बढ़ाने और विलंबता कम करने में मदद करना है।

इसके अलावा, कंपनी ने deepseek-recipe घटक को सार्वजनिक रूप से उपलब्ध कराया है। यह API अनुरोधों को बदलने और DeepSeek की अपनी सेवाओं के अनुसार मॉडल इनपुट और आउटपुट को संसाधित करने के लिए जिम्मेदार है। वर्तमान में DeepInfer DeepSeek-V4.1-Flash-1017 मॉडल का समर्थन करता है, और कंपनी इस परियोजना के माध्यम से भविष्य के मॉडलों के लिए इन्फेरेंस कोड और अनुकूलन जारी करना जारी रखने का इरादा रखती है।

लोकप्रिय