मूअर थ्रेड्स का वुक्सी क्लस्टर 2112 जीपीयू के साथ वाणिज्यिक संचालन शुरू होने के बाद 92.9% उपयोग पर पहुंच गया
और पढ़ें
Pandaily
pandaily.com

मूअर थ्रेड्स का वुक्सी क्लस्टर 2112 जीपीयू के साथ वाणिज्यिक संचालन शुरू होने के बाद 92.9% उपयोग पर पहुंच गया

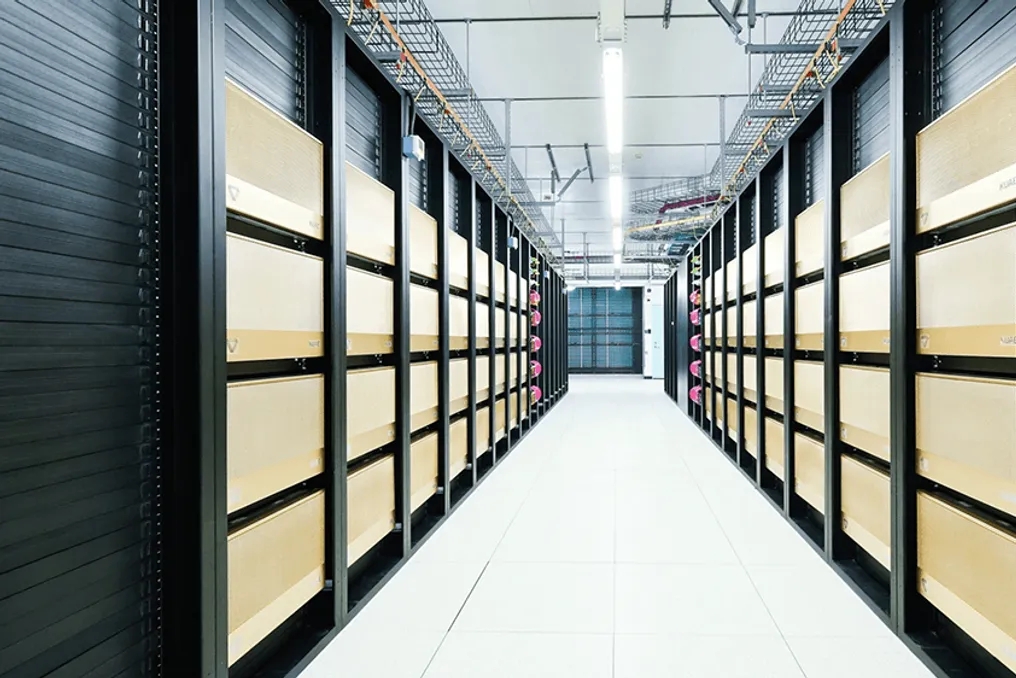
मूअर थ्रेड्स के MTT S5000 ग्राफिक्स प्रोसेसर पर निर्मित घरेलू कंप्यूटिंग क्लस्टर का वाणिज्यिक संचालन उसी में शुरू हुआ। 2 नवंबर की झिडक्स रिपोर्ट के अनुसार, इस केंद्र ने जून में अपना पहला चरण शुरू किया, जुलाई में परीक्षण मोड में प्रवेश किया और अक्टूबर में वाणिज्यिक सेवा शुरू की।

क्लस्टर के वर्तमान चरण में 264 सर्वर शामिल हैं, जिनमें 2112 S5000 कार्ड लगे हैं। झिडक्स द्वारा प्रदान किए गए डेटा से पता चलता है कि क्लस्टर का उपयोग 92.9% तक पहुंच गया है। परीक्षण अवधि के दौरान 55 ग्राहकों को आकर्षित किया गया और 33 मॉडल लागू किए गए। 62% से अधिक वर्कलोड मॉडल प्रशिक्षण पर पड़ता है, जबकि मिश्रित प्रशिक्षण और अनुमान 14.7% और शुद्ध अनुमान 23.1% बनाते हैं।

क्लस्टर चार मॉड्यूल से संरचित है, जिनमें से प्रत्येक में लगभग 500 कार्ड हैं, और इसे तैयार रूप में प्रदान किया गया था। लॉन्च के तीन महीनों के भीतर इसने पूर्ण भार प्राप्त कर लिया। सिस्टम Qwen, GLM, DeepSeek, Kimi और MiniMax सहित 30 से अधिक मॉडल परिवारों का समर्थन करता है।

S5000 पूल और DeepSeek V4 Flash मॉडल का उपयोग करके अनुमान परीक्षण के दौरान, 7 हजार इनपुट और 2 हजार आउटपुट टोकन पर, एक मशीन की थ्रूपुट दर 994.97 टोकन प्रति सेकंड और प्रभावी आउटपुट 1241 टोकन प्रति सेकंड दर्ज की गई। सिस्टम ने लक्षित सेवा स्तर पर 48 समवर्ती अनुरोधों को संभाला, जिसे रिपोर्ट में समान परीक्षण के लिए H800 कॉन्फ़िगरेशन के 92% स्तर पर निर्धारित किया गया है। यह ध्यान रखना महत्वपूर्ण है कि ये आंकड़े क्लस्टर ऑपरेटरों द्वारा प्रस्तुत किए गए थे और स्वतंत्र रूप से सत्यापित नहीं किए गए थे।

क्लस्टर मिश्रित परिनियोजन का विकल्प भी प्रदान करता है, जो प्रीलोडिंग और डिकोडिंग के विखंडन के माध्यम से S5000 कार्डों को अन्य एक्सेलेरेटर के साथ जोड़ता है। रिपोर्ट में उल्लिखित एक विन्यास में, दो H20 कार्डों के साथ तीन S5000 कार्डों ने नौ H20 कार्डों के तुलनीय थ्रूपुट प्रदान किया, जो आधार स्तर से लगभग 1.87 गुना अधिक है, साथ ही पहले टोकन के समय को लगभग आधा कर दिया।

ऑटोनॉमस व्हीकल निर्माता नियोलिक्स इस साइट पर अपने स्वायत्त ड्राइविंग मॉडल के लिए प्रशिक्षण करने की योजना बना रहा है, जिसमें मांग 10,000 कार्ड के स्तर के करीब है, जो क्लस्टर में वर्तमान कार्डों की संख्या से लगभग पांच गुना अधिक है। पहले, मूअर थ्रेड्स ने दावा किया था कि उसका 10,000 कार्ड वाला S5000 आधारित क्लस्टर 90% कुशल प्रशिक्षण समय और 95% रैखिक स्केलिंग दक्षता के साथ 10 EFLOPS कम्प्यूटेशनल शक्ति प्रदान करता है। वुक्सी में विस्तार चरणबद्ध तरीके से किया जाएगा, और रिपोर्ट में उल्लेख है कि मूअर थ्रेड्स JD क्लाउड के साथ 100,000 कार्ड के क्लस्टर के निर्माण पर भी सहयोग कर रही है।

उसी में स्थित यह साइट चीन में क्षेत्रीय कंप्यूटिंग केंद्रों की बढ़ती संख्या का हिस्सा है, जो घरेलू एक्सेलेरेटर पर निर्मित हैं, क्योंकि ऑपरेटर प्रदर्शन सेटअप से हटकर बड़े पैमाने पर मॉडल डेवलपर और रोबोटिक्स कंपनियों को सेवा देने वाले क्लस्टर की ओर बढ़ रहे हैं।

समान कहानियाँ

असेन्ड 950DT पर 1024 NPU के साथ पहला सुपरपोड क्लस्टर उहान में केवल एक महीने में लॉन्च हुआ
और पढ़ें
pandaily.com

असेन्ड 950DT पर 1024 NPU के साथ पहला सुपरपोड क्लस्टर उहान में केवल एक महीने में लॉन्च हुआ

हुआवेई के 1024 असेन्ड 950DT कार्डों पर निर्मित पहले कंप्यूटिंग क्लस्टर को उहान शहर में सक्रिय किया गया। यह लॉन्च 28 अक्टूबर को हुआ था, जो हुआवेई के हुबेई प्रांत के लिए आर्टिफिशियल इंटेलिजेंस सम्मेलन का हिस्सा था, जो हुआवेई रोड शो 2026 के तहत आयोजित किया गया था।

इस क्लस्टर में निवेश हुबेई प्रांतीय विज्ञान और प्रौद्योगिकी निवेश समूह द्वारा प्रदान किया गया, जो प्रांत का सरकारी निवेशक है। इस समूह के आंकड़ों के अनुसार, परियोजना को काम शुरू होने से लेकर संचालन में आने तक केवल एक महीने का समय लगा, जो इतने बड़े पैमाने की प्रणाली के लिए अपेक्षाकृत कम समय है।

डिप्लॉयमेंट एक एकीकृत लिक्विड-कूल्ड सुपरपोड है। एक नोड में 1024 असेन्ड NPU एक्सेलेरेटर कार्ड लगे हैं। कम्प्यूटेशनल और इंटरकनेक्ट कैबिनेट दोनों तरल शीतलन प्रणालियों से पूरी तरह सुसज्जित हैं। यह सिस्टम FP8 प्रारूप में 1 EFLOPS प्रदर्शन प्रदान करने में सक्षम है और इसमें 256 TB वैश्विक रूप से एकीकृत मेमोरी है। कार्डों के बीच थ्रूपुट टेराबाइट प्रति सेकंड तक पहुंचता है, और एंड-टू-एंड विलंबता माइक्रोसेकंड होती है।

डिज़ाइन आर्किटेक्चर यूनिफाइडबस पर आधारित है, जो सुपरपोड के लिए हुआवेई की आंतरिक इंटरकनेक्शन आर्किटेक्चर है। यह तकनीक क्लस्टर में प्रत्येक कार्ड को अन्य कार्डों तक सीधे पहुंचने की अनुमति देती है, जिससे 1024 NPU कई अलग-अलग सर्वरों के बजाय एक बड़े त्वरक के रूप में कार्य करते हैं जो मानक नेटवर्क के माध्यम से जुड़े होते हैं। हुआवेई इस इंस्टॉलेशन को ट्रिलियन पैरामीटर वाले मॉडल को प्रशिक्षित करने और एआई एजेंटों के इन्फेरेंस को चलाने के लिए लक्षित करती है।

सुपरपोड दृष्टिकोण का मुख्य लाभ सीधा एक्सेस है। बड़े मॉडल को प्रशिक्षित करते समय, काफी समय चिप्स के बीच डेटा स्थानांतरित करने में खर्च होता है। पूरे पॉड और उसके भीतर इंटरकनेक्ट आर्किटेक्चर में एकीकृत मेमोरी बनाए रखने से उस ट्रैफ़िक की मात्रा कम हो जाती है जिसे धीमी चैनलों के माध्यम से गुजरना पड़ता है।

क्लस्टर स्थानीय जरूरतों को पूरा करने के लिए डिज़ाइन किया गया है। इसका उद्देश्य हुबेई में मॉडल डेवलपर्स और कंपनियों को बड़े मॉडल को प्रशिक्षित करने के लिए कंप्यूटिंग क्षमताओं का एक सुलभ स्रोत प्रदान करना है, साथ ही उद्योग-विशिष्ट एआई एजेंटों के निर्माण, ट्यूनिंग और संचालन के लिए भी उपलब्ध कराना है। स्थानीय स्रोतों ने उल्लेख किया है कि यह प्रांत में उच्च-प्रदर्शन कंप्यूटिंग आपूर्ति में कमी को पूरा करता है।

उहान में लॉन्च असेन्ड 950 पीढ़ी के प्रारंभिक व्यावहारिक कार्यान्वयन का भी प्रतीक है। इसी साल हुआवेई ने असेन्ड 950 पर आधारित भौतिक सुपरपोड का प्रदर्शन किया था और तब बताया था कि पिछले पीढ़ी के 750 से अधिक असेन्ड 384 सुपरपोड वाणिज्यिक रूप से तैनात किए जा चुके थे। उहान में 950DT क्लस्टर प्रदर्शनकारी उपकरण से क्षेत्रीय एआई कंप्यूटिंग केंद्रों में नई सुपरपोड संरचना के संक्रमण को दर्शाता है।

हुआवेई ने क्लस्टर की ऊर्जा खपत या उपयोग के विस्तृत आंकड़े जारी नहीं किए हैं; ऊपर दिए गए संख्यात्मक मान लॉन्च कार्यक्रम में बताए गए थे।

मूर थ्रेड्स ने अपने स्वयं के जीपीयू पर ट्रिलियन पैरामीटर वाले MoE मॉडल को प्रशिक्षित करने के लिए मेगैट्रॉन-म्यूसा-टाइटन जारी किया
और पढ़ें
pandaily.com

मूर थ्रेड्स ने अपने स्वयं के जीपीयू पर ट्रिलियन पैरामीटर वाले MoE मॉडल को प्रशिक्षित करने के लिए मेगैट्रॉन-म्यूसा-टाइटन जारी किया

मूर थ्रेड्स ने मेगाट्रॉन-म्यूसा-टाइटन प्रोजेक्ट को सार्वजनिक कर दिया है, जिसमें बड़े मॉडल को प्रशिक्षित करने के लिए बुनियादी ढांचा प्रस्तुत किया गया है जिसे उन्होंने अपने स्वयं के ग्राफिक्स प्रोसेसिंग यूनिट्स पर उपयोग के लिए विकसित किया है। यह प्रोजेक्ट मूर थ्रेड्स के 10,000 से अधिक जीपीयू वाले क्लस्टरों पर ट्रिलियन पैरामीटर वाले 'एक्सपर्ट्स का मिश्रण' (mixture-of-experts) प्रकार के मॉडलों के साथ काम करने के लिए डिज़ाइन किया गया है, और इसमें प्री-ट्रेनिंग और रीइन्फोर्समेंट लर्निंग दोनों शामिल हैं।

प्रोजेक्ट का कोड गिटहब पर उपलब्ध है। कंपनी का दावा है कि इस सिस्टम का लगातार उपयोग 10,000 जीपीयू के क्लस्टरों पर ट्रिलियन पैरामीटर वाले MoE की प्री-ट्रेनिंग के लिए किया गया था, जहां लंबे प्रशिक्षण सत्रों ने मॉडल के FLOPs के उच्च उपयोग और प्रक्रिया की स्थिरता सुनिश्चित की।

रिपॉजिटरी में 1 ट्रिलियन पैरामीटर वाले Kimi-K2 शैली के MoE मॉडल के लिए एक कॉन्फ़िगरेशन उदाहरण प्रस्तुत किया गया है। डिजाइन का केंद्रीय सिद्धांत मौजूदा समाधानों के करीब रहना था। मेगाट्रॉन-म्यूसा-टाइटन NVIDIA के मेगाट्रॉन-एलएम फ्रेमवर्क पर बनाया गया है। torch_musa के माध्यम से PyTorch के एकीकरण और MUSA C की CUDA C के साथ संगतता के कारण, MUSA वातावरण वाले डेवलपर्स आधिकारिक मेगाट्रॉन-एलएम, स्लाइम और माइल्स रिपॉजिटरी को क्लोन कर सकते हैं और स्रोत कोड को संशोधित किए बिना मूर थ्रेड्स जीपीयू पर प्रशिक्षण शुरू कर सकते हैं।

प्रोजेक्ट इंगित करता है कि सामान्य एल्गोरिदम और बग फिक्स को उच्च स्तरीय परियोजनाओं में भेजा जाना चाहिए, जबकि मूर थ्रेड्स दो प्रकार के परिवर्तनों पर ध्यान केंद्रित करता है: हार्डवेयर और मूर थ्रेड्स क्लस्टरों के लिए अनुकूलित बड़े पैमाने पर अनुकूलन, और MUSA की विशिष्ट समस्याओं के लिए वर्कअराउंड।

प्री-ट्रेनिंग सुविधाओं में FP8 प्रारूप में ब्लॉक ट्रेनिंग शामिल है, जो मूर थ्रेड्स के MT-TransformerEngine पर निर्भर करता है। MoE टोकन डिस्पैचिंग और फ्यूजन को कंपनी के Async Copy Engine पर चलने वाले DeepEP द्वारा तेज किया जाता है, जो गणनाओं के समानांतर विशेषज्ञ संचार की भी अनुमति देता है। अन्य विकल्पों में वर्चुअल पाइपलाइन समानांतरवाद का उपयोग करके एक्टिवेशन ऑफलोडिंग और एक फॉरवर्ड पास और एक बैकवर्ड पास की शेड्यूलिंग, साथ ही Mooncake RDMA के माध्यम से गणनाओं के साथ पाइपलाइन समानांतर संचार शामिल है।

वितरित ट्रेसिंग विश्लेषण टूल प्रत्येक जीपीयू से PyTorch ट्रेस को पढ़कर पाइपलाइन बबल्स और कम प्रदर्शन वाले नोड्स जैसे बाधाओं का पता लगाता है। प्रोजेक्ट का दावा है कि यह 10,000 जीपीयू पर 1 ट्रिलियन पैरामीटर वाले MoE रन का विश्लेषण केवल कुछ घंटों में कर सकता है।

रीइन्फोर्समेंट लर्निंग के लिए, स्टैक स्लाइम और माइल्स फ्रेमवर्क का समर्थन करता है; मेगाट्रॉन प्रशिक्षण संभालता है, और MUSA-बिल्ड SGLang रन उत्पन्न करता है, जिससे एक ही आधार प्रणाली प्री-ट्रेनिंग और RL दोनों को सेवा दे सकती है। स्वायत्त इन्फेरेंस के लिए अनुकूलन इस प्रोजेक्ट के दायरे में नहीं आता है।

उन डेवलपर्स के लिए जो घरेलू एक्सेलेरेटर पर विचार कर रहे हैं, व्यावहारिक प्रश्न यह है कि मौजूदा प्रशिक्षण कोड का कितना हिस्सा काम करेगा। मूर थ्रेड्स का उत्तर है कि मेगाट्रॉन इकोसिस्टम का कोड किसी संशोधन की मांग नहीं करता है।

SpacemiT ने Kunlunxin M100 और Linux समर्थन के साथ RISC-V आर्किटेक्चर पर V100 सर्वर प्रोसेसर प्रस्तुत किया
और पढ़ें
pandaily.com

SpacemiT ने Kunlunxin M100 और Linux समर्थन के साथ RISC-V आर्किटेक्चर पर V100 सर्वर प्रोसेसर प्रस्तुत किया

SpacemiT कंपनी ने अपना सर्वर प्रोसेसर V100 स्वतंत्र रूप से जारी नहीं किया था। चीन में शेंझेन में 19 अक्टूबर को आयोजित RISC-V समिट में, कंपनी ने ओपन प्रोसेसर टीम XiangShan के साथ मिलकर इस चिप के आसपास निर्मित तीन तैयार सर्वर प्रस्तुत किए। इन सिस्टमों में एक्सेलेरेटर सत्यापन और ऑपरेटिंग सिस्टम समर्थन शामिल है, जिसका उद्देश्य डेटा केंद्रों में RISC-V पर आधारित मशीनों को लागू करना है।

प्रस्तुत किए गए तीन उपकरणों में कंप्यूटिंग सर्वर C2201, एआई सर्वर G5201 और स्टोरेज सर्वर S5236 शामिल हैं। वे सामान्य प्रयोजन कार्यों, आर्टिफिशियल इंटेलिजेंस त्वरण और बड़े पैमाने पर डेटा भंडारण की समस्याओं को हल करने के लिए डिज़ाइन किए गए हैं। सर्वर G5201 आठ पूर्ण आकार और पूर्ण लंबाई के डबल-विड्थ एक्सेलेरेटर कार्ड से लैस है और उच्च गति वाले क्लस्टर नेटवर्क RDMA का भी समर्थन करता है। SpacemiT पुष्टि करता है कि चिप का परीक्षण घरेलू एक्सेलेरेटर, जिसमें Kunlunxin का M100 शामिल है, का उपयोग करके किया गया था।

इसके अलावा, कंपनी भागीदारों को सर्वर मदरबोर्ड, फर्मवेयर, BMC प्रबंधन और हार्डवेयर रेफरेंस डिज़ाइन प्रदान करती है, जिससे शून्य से बोर्ड विकसित किए बिना अपने स्वयं के ब्रांडेड मशीनें बनाना संभव हो जाता है।

सॉफ्टवेयर पर महत्वपूर्ण ध्यान दिया गया है। SpacemiT का दावा है कि V100 सिलिकॉन, फर्मवेयर और ऑपरेटिंग सिस्टम में RISC-V सर्वर समाधानों के पांच विनिर्देशों को लागू करता है: RVA23, सर्वर SoC, सर्वर प्लेटफॉर्म, बूट और रनटाइम सेवाएं (BRS) और सुरक्षा मॉडल। कंपनी ने सभी BRS परीक्षणों को सफलतापूर्वक पास करने की सूचना दी है। इसके कारण, openEuler, openRuyi, openKylin, Debian, Ubuntu, Fedora, Red Hat और Rocky Linux जैसे ऑपरेटिंग सिस्टम को सीधे स्थापित, बूट और चलाया जा सकता है।

कई किरायेदार वाले क्लाउड वातावरण के लिए, V100 RISC-V H, AIA और IOMMU एक्सटेंशन का समर्थन करता है, जो सीपीयू, मेमोरी, इंटरप्ट और इनपुट-आउटपुट का हार्डवेयर-स्तरीय वर्चुअलाइजेशन सुनिश्चित करता है। SpacemiT बताता है कि इन वर्चुअलाइजेशन एक्सटेंशनों का पहले से ही लिनक्स में नेटिव समर्थन है, इसलिए कस्टम कर्नेल बनाने की आवश्यकता नहीं है। चिप में एक हार्डवेयर ट्रस्ट रूट, नेटिव RISC-V ट्रस्टेड एग्जीक्यूशन एनवायरनमेंट और RERI RAS समर्थन भी शामिल है। कंपनी क्लाउड में एआई वर्कलोड को न्यूनतम ओवरहेड के साथ अलग करने के तरीके के रूप में V100 पर हल्के माइक्रो-VM की अवधारणा को बढ़ावा देती है, जो कंटेनर के करीब है।

चिप स्वयं 46 कोर के हाइब्रिड डिज़ाइन का उपयोग करता है, जिसमें छह XiangShan Kunminghu V2R2 कोर और 40 SpacemiT X100 कोर शामिल हैं, जो 2.4 गीगाहर्ट्ज़ तक की आवृत्ति पर काम करते हैं। दो ऐसे चिप्स को कुल 92 कोर तक की समग्र प्रदर्शन प्राप्त करने के लिए सुसंगत रूप से जोड़ा जा सकता है। प्रत्येक चिप आठ DDR5 चैनल और 52 PCIe 5.0 लेन का समर्थन करता है। XiangShan को चीनी विज्ञान अकादमी के इंस्टीट्यूट ऑफ कम्प्यूटेशनल टेक्नोलॉजी द्वारा निर्देशित किया जाता है।

SpacemiT V100 को RISC-V सर्वर समाधान विनिर्देशों का पूरी तरह से पालन करने वाला पहला यूनिवर्सल चिप के रूप में स्थापित करता है। संस्थापक और सीईओ चेन झीजियान ने कहा कि यह चिप कंपनी के डिवाइस विकास से क्लाउड प्रौद्योगिकियों में बदलाव का प्रतीक है। यह ध्यान रखना महत्वपूर्ण है कि सभी घोषित विशेषताएं और अनुपालन SpacemiT से आते हैं।

लोकप्रिय