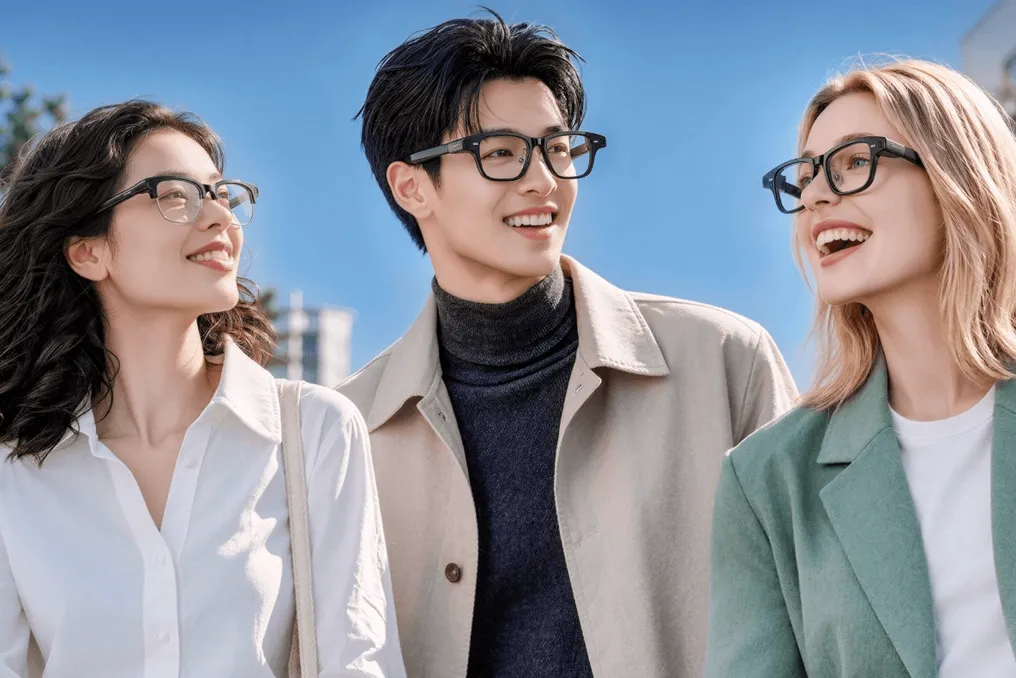
Qwen AI ग्लासेस को कॉल और मीडिया सामग्री अनुवाद सुविधा के साथ ओटीए अपडेट प्राप्त हुआ
और पढ़ें
Pandaily
pandaily.com

Qwen AI ग्लासेस को कॉल और मीडिया सामग्री अनुवाद सुविधा के साथ ओटीए अपडेट प्राप्त हुआ

अलीबाबा ने अपने Qwen AI ग्लासेस के लिए ओवर-द-एयर (OTA) अपडेट जारी किया है, जो 1 नवंबर को उपलब्ध हुआ। आईटी होम की रिपोर्ट के अनुसार, इस अपडेट में कॉल के दौरान अनुवाद और मीडिया सामग्री का अनुवाद करने की सुविधाएँ जोड़ी गई हैं, साथ ही शोर प्रसंस्करण में भी सुधार किया गया है। इससे पहले, 30 अक्टूबर को, Qwen AI ग्लासेस के खाते ने वीबो पर आगामी अपडेट की घोषणा की थी।

कॉल अनुवाद सुविधा फोन कॉल और ऑनलाइन बैठकों के दौरान विभिन्न भाषाओं के बीच वास्तविक समय में अनुवाद प्रदान करती है, जिसका उद्देश्य विदेशी वार्ताकारों के साथ संवाद करना है। मीडिया अनुवाद के संबंध में, यह विदेशी पॉडकास्ट, विदेशी भाषाओं में ऑनलाइन पाठ्यक्रम और विदेशी फिल्मों जैसी सामग्री को कवर करता है।

मीडिया के साथ काम करते समय, ग्लासेस ऑडियो ट्रैक का वास्तविक समय में अनुवाद करते हैं, और प्राप्त अनुवाद उपयोगकर्ता के फोन पर Qwen AI ऐप में सिंक्रोनस रूप से प्रदर्शित होता है; इस प्रकार, चश्मा सुनने का कार्य करता है, और फोन स्क्रीन के रूप में कार्य करता है।

तीसरा बदलाव शोर के प्रति प्रतिरोध में वृद्धि से संबंधित है। अपडेट शोर भरी परिस्थितियों में आवाज की पहचान में सुधार करता है, जिसे कंपनी का दावा है कि यह एक साथ अनुवाद को अधिक सटीक और समय पर बनाता है। स्पष्ट ध्वनि ग्रहण अधिकांश अनुवाद कार्यों के लिए महत्वपूर्ण है, खासकर कॉल जैसे स्ट्रीमिंग परिदृश्यों में जहां वक्ता सिस्टम द्वारा संसाधित होने की प्रतीक्षा किए बिना बोलते रहते हैं।

घोषणा में यह निर्दिष्ट नहीं किया गया था कि कौन से मॉडल इस अपडेट को प्राप्त करेंगे या नई सुविधाओं का समर्थन करने वाली कौन सी भाषाएँ हैं।

यह अपडेट इस वर्ष उत्पाद श्रृंखला के तेजी से विकास के बीच आया है। Qwen AI ग्लासेस G1 मॉडल मार्च में बिक्री के लिए पेश किया गया था, जिसके बाद फ्लैगशिप मॉडल S1 आया, जो G1 की तुलना में इंटरैक्शन, डिस्प्ले, बैटरी जीवन और हार्डवेयर में बेहतर है। 13 अक्टूबर को, Qwen ने N1 श्रृंखला प्रस्तुत की, जिसमें N1 और N1 प्रो मॉडल शामिल हैं। दोनों संस्करणों में 50-मेगापिक्सल सेंसर, 4K में वीडियो रिकॉर्डिंग की क्षमता और ईयरबड्स में बदलने योग्य बैटरी हैं। बैटरी का नाममात्र चलने का समय N1 के लिए 9 घंटे और N1 प्रो के लिए 8 घंटे है। इन उपकरणों में नोट्स और आर्टिफिशियल इंटेलिजेंस का उपयोग करके अनुवाद के लिए अंतर्निहित Qwen एप्लिकेशन शामिल हैं।

N1 प्रो मॉडल में अतिरिक्त रूप से दृष्टि ट्रैकिंग शामिल है, जो 0 से 100,000 लक्स की रोशनी में 1 डिग्री के भीतर केंद्र सटीकता के साथ काम करता है, एंट ग्रुप और क्वालकॉम के साथ संयुक्त रूप से विकसित भुगतान के लिए आइरिस सत्यापन, और हृदय गति, रक्त ऑक्सीजन स्तर और त्वचा के तापमान की निगरानी करता है। साथ ही, Qwen ने एआई के साथ क्लिप-ऑन हेडफ़ोन भी लॉन्च किए हैं, जो वास्तविक समय में अनुवाद, बैठकों में नोट्स लेने और वॉयस कार्यों को भी सक्षम करते हैं।
समान कहानियाँ

Murf AI के सह-संस्थापक का दावा है कि भारत की वॉयस एआई समस्याएं वैश्विक तकनीक को प्रभावित कर सकती हैं
और पढ़ें
yourstory.com

Murf AI के सह-संस्थापक का दावा है कि भारत की वॉयस एआई समस्याएं वैश्विक तकनीक को प्रभावित कर सकती हैं

Murf AI के सह-संस्थापक का मानना है कि भारत में वॉयस आर्टिफिशियल इंटेलिजेंस से जुड़ी जटिलताएं वैश्विक तकनीकी रुझानों को आकार दे सकती हैं। जो बात भारतीय उपयोगकर्ता सामान्य बातचीत मानते हैं, वह वॉयस एआई के लिए सबसे कठिन परीक्षा बन सकती है, और इस चुनौती का समाधान दुनिया भर में नए अवसर खोलेगा।

वॉयस एआई सवालों के जवाब दे सकता है, ऑर्डर की पुष्टि कर सकता है या सीट बुक करने में मदद कर सकता है। हालांकि, एक सवाल उठता है: क्या यह भारतीय नाम का सही उच्चारण कर पाएगा, हिंदी और अंग्रेजी के मिश्रण में बोले गए पते को समझ पाएगा, और स्वाभाविक लगने के लिए पर्याप्त तेज़ी से जवाब दे पाएगा?

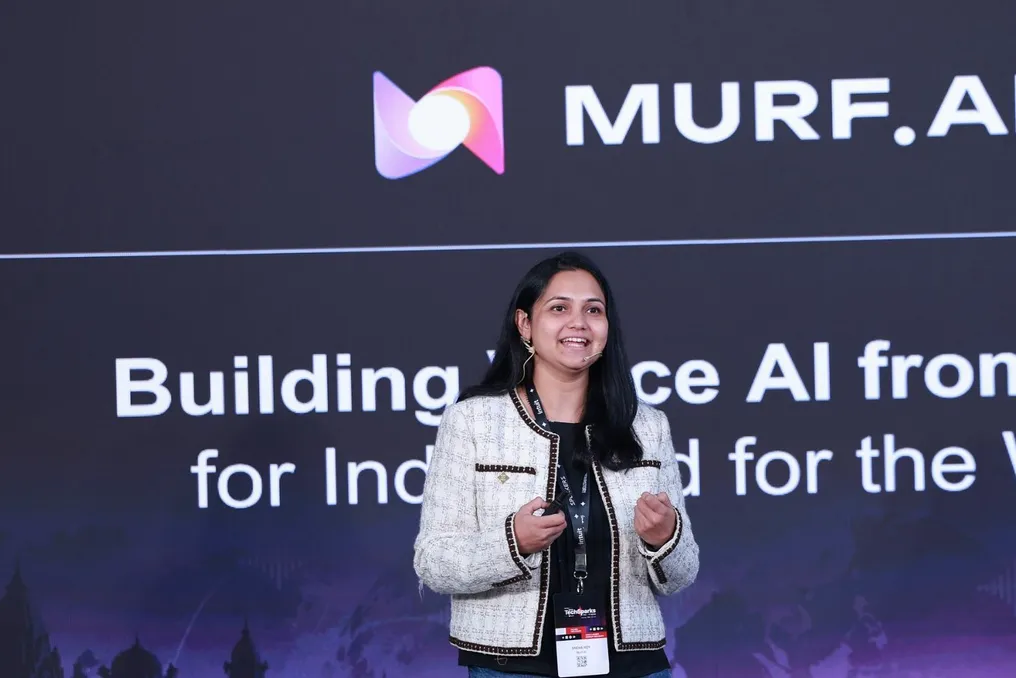
Murf AI के सह-संस्थापक और मुख्य परिचालन अधिकारी स्नेहा रॉय के लिए, ऐसे परिदृश्य असाधारण नहीं हैं; वे एक ऐसे वॉयस एआई के निर्माण के लिए आधार स्तर का प्रतिनिधित्व करते हैं जो भारत में, और अंततः दुनिया भर में काम करेगा।

TechSparks 2026 कार्यक्रम में 'भारत के लिए, भारत से, और दुनिया के लिए वॉयस एआई का निर्माण' नामक मास्टरक्लास के दौरान, रॉय ने समझाया कि भारत की भाषाई जटिलता, बुनियादी ढांचे की सीमाएं और आर्थिक विचार भाषण प्रौद्योगिकी के विकास को कैसे प्रभावित करते हैं।

उन्होंने उन उत्पादों के उदाहरण दिए जो पहले भारतीय उपयोगकर्ताओं के लिए अनुकूलित हुए और फिर व्यापक रूप से उपयोग किए गए। गूगल मैप्स ने सीमित इंटरनेट पहुंच वाले क्षेत्रों के लिए ऑफ़लाइन कार्यक्षमता लागू की, और नेटफ्लिक्स ने एक मोबाइल-ओनली प्लान पेश किया जिसे तब से 78 देशों में अपनाया गया है। उबर ने हैदराबाद में नकद भुगतान का परीक्षण किया, इससे पहले कि उसने इस विकल्प का विस्तार अन्य बाजारों में किया।

रॉय का मानना है कि वॉयस एआई इसी तरह का मार्ग अपना सकता है। उदाहरण के लिए, बेंगलुरु में डिलीवरी की स्थिति की जांच के लिए कॉल करते समय, ग्राहक अंग्रेजी को क्षेत्रीय भाषा के साथ मिला सकता है, पते का स्थानीय उच्चारण उपयोग कर सकता है, और उम्मीद कर सकता है कि पिन कोड अंकों में बोला जाएगा।

मानकीकृत अंग्रेजी पर बनाया गया मॉडल ऐसी बारीकियों के साथ संघर्ष कर सकता है। रॉय ने जोर देकर कहा: 'यदि ग्राहक को एजेंट द्वारा संभालने के लिए अपनी बोलने की शैली बदलनी पड़ती है, या लगातार अपना पता या नाम दोहराना पड़ता है, तो इसका मतलब है कि हमने इसे विकसित करना अभी समाप्त नहीं किया है।'

उनके विचार में, चुनौती ऐसी प्रणालियाँ बनाना है जो लोगों की प्राकृतिक बोलने की शैली को ध्यान में रखें, न कि ग्राहकों से प्रौद्योगिकी के अनुकूल होने की मांग करें।

प्राकृतिक भाषण केवल समस्या का एक हिस्सा है। वॉयस एजेंटों को तेजी से प्रतिक्रिया देनी चाहिए और बड़े पैमाने पर प्रभावी ढंग से काम करना चाहिए जब कंपनियां हर महीने लाखों कॉल संसाधित करती हैं। रॉय ने बताया कि स्पीच रिकग्निशन, लैंग्वेज मॉडल और स्पीच जनरेशन सहित पूरे वॉयस एजेंट पाइपलाइन का सामान्य प्रतिक्रिया बजट 500 से 800 मिलीसेकंड होता है। उन्होंने जोड़ा कि Murf ने नेटवर्क विलंबता सहित अपने टेक्स्ट-टू-स्पीच मॉडल की देरी को 100 मिलीसेकंड से नीचे लाने में सफलता प्राप्त की है।

इस लक्ष्य को प्राप्त करने के लिए, कंपनी ने Falcon 2 विकसित किया - एक छोटा स्पीच मॉडल जिसे विशिष्ट, उच्च-प्रदर्शन हार्डवेयर पर निर्भर रहने के बजाय व्यापक ग्राफिक्स प्रोसेसर रेंज पर काम करने के लिए डिज़ाइन किया गया है। रॉय ने उल्लेख किया कि इस दृष्टिकोण ने विभिन्न भौगोलिक क्षेत्रों में कम विलंबता बनाए रखने में मदद की, साथ ही आर्थिक दक्षता भी बढ़ाई।

इसी तरह के इंजीनियरिंग समाधान भारत के बाहर के बाजारों के लिए उपयोगी हो सकते हैं, खासकर उन जगहों पर जहां कंप्यूटिंग बुनियादी ढांचा सीमित है या बड़े पैमाने पर वॉयस एजेंटों की तैनाती महंगी बनी हुई है।

रॉय ने वॉयस डेटा के प्रति जिम्मेदार दृष्टिकोण के महत्व पर भी जोर दिया। उन्होंने उल्लेख किया कि Murf रॉयल्टी-आधारित दीर्घकालिक साझेदारी के तहत दुनिया भर के 400 से अधिक वॉयस एक्टर्स के साथ सहयोग करता है और सहमति के बिना आवाज़ों की क्लोनिंग नहीं करता है।

गोपनीयता की सख्त आवश्यकताओं वाले ग्राहकों के लिए, कंपनी एपीआई प्रदान करती है जो डेटा को संग्रहीत किए बिना संसाधित कर सकते हैं, साथ ही संवेदनशील अनुप्रयोगों के लिए स्थानीय परिनियोजन भी प्रदान करती है। रॉय का केंद्रीय तर्क यह है कि भारत की भाषाई विविधता और बुनियादी ढांचागत सीमाएं गौण आवश्यकताएं नहीं होनी चाहिए; वे यह निर्धारित करने में मदद कर सकती हैं कि वॉयस एआई को व्यापक रूप से अपनाने से पहले क्या करना चाहिए। जैसा कि उन्होंने कहा: 'भारत दुनिया के विनिर्देशों की राजधानी है।'

एंटी ग्रुप ने मिन्ग-3.0-टीटीएस जारी किया: आवाज नियंत्रण के साथ छोटे स्पीच सिंथेसिस मॉडल
और पढ़ें
pandaily.com

एंटी ग्रुप ने मिन्ग-3.0-टीटीएस जारी किया: आवाज नियंत्रण के साथ छोटे स्पीच सिंथेसिस मॉडल

एंटी ग्रुप की इनक्लूजनएआई टीम ने मिन्ग-3.0-टीटीएस - भाषण उत्पन्न करने के लिए मॉडलों का एक परिवार - को सार्वजनिक रूप से जारी किया है, जिसका उद्देश्य स्थानीय परिनियोजन के लिए पर्याप्त कॉम्पैक्ट होने वाले मॉडलों में आवाज पर विस्तृत नियंत्रण सुनिश्चित करना है। कोड, कार्य दिशानिर्देश और मूल्यांकन तालिकाएँ गिटहब पर उपलब्ध हैं, जबकि वज़न हगिंग फेस और मॉडलस्कोप पर रखे गए हैं, और सभी सामग्री एमआईटी लाइसेंस के तहत वितरित की जाती है।

इस रिलीज़ में दो मॉडल शामिल हैं। मिन्ग-3.0-टीटीएस-0.5बी लगभग आधा बिलियन पैरामीटर वाला एक सघन मॉडल है। मिन्ग-3.0-टीटीएस-टिनी एंटी के लिंग वी3 आर्किटेक्चर पर बनाया गया एक मिक्सचर-ऑफ-एक्सपर्ट्स प्रकार का मॉडल है, जिसमें कुल मिलाकर 7.9 बिलियन पैरामीटर हैं, जिनमें से प्रत्येक टोकन के लिए 1.3 बिलियन सक्रिय होते हैं। दोनों मॉडल एक ही जनरेटिव संरचना का उपयोग करते हैं: एक भाषा मॉडल, जिसे विशिष्ट कार्य टोकन और पाठ द्वारा नियंत्रित किया जाता है, जो DiT पैच-हेड और ऑडियो-टोकनाइज़र को प्रभावित करता है।

इन मॉडलों की क्षमताएं व्यापक हैं। उपयोगकर्ता संदर्भ आवाज क्लोन कर सकते हैं, पाठ विवरण के आधार पर नई आवाज बना सकते हैं, या 100 से अधिक अंतर्निहित चीनी आवाजों और पांच अंग्रेजी आवाजों में से चुन सकते हैं। भाषण को प्राकृतिक भाषा निर्देशों का उपयोग करके नियंत्रित किया जा सकता है, और भावना, गति, पिच और वॉल्यूम जैसे मापदंडों को सीधे समायोजित किया जा सकता है। चौदह अंतर्निहित टैग चीनी और अंग्रेजी दोनों भाषाओं में हंसी, आहें और अन्य मुखर ध्वनियों को सम्मिलित करने की अनुमति देते हैं। मॉडल चीनी, अंग्रेजी, जर्मन, स्पेनिश, फ्रेंच, कोरियाई और जापानी भाषाओं के साथ-साथ सिचुआन और कैंटोनीज़ का समर्थन करते हैं।

टिनी मॉडल अतिरिक्त रूप से स्क्रिप्ट और आवाज नमूनों के अनुसार उत्पन्न बहु-वक्ता संवादों का समर्थन करता है, जो लंबी पॉडकास्ट शैली में ऑडियो बनाने पर केंद्रित है। टीम बताती है कि ये क्षमताएं मनमाने संयोजनों के बजाय अलग-अलग कार्य मोड के रूप में कार्य करती हैं।

रिपॉजिटरी के अनुसार, मिन्ग-3.0-टीटीएस आर्टिफिशियल एनालिसिस कंट्रोल्ड वॉइस रैंकिंग में ओपन-वेट मॉडल में पहले स्थान पर रहा और उच्चारण स्थिरता स्कोर में समग्र रूप से पहला स्थान प्राप्त किया, अक्टूबर 2026 तक 93.2% सही ढंग से बोले गए खंडों को प्राप्त किया। हालांकि, टीम चेतावनी देती है कि नए मॉडल जोड़े जाने पर ये रैंकिंग बदलती रहती हैं। खुले बेंचमार्क पर, मॉडल एनवीबेंच के छह पैरालिंग्विस्टिक मेट्रिक्स में सूचीबद्ध ओपन-सोर्स मॉडलों में अग्रणी प्रदर्शन प्रदर्शित करता है, 0.5बी मॉडल के लिए कैंटोनीज़ बेसलाइन सेट पर त्रुटि आवृत्ति और टिनी मॉडल के लिए जर्मन और स्पेनिश में शब्द त्रुटि आवृत्ति के मामले में भी।

README फ़ाइल में कमजोरियों का ईमानदारी से उल्लेख भी किया गया है। हाल ही में जोड़े गए भाषाओं में आवाज समानता मुख्य रूप से शीर्ष तीन में नहीं आती है, पिच नियंत्रण सबसे कम सटीक विशेषता है, कोरियाई मॉडल टिनी की त्रुटि दर छोटी मॉडल से काफी पीछे है, और पॉडकास्ट के लिए ऑडियो गुणवत्ता अभी भी पिछले रिलीज मिन्ग-ओमनी-टीटीएस से पीछे है। रोडमैप में अगले कदमों के रूप में vLLM-Omni का त्वरित आउटपुट और तकनीकी रिपोर्ट सूचीबद्ध हैं। परियोजना उपयोगकर्ताओं से अनुरोध करती है कि वे सहमति के बिना वास्तविक लोगों की आवाज़ों को क्लोन न करें और सिंथेटिक भाषण को वहां लेबल करें जहां इसे वास्तविक रिकॉर्डिंग समझा जा सकता है।

लोकप्रिय