CASIA के शोधकर्ताओं ने स्पर्श संवेदक की मदद से रोबोट द्वारा पुर्जों को डालने की सफलता दर बढ़ाई
और पढ़ें
Pandaily
pandaily.com

CASIA के शोधकर्ताओं ने स्पर्श संवेदक की मदद से रोबोट द्वारा पुर्जों को डालने की सफलता दर बढ़ाई

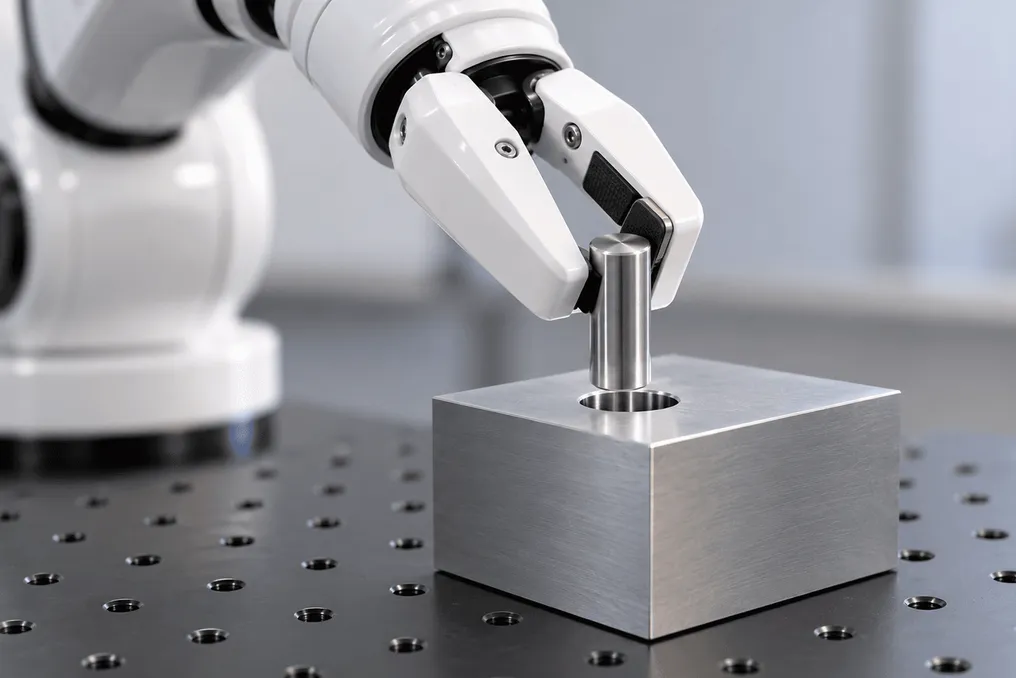
चाइना एकेडमी ऑफ साइंसेज (CASIA) के ऑटोमेशन इंस्टीट्यूट के शोधकर्ताओं की एक टीम ने प्रदर्शित किया है कि उंगलियों के सिरे पर स्पर्श प्रतिक्रिया जोड़ने से सब-मिलीमीटर गैप वाले छेदों में पुर्जों को डालने की रोबोटिक हाथ की क्षमता में काफी सुधार होता है।

लॉन्ग चेन की टीम द्वारा किए गए इस काम, जिसमें शिनपान मेन, हौचेन ली और झेनहुआ मा जैसे लेखकों ने भाग लिया, को IROS 2026 सम्मेलन में स्वीकार किया गया और 'फ्रॉम रीच टू इंसर्ट: सब-मिलीमीटर टॉलरेंस के तहत स्पर्श-संवर्धित सटीक असेंबली' शीर्षक से arXiv पर प्रकाशित किया गया।

कम सहनशीलता वाले छेदों में पुर्जों को सटीक रूप से डालना एक जटिल कार्य है, क्योंकि स्थिति में छोटी सी त्रुटि जाम या अत्यधिक संपर्क बलों का कारण बन सकती है, और कैमरे अक्सर पिन के छेद के करीब आने पर पकड़ और स्वयं पुर्जे द्वारा अवरुद्ध हो जाते हैं।

टीम ने इस कार्य को दो चरणों में विभाजित किया। पहले, डिफ्यूजन पॉलिसी का उपयोग करके सिम्युलेटेड लर्निंग विधि से प्रशिक्षित एक पहुंच नीति, यादृच्छिक रूप से रखे गए पिन को पकड़ती है और उसे छेद के पास लाती है। फिर, सॉफ्ट एक्टर-क्रिटिक पर आधारित एक रीइन्फोर्समेंट लर्निंग नीति, डालने की प्रक्रिया को निष्पादित करती है और संपर्क के दौरान विफलताओं से उबरने में सक्षम होती है।

प्रशिक्षण प्रक्रिया में एक असममित एक्टर-क्रिटिक संरचना का उपयोग किया जाता है। एक्टर मुख्य रूप से दृश्य डेटा पर निर्भर करता है, जो डालने के लिए नीति की प्रभावशीलता सुनिश्चित करता है, जबकि क्रिटिक कार्रवाई का अधिक सटीक मूल्यांकन करने के लिए स्पर्श प्रतिक्रिया प्राप्त करता है। चूंकि प्रत्येक पकड़ सेंसर पर एक अलग प्रारंभिक रीडिंग छोड़ती है, इसलिए सिस्टम पहले संपर्क से पहले स्पर्श आधार रेखा का मूल्यांकन करता है, और क्रिटिक इस आधार रेखा के सापेक्ष परिवर्तन के साथ काम करता है। इसके अलावा, टीम टॉर्क रीडिंग के अनुसार प्रशिक्षण नमूनों को समूहित करती है और समूहों में नमूनों को समान रूप से वितरित करती है ताकि नीति संपर्क की स्थितियों की एक व्यापक श्रृंखला देख सके।

प्रयोग के लिए 7 डिग्री ऑफ फ्रीडम वाला फ्रैंका एमिका पांडा रोबोटिक आर्म का उपयोग किया गया था, जिसे उंगली के सिरे पर पैक्सिनी PX-6AX GEN3 छह-अक्षीय स्पर्श संवेदक, कलाई पर स्थापित इंटेल रियलसेंस कैमरा और सामान्य अवलोकन के लिए दूसरे रियलसेंस कैमरे से लैस किया गया था। यह संवेदक पैक्सिनी टेक के साथ अनुसंधान सहयोग के हिस्से के रूप में प्रदान किया गया था।

परीक्षण पांच विभिन्न छेद आकृतियों पर किए गए: चौकोर, गोलाकार, षटकोणीय, एल-आकार और त्रिकोणीय, 1 मिमी, 0.25 मिमी और 0.05 मिमी के सहनशीलता के साथ। केवल सिमुलेटेड लर्निंग का उपयोग करते हुए, 1 मिमी गैप पर औसत सफलता दर 76% थी, लेकिन यह 0.25 मिमी पर 24% और 0.05 मिमी पर 0% तक गिर गई। 0.05 मिमी गैप पर, स्पर्श संवेदक का उपयोग किए बिना रीइन्फोर्समेंट लर्निंग के साथ सिम्युलेटेड लर्निंग 52% मामलों में सफल रहा। हालांकि, स्पर्श क्रिटिक और नमूना समूहन के कारण सफलता बढ़कर 67% हो गई, जबकि इंटरैक्शन बल में चरम शक्ति 60% और चरम टॉर्क में 44% कम हो गई।
समान कहानियाँ

अलीबाबा के Amap मॉडल ने मानव गतिविधियों के आधार पर पूरे शरीर के कार्यों को सीखने वाली ह्यूमनॉइड प्रणाली प्रस्तुत की
और पढ़ें
technode.com

अलीबाबा के Amap मॉडल ने मानव गतिविधियों के आधार पर पूरे शरीर के कार्यों को सीखने वाली ह्यूमनॉइड प्रणाली प्रस्तुत की

अलीबाबा ने अलीबाबा टोकन हब के साथ मिलकर λ0 मॉडल प्रस्तुत किया। यह मौलिक मॉडल मानव द्वारा दिखाए गए प्रदर्शनों का उपयोग करके ह्यूमनॉइड रोबोटों को समन्वित गति और हेरफेर सीखने के लिए विकसित किया गया है।

यह प्रणाली पहले व्यक्ति के वीडियो रिकॉर्डिंग पर प्रशिक्षित होती है, जो शरीर और हाथ की गतिविधियों के साथ सिंक्रनाइज़ होती हैं। यह रोबोटों को चलने, मुद्रा को समायोजित करने और दोहरे हाथ के संचालन को मिलाकर अधिक जटिल कार्य करने की अनुमति देता है।

शोधकर्ताओं ने HumanVerse नामक एक डेटासेट बनाया है, जिसमें वास्तविक परिस्थितियों में विभिन्न क्रियाएं करते हुए लोगों की 500 घंटे की रिकॉर्डिंग शामिल है। यह दृष्टिकोण रोबोटों के माध्यम से टेलीऑपरेशन द्वारा प्रदर्शन एकत्र करने की आवश्यकता को कम करता है।

परीक्षण के दौरान, टीम ने प्रदर्शित किया कि λ0 ने वास्तविक दुनिया में लोकोमोशन और हेरफेर से संबंधित कार्यों को करने में 62.5% सफलता दर हासिल की। इस परियोजना ने शोधकर्ताओं को डेटा संग्रह के लिए हार्डवेयर कॉन्फ़िगरेशन कोड और डेटा नमूने भी प्रदान किए।

शेनझेन की स्टार्टअप प्राइमोशन ने Paimon-0 मॉडल पेश किया, कार्यों के निष्पादन समय को 300 मिलीसेकंड तक कम किया
और पढ़ें
pandaily.com

शेनझेन की स्टार्टअप प्राइमोशन ने Paimon-0 मॉडल पेश किया, कार्यों के निष्पादन समय को 300 मिलीसेकंड तक कम किया

प्राइमोशन, शेनझेन का एक स्टार्टअप, जिसे इमोर्टलाइज्ड एआई के लिए चिप्स विकसित करने हेतु जुलाई 2026 में स्थापित किया गया था, ने पहली बार सिलिकॉन के बजाय एक मॉडल के साथ सार्वजनिक क्षेत्र में कदम रखा। QbitAI द्वारा Tencent News पर प्रकाशित विस्तृत रिपोर्ट और The Beijing News की एक पूर्व रिपोर्ट के अनुसार, इसका इमोर्टलाइज्ड फंडामेंटल मॉडल Paimon-0 कई सार्वजनिक रोबोटिक्स बेंचमार्क में पहले स्थान पर रहा।

कंपनी का दावा है कि Paimon-0 ने 0.7754 का परिणाम दिखाया, जिससे यह RoboColiseum लीडरबोर्ड में शीर्ष पर रहा, जहां यह सामान्य मैनिपुलेशन और डिस्टर्बेंस के अनुकूलन के उप-रेटिंग में भी अग्रणी था। मॉडल ने RoboCasa365 में 58.1 अंक प्राप्त किए और VLA-Arena पर 0.73 की औसत सफलता दर प्रदर्शित की। इसके अलावा, इसने दो-हाथ वाले रोबोटों के नीति प्रतियोगिता में 46.599 अंकों के साथ जीत हासिल की। ये सभी परिणाम कंपनी द्वारा प्रस्तुत किए गए हैं।

यह मॉडल एक वर्ल्ड एक्शन मॉडल के आसपास बनाया गया है जो भविष्य की स्थितियों की भविष्यवाणी करता है, जिन्हें फिर रिवर्स डायनेमिक्स मॉडल का उपयोग करके क्रियाओं में परिवर्तित किया जाता है। चूंकि पूर्ण भविष्य के वीडियो को रेंडर करना वास्तविक समय में रोबोटों के लिए बहुत धीमा है, इसलिए Paimon-0 डिवाइस पर कार्रवाई की भविष्यवाणी करने से पहले केवल मुख्य विशेषताओं जैसे 3डी ऑब्जेक्ट पोज़, सिमेंटिक्स और उपयोगिता को निकालने के लिए क्वेरी टोकन का उपयोग करता है। प्राइमोशन के अनुसार, यह प्रति कार्रवाई ब्लॉक के निष्पादन समय को लगभग 3000 मिलीसेकंड से घटाकर 300 मिलीसेकंड कर देता है। कंपनी इस बात पर जोर देती है कि यह ब्लॉक के निष्पादन समय के बारे में है, न कि निम्न-स्तरीय नियंत्रण लूप की अवधि के बारे में। प्री-ट्रेनिंग काफी हद तक पार्टनर EgoScale द्वारा प्रदान किए गए फर्स्ट-पर्सन ह्यूमन मैनिपुलेशन वीडियो पर निर्भर करती है।

सीईओ रेन किंगयुआन, जो पहले RISC-V प्रोसेसर कंपनी के उपाध्यक्ष थे, बताते हैं कि चिप कंपनी ने मॉडल से शुरुआत क्यों की। उनका मानना है कि टीम को पहले वास्तविक ग्राहक कार्यों पर डेटा, मॉडल, एजेंट और मूल्यांकन का पूरा चक्र चलाना चाहिए, और फिर इन वर्कलोड का उपयोग चिप को परिभाषित करने के लिए करना चाहिए। प्राइमोशन क्लाउड प्लानर, जिसे वे मेटा-ब्रेन कहते हैं, और डिवाइस पर स्थानीय ब्रेन के बीच काम विभाजित करता है, जो दृष्टि, स्पर्श और बल से उच्च आवृत्ति वाली प्रतिक्रिया को संसाधित करता है।

हार्डवेयर पर काम शुरू हो गया है। FPGA को रोबोट के मुख्य नियंत्रक में प्री-प्रोसेसिंग और पोस्ट-प्रोसेसिंग के भार को कम करने के लिए जोड़ने के साथ, प्राइमोशन ने 1 kHz की आवृत्ति पर EtherCAT नियंत्रण चक्र में सबसे खराब स्थिति परिदृश्य में त्रुटि को सॉफ्टवेयर मोड में 30 माइक्रोसेकंड से घटाकर 152 नैनोसेकंड कर दिया है। इस तर्क का अधिकांश हिस्सा एक कस्टम चिप में स्थानांतरित करने के लिए है, जिसकी आपूर्ति कंपनी 2028 में शुरू करने की योजना बना रही है।

कंपनी का कहना है कि वह रोबोट के चेसिस नहीं बनाएगी। अपनी प्रगतिशील मॉडल Paimon-Eval का सोर्स कोड नवंबर या दिसंबर में जारी करने की योजना है, और तीन महीने के भीतर फर्स्ट-पर्सन डेटा पर प्रशिक्षित दूसरी मौलिक मॉडल के रिलीज की भी उम्मीद है।

फूडान का रोबोस्किल फ्रेमवर्क रोबोटों को पाठ और कोड के रूप में प्राप्त ज्ञान को पुन: प्रयोज्य कौशल के रूप में सहेजने की अनुमति देता है
और पढ़ें
pandaily.com

फूडान का रोबोस्किल फ्रेमवर्क रोबोटों को पाठ और कोड के रूप में प्राप्त ज्ञान को पुन: प्रयोज्य कौशल के रूप में सहेजने की अनुमति देता है

फूडान विश्वविद्यालय के इंस्टीट्यूट ऑफ एम्बोडीड इंटेलिजेंस की टीम ने रोबोस्किल प्रस्तुत किया है - एक ऐसा फ्रेमवर्क जो सामान्यीकृत रोबोटों को अर्जित ज्ञान को सहेजने की क्षमता प्रदान करता है। प्रत्येक कार्य के लिए नए प्रदर्शन डेटा एकत्र करने के बजाय, एजेंट पहले कार्य का पता लगाता है, और फिर लिखित निर्देशों और निष्पादित कोड से बने कौशल के रूप में एक प्रभावी विधि सहेजता है।

इस शोध, जिसका शीर्षक 'एक्सप्लोर, एग्जीक्यूट, इवॉल्व: ए स्किल एक्विजिशन एंड रियूज लूप फॉर एम्बोडीड एजेंट्स' है, को arXiv पर प्रकाशित किया गया है, और संबंधित कोड GitHub पर उपलब्ध है।

यह कार्य रोबोटिक्स में प्रतिमान परिवर्तन पर आधारित है। दृष्टि, भाषा और क्रियाओं को एकीकृत करने वाले मॉडल पारंपरिक रूप से प्रत्येक तैनाती स्थल से ताज़ा डेटा की मांग करते हैं, और रोबोट से डेटा एकत्र करना मशीनों के टेलीऑपरेशन, दृश्यों को रीसेट करने और प्रदर्शनों को दोहराने की आवश्यकता के कारण महंगा होता है।

टीम ने पाया कि आधुनिक मल्टीमॉडल एजेंट अवलोकन कर सकते हैं, तर्क कर सकते हैं और सीधे संचालन प्रक्रिया के दौरान नियंत्रण कोड लिख सकते हैं। सिमुलेशन परीक्षण वातावरण LIBERO-10 में, चार घंटे के बजट और कई प्रयासों के साथ, सर्वश्रेष्ठ एजेंटों ने सौ प्रतिशत सफलता हासिल की। वास्तविक रोबोट पर काम करते समय, सबसे मजबूत एजेंट ने 91.7 प्रतिशत सरल कार्यों और 80 प्रतिशत जटिल कार्यों को सफलतापूर्वक पूरा किया।

मुख्य समस्या गति बनी हुई है। चूंकि एजेंट अवलोकन, तर्क, कार्रवाई और सत्यापन के चरणों से चक्रीय रूप से गुजरते हैं, इसलिए छोटे हाथ आंदोलनों के बीच तर्क प्रक्रिया में मिनट लग सकते हैं। सिमुलेशन रन की औसत अवधि 94.5 मिनट थी, और वास्तविक रोबोट पर कार्यों को सफलतापूर्वक पूरा करने में 20 से 27 मिनट लगते थे।

रोबोस्किल इस समस्या का समाधान दो तरीकों से करता है। पहला, यह स्पर्शनीय संवेदनाएं जोड़ता है। दबाव, बल और टॉर्क रीडिंग एजेंट को ग्रिप संपर्क के बारे में सूचित करती हैं, जिससे लगातार छवियों की जांच करने की आवश्यकता समाप्त हो जाती है। स्पर्शनीय डेटा जोड़ने के बाद, एक एजेंट के सिमुलेशन का औसत समय 25.35 मिनट से घटकर 15.93 मिनट हो गया, और वास्तविक रोबोट पर टेस्ट ट्यूब से निकालने का कार्य 33.63 मिनट से घटकर 20 मिनट हो गया।

दूसरा, फ्रेमवर्क कौशल जमा करता है। कार्य पूरा होने के बाद, एजेंट जो हुआ उसका विश्लेषण करता है और प्रभावी विधि का दस्तावेजीकरण करता है, जिसके बाद वह बाद के परिणामों के आधार पर इसे अद्यतन करना जारी रखता है। उदाहरण के लिए, संपर्क के माध्यम से मेज की ऊंचाई निर्धारित करने की विधि का उपयोग नई सेटिंग में भी किया जा सकता है, भले ही ऊंचाई को फिर से मापा जाना हो। कौशल के पुन: उपयोग ने एक एजेंट के सिमुलेशन के औसत समय को 94.5 मिनट से घटाकर 35.9 मिनट कर दिया।

कोड को पाठ के साथ सहेजना सबसे महत्वपूर्ण था। केवल पाठ पर आधारित कौशल से पाठ और कोड सहित कौशल में बदलाव ने चारों परीक्षण किए गए एजेंटों के लिए औसत समय को कम कर दिया। उनमें से एक के लिए समय 67.1 मिनट से घटकर 39.9 मिनट हो गया, और पहली कोशिश में सफलता दर 15 प्रतिशत से बढ़कर 67.5 प्रतिशत हो गई। कुल मिलाकर, टीम LIBERO-10 पर पहले दौर में सफलता में 12.5 से 25 अंकों की वृद्धि, सिमुलेशन समय में 7.6 से 72.4 प्रतिशत की बचत और वास्तविक रोबोट पर सफलता में 8.3 अंकों की वृद्धि की सूचना देती है। शोधकर्ताओं ने उल्लेख किया कि कौशल विभिन्न कार्यों और विभिन्न एजेंट मॉडल के बीच भी स्थानांतरित किए जा सकते हैं।

लोकप्रिय