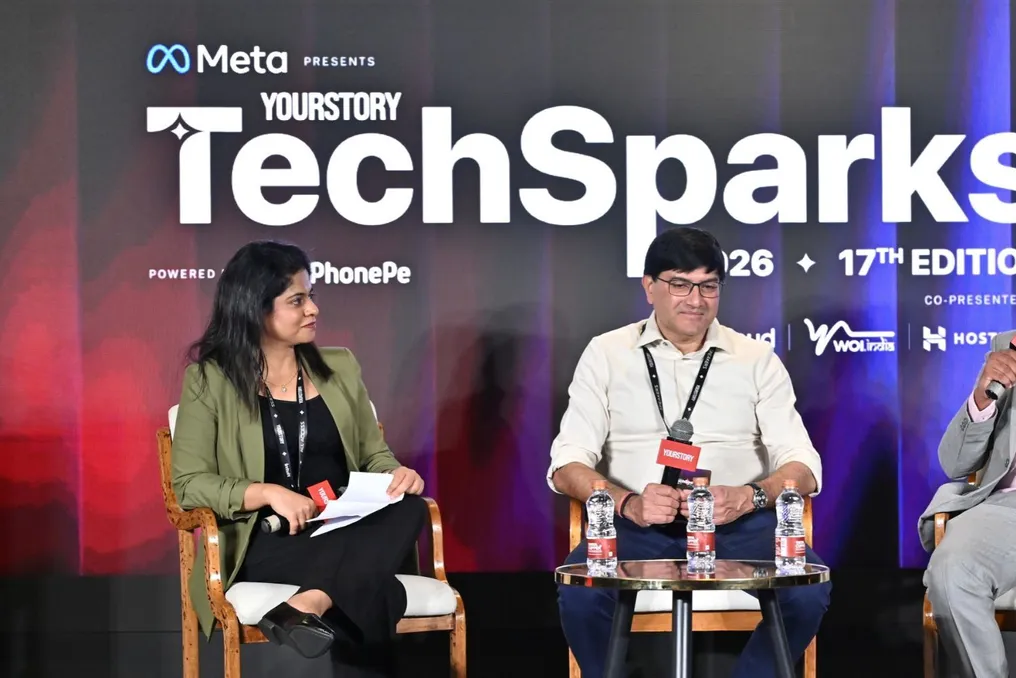
तकनीकी बुनियादी ढांचे पर चर्चा करते समय आमतौर पर सेमीकंडक्टर, डेटा सेंटर और आर्टिफिशियल इंटेलिजेंस मॉडल का उल्लेख किया जाता है। हालांकि, विशेषज्ञों की राय के अनुसार, इन तकनीकों के संचालन में आधारभूत डेटा का एक विशाल भंडार महत्वपूर्ण भूमिका निभाता है, जिसे भारत को अभी भी बनाना बाकी है।
टेकस्पार्क्स 2026 कार्यक्रम में 'नई तकनीकी व्यवस्था का अदृश्य बुनियादी ढांचा' विषय पर एक पैनल चर्चा के दौरान, योरस्टोरी की मॉडरेटर चवी महाजन ने विशेषज्ञों को एक साथ लाया। पैनलिस्टों ने इस बात पर जोर दिया कि भारत का लाभ भाषाई एआई और जैव प्रौद्योगिकी जैसे क्षेत्रों में विश्वसनीय, संदर्भ-समृद्ध डेटा के स्वामित्व में निहित होगा।
कोरमेंटल नामक स्टार्टअप के संस्थापक अरविंद पानी, जो एआई के लिए बुद्धिमान डेटा में विशेषज्ञता रखता है, ने कहा कि डेटा तकनीकी स्टैक का वह हिस्सा है जिसे बदला नहीं जा सकता। उन्होंने टिप्पणी की: 'आप कंप्यूटिंग शक्ति को बदलते रह सकते हैं। आप एप्लिकेशन को बदलते रह सकते हैं, लेकिन डेटा को नहीं बदला जा सकता।'
लूपवर्म के सह-संस्थापक और सीईओ अंकित बागारिया, जो कीट जैव प्रौद्योगिकी से संबंधित कंपनी है, ने बताया कि बायोफार्मास्यूटिकल्स के क्षेत्र में यह अंतर विशेष रूप से बड़ा है, जहां काम का एक बड़ा हिस्सा अभी भी ट्रायल और एरर विधि से किया जाता है। उनके अनुसार, बेहतर डेटा बाजार में उत्पाद लाने के समय को कम कर सकता है।
बागारिया ने इस बात पर भी जोर दिया कि जैव प्रौद्योगिकी को एआई, क्वांटम कंप्यूटिंग और चिप्स जितना ही ध्यान दिया जाना चाहिए, खासकर COVID-19 महामारी के बाद। उन्होंने बताया कि भारत अपने प्रमुख सामग्रियों, जिसमें सक्रिय फार्मास्युटिकल संघटक और अभिकर्मक शामिल हैं, का लगभग 73% चीन से आयात करता है। इसके बावजूद, हालांकि देश विश्व स्तर पर टीकों का एक महत्वपूर्ण हिस्सा उत्पादित करता है, यह मूल्य के हिसाब से बाजार का केवल लगभग 5% है।
उन्होंने आगे कहा कि वे लंबे समय तक बायोएनालॉग सेगमेंट में काम कर रहे थे, जबकि अणुओं की खोज कोई और कर रहा था। बागारिया का तर्क था कि अब भारत को दवा विकास की ओर बढ़ना चाहिए।
पानी इस बात से सहमत हुए कि स्थानीय संदर्भ की आवश्यकता भाषाओं पर भी लागू होती है। भारत में इंटरनेट मूल रूप से अंग्रेजी बोलने वाले उपयोगकर्ताओं के लिए बनाया गया था, जिससे अधिकांश नागरिकों के लिए दो बाधाएं पैदा हुईं: उन्हें न केवल तकनीक सीखनी पड़ी, बल्कि नई भाषा भी सीखनी पड़ी। उन्होंने उल्लेख किया कि केवल लगभग 4-5% भारतीय आबादी अंग्रेजी का उपयोग करने में सहज महसूस करती है।
इसके अलावा, पानी ने बताया कि अंग्रेजी भाषा भी एआई के लिए पूरी तरह से हल की गई समस्या नहीं है। मुख्य रूप से अमेरिकी अंग्रेजी पर प्रशिक्षित मॉडल अक्सर ऑस्ट्रेलियाई या क्षेत्रीय लहजे के साथ संघर्ष करते हैं, और विभिन्न राज्यों में बोली जाने वाली अंग्रेजी बहुत भिन्न होती है। उन्होंने निष्कर्ष निकाला: 'ये बारीकियां हैं जिन्हें कोई और नहीं समझेगा, लेकिन भारत समझेगा।'
दोनों वक्ताओं ने सहमति व्यक्त की कि अधिक मात्रा में डेटा हमेशा बेहतर नहीं होता है। पानी ने समझाया कि कम मात्रा में समृद्ध, प्रासंगिक डेटा पर निर्मित एआई मॉडल उन मॉडलों से बेहतर प्रदर्शन करते हैं जो बड़े पैमाने पर कच्चे डेटा पर प्रशिक्षित होते हैं। उन्होंने टिप्पणी की कि कई भारतीय भाषा डेटासेट स्टूडियो से स्क्रिप्ट में रिकॉर्ड किए जाते हैं, इसलिए उन पर प्रशिक्षित मॉडल नियंत्रित परिस्थितियों में अच्छा काम करते हैं, लेकिन वास्तविक बातचीत में विफल हो जाते हैं।
बागारिया ने इस विचार की पुष्टि करते हुए कहा कि जैविक डेटा के संबंध में 'इनपुट में कचरा = आउटपुट में कचरा' का सिद्धांत लागू होता है।
लूपवर्म ने मौजूदा डेटा को साफ करने और रेशम कीट के आंतरिक कामकाज को दर्शाने वाले डिजिटल टूल के निर्माण में लगभग 12-13 महीने खर्च किए। इस काम के लिए भारतीय रेशम कीट के उपभेदों और उन्हें प्रभावित करने वाले रोगजनकों के अनुकूलन की आवश्यकता थी। लूपवर्म टिकाऊ पशु चारा और उच्च मूल्य वाले पुनर्संयोजक प्रोटीन के उत्पादन के लिए रेशम कीटों का उपयोग करता है।
बागारिया ने रेशम कीट के चयन की व्याख्या इस कारण से की कि रेशम 98% से अधिक प्रोटीन से बना होता है, जो इस कीट को प्रकृति में पौधों की पत्तियों को प्रोटीन में बदलने वाले सबसे प्रभावी परिवर्तकों में से एक बनाता है। रेशम कीट को लगभग 4000 साल पहले पालतू बनाया गया था, उसके जीनोम को 2007 में अनुक्रमित किया गया था, और भारत में लगभग 175 संस्थान सेरीकल्चर और उससे जुड़ी जैव प्रौद्योगिकी पढ़ाते हैं।
उन्होंने आगे कहा कि डेटा-आधारित यह दृष्टिकोण पहले 10 महीनों और 25 लाख रुपये के कई प्रयोगों को घटाकर ढाई महीने और लगभग 4.5 लाख रुपये कर चुका है। 'मुझे विश्वास है कि 10 वर्षों में हम सभी कहेंगे कि एआई का सबसे बड़ा प्रभाव जैव प्रौद्योगिकी पर पड़ा है।'
पानी ने उल्लेख किया कि मालिकाना डेटा पहले से ही एक प्रतिस्पर्धात्मक बाधा बन रहा है। उन्होंने हार्वे नामक एक कानूनी फर्म का उदाहरण दिया, जिसने अपनी विषय-विशिष्ट डेटा को मुख्य लाभ के रूप में बनाए रखते हुए अपने मॉडल और कंप्यूटिंग शक्ति दोनों को बदल दिया।
इस बारे में कि क्या बदलना आवश्यक है, पानी ने कहा कि भारत को अपनी जरूरतों के लिए प्रौद्योगिकियां विकसित करनी चाहिए। उन्होंने याद किया कि उनकी पिछली कंपनी ने गूगल से पहले 2011 में क्वाल्कॉम के सहयोग से एंड्रॉइड में भारतीय भाषाओं का समर्थन लागू किया था। 'यदि हम यह सोचते रहेंगे कि कोई और हमारी समस्या का समाधान करेगा, तो हम हमेशा पीछे रहेंगे।'
बागारिया ने BioE3 नीति और अनुसंधान, विकास और नवाचार कोष जैसी सरकारी पहलों का स्वागत किया। हालांकि, उन्होंने बुनियादी डेटा उत्पन्न करने के लिए सरकारी और मौलिक वित्त पोषण बढ़ाने का आह्वान किया, जैसे कि गहन अनुक्रमण और भारतीय जीवों के लक्षण वर्णन के लिए, क्योंकि पारंपरिक निवेशक शायद ही कभी मौलिक विज्ञान को वित्तपोषित करेंगे।