लंबे समय तक, कॉर्पोरेट आर्टिफिशियल इंटेलिजेंस के क्षेत्र में यह धारणा रही है कि मॉडल जितनी अधिक जानकारी संसाधित कर सकता है, उसका परिणाम उतना ही बेहतर होगा। हजारों से लेकर लाखों टोकन तक संदर्भ विंडो के विस्तार के साथ, बड़े डेटा वॉल्यूम को प्रगति से जोड़ा गया। इसके जवाब में, संगठनों ने एआई सहायकों को दस्तावेजों और संवाद इतिहास के पूरे भंडार से लैस करना शुरू कर दिया।
Elastic कंपनी में यह बदलाव स्पष्ट हो गया क्योंकि ग्राहक पायलट परियोजनाओं से पूर्ण संचालन की ओर बढ़ रहे थे। हालांकि, समस्या इस बात में नहीं थी कि एआई अधिक डेटा को संसाधित करने में सक्षम था या नहीं, बल्कि इस बात में थी कि वह वास्तव में आवश्यक डेटा का कितनी सटीकता से विश्लेषण करता है।
टोकनोमिक्स नामक प्रवृत्ति, जो सिलिकॉन वैली में 2026 की शुरुआत में उभरी, एआई टोकन के उपभोग को प्रदर्शन संकेतक के रूप में अधिकतम करने से संबंधित थी। कुछ कंपनियों ने उपयोग किए गए टोकन की संख्या के आधार पर कर्मचारियों के लिए आंतरिक रैंकिंग बनाई, और उच्च खपत अंतिम परिणाम की गुणवत्ता की परवाह किए बिना स्थिति का प्रतीक बन गई। इस प्रवृत्ति की कड़ी आलोचना हुई क्योंकि यह प्राप्त परिणामों के बजाय इनपुट डेटा का मूल्यांकन करती है। जैसा कि भारत में फील्ड इंजीनियरिंग विभाग के प्रमुख रविंद्र रामनानी बताते हैं, यह 'एआई युग में कोड की पंक्तियों की संख्या के आधार पर डेवलपर्स का मूल्यांकन करने के बराबर है'।
एक समान गलती वास्तुकला के स्तर पर भी प्रकट होती है, जब टीमें अनुरोधों में अनावश्यक दस्तावेज़ और बातचीत का इतिहास शामिल करती हैं, यह मानते हुए कि अतिरिक्त जानकारी आउटपुट में सुधार करेगी। मॉडल में योग्य विश्लेषकों की तरह अतिरिक्त सामग्री को फ़िल्टर करने की क्षमता नहीं होती है, जिससे शोर बढ़ता है, प्रतिक्रिया धीमी होती है और परिणामों की महत्वपूर्ण मैन्युअल जांच की आवश्यकता होती है।
यह अंतर तब स्पष्ट हुआ जब संगठनों ने उत्पादन प्रणालियों पर स्विच किया, जहां अपूर्ण संदर्भ के आधार पर कार्य करने वाला एजेंट न केवल अतिरिक्त लागत लाता है, बल्कि गंभीर त्रुटियां भी करता है। रामनानी जोर देते हैं: 'इस प्रकार, संवाद 'हम मॉडल को कितना दे सकते हैं' से हटकर 'मॉडल को वास्तव में क्या जानना चाहिए' के प्रश्न में बदल गया है।' यही प्रश्न संदर्भ इंजीनियरिंग की नींव है।
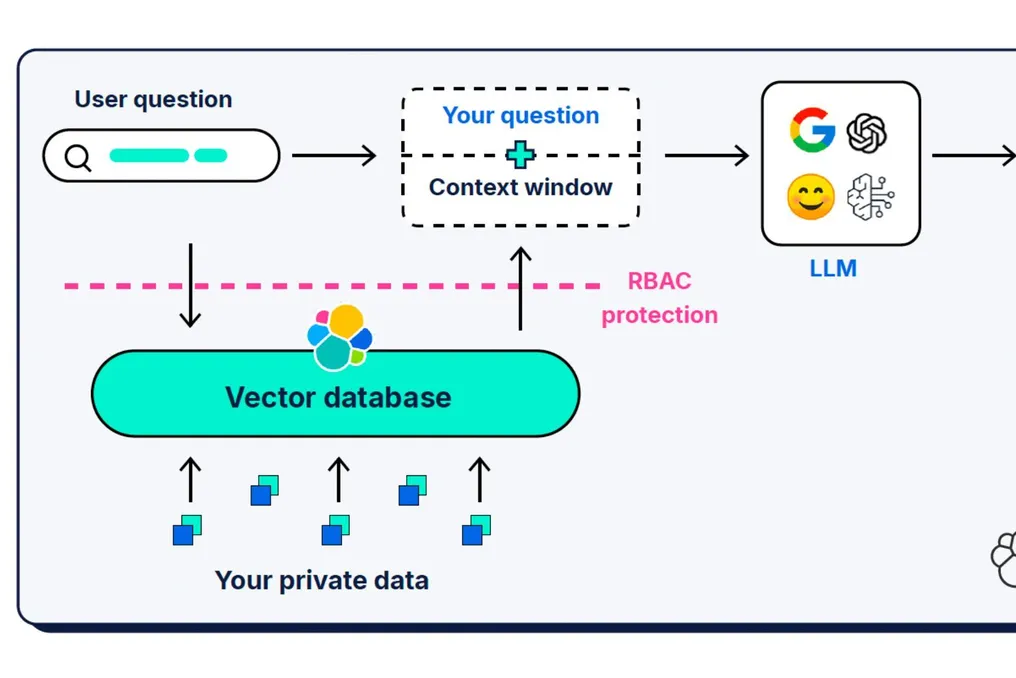
संदर्भ इंजीनियरिंग एक अनुशासन है जो परिभाषित करता है कि तर्क के प्रत्येक चरण में मॉडल कौन सी जानकारी देखता है: कौन से निर्देश कार्य की सीमाओं को निर्धारित करते हैं, कौन से उपकरण उपलब्ध हैं, कॉर्पोरेट सिस्टम से क्या निकाला जाता है, पिछले चरणों से क्या पारित किया जाता है और क्या जानबूझकर बाहर रखा जाता है। कॉर्पोरेट वातावरण में सबसे जटिल हिस्सा सूचना निष्कर्षण की प्रक्रिया है, क्योंकि मॉडल को विश्वसनीय आंतरिक ज्ञान पर भरोसा करना चाहिए, जबकि उस पर अभिभूत नहीं होना चाहिए।
एक साधारण सादृश्य सार को समझने में मदद करता है: टोकनोमिक्स किसी व्यक्ति को वांछित पृष्ठ खोजने के लिए पूरी कार्ड कैटलॉग अलमारी सौंपने जैसा है। संदर्भ इंजीनियरिंग उसे तीन पृष्ठ प्रदान करना है जिनकी उसे वास्तव में आवश्यकता है, पहले से ही चिह्नित। दोनों विकल्पों में एक ही जानकारी होती है, लेकिन केवल एक अधिक सूचित निर्णय लेने की अनुमति देता है।
प्रासंगिकता का महत्व केवल खोज फ़ंक्शन से परे है। यह एक तंत्र है जो स्वायत्त एआई को निर्णय लेने के लिए सुरक्षित बनाता है। जब कोई एजेंट अपूर्ण डेटा के आधार पर तर्क करता है, तो जोखिम न केवल खर्च की गई कम्प्यूटेशनल शक्ति में होता है। बैंकिंग अनुपालन या परिचालन सुरक्षा केंद्र के परिदृश्य में, गलत स्वायत्त कार्रवाई तब तक फैल सकती है जब तक कि कोई व्यक्ति हस्तक्षेप करने में सफल न हो जाए। सही जानकारी कम मात्रा में होनी चाहिए, उच्च सिग्नल स्तर वाली होनी चाहिए और प्राधिकरण के दृष्टिकोण से नियंत्रित होनी चाहिए ताकि एजेंट केवल उसी तक पहुंच सके जिसके लिए उसे अधिकृत किया गया है।
प्रासंगिकता और प्रबंधन का संयोजन एक महंगे पायलट प्रोजेक्ट के विपरीत, एक उत्पादन एजेंट की विश्वसनीयता सुनिश्चित करता है। प्रभावी संदर्भ इंजीनियरिंग तीन स्तरों पर आधारित है: डेटा निकटता, जिसका अर्थ है तर्क परत को सत्य स्रोत के करीब रखना, न कि संवेदनशील डेटा को बाहरी चैनलों के माध्यम से रूट करना; निष्कर्षण सटीकता, जो यह सुनिश्चित करती है कि केवल वही जानकारी प्रस्तुत की जाती है जो दिए गए निर्णय के लिए वास्तविक संकेत है, और Elastic का हाइब्रिड खोज, जो सिमेंटिक रीरैंकिंग के साथ वेक्टर, कुंजी और संरचित खोज को जोड़ता है, केवल जुड़ाव के बजाय प्रासंगिकता सुनिश्चित करता है; और कार्यान्वयन स्थिरीकरण, जिसका अर्थ है प्रत्येक चरण में प्रत्येक एजेंट को उपकरणों के पूर्ण सेट से लैस करने के बजाय मांग पर एजेंट की क्षमताओं को लोड करना, जिससे टोकन ओवरहेड और अनजाने में स्वायत्त कार्रवाई दोनों का जोखिम कम होता है।
Elastic एजेंटों में डेटा निष्कर्षण, टूल निर्माण, वार्तालाप स्थिरीकरण और अवलोकन क्षमता को एक एकीकृत मंच में एकीकृत करता है। यह मंच पूरी तरह से स्थानीय रूप से या अलग-थलग वातावरण में तैनात किया जा सकता है, और बेटर बाइनरी क्वांटाइजेशन जैसी विधियाँ वेक्टर निष्कर्षण डेटा के लिए मेमोरी की मात्रा को 32 गुना तक कम कर सकती हैं, जबकि सटीकता बनाए रखती हैं।
यह व्यवसाय का मामला भी है, इससे पहले कि यह इंजीनियरिंग का मामला बने: व्यावसायिक टीमों को यह परिभाषित करने की आवश्यकता है कि सफलता कैसी दिखती है, इससे पहले कि तकनीकी टीमें इसे लागू करना शुरू करें, अन्यथा संगठन एजेंटों को गलत डेटा खिलाने वाली सुरुचिपूर्ण पाइपलाइन प्राप्त करेंगे।
इसका प्रभाव उन स्थितियों में सबसे अधिक दिखाई देता है जिनमें महत्वपूर्ण निर्णय लेने की आवश्यकता होती है: सुरक्षा विश्लेषक को केवल विशिष्ट खतरे से संबंधित संकेत मिलते हैं, न कि सामान्य फ़ीड; वित्तीय सेवा और बीमा (FSI) टीमें लेनदेन के नियामक संदर्भ में एजेंटों के काम को स्थिर करती हैं, जहां CERT-In (12 घंटे) और RBI के सख्त समय सीमा और ढांचे मौजूद हैं; और वैश्विक केंद्र ऑफ कॉम्पिटेंसी (GCC) के डेवलपर्स को संगठन की अपनी प्रणालियों पर आधारित उत्तर मिलते हैं। ये उदाहरण विशेष रूप से भारत में प्रासंगिक हैं, जहां उद्यम विविध डेटा वातावरण में काम करते हैं, जिसमें पुराने बैंकिंग सेवा सिस्टम और आधुनिक क्लाउड एप्लिकेशन शामिल हैं, अक्सर हिंदी और क्षेत्रीय भाषाओं में रिकॉर्ड के साथ। DPDP कानून और डेटा स्थानीयकरण आवश्यकताओं को देखते हुए, कई संगठनों के लिए पूरे एआई स्टैक को स्थानीय रूप से या अलग-थलग वातावरण में तैनात करना प्राथमिकता नहीं, बल्कि खरीद की आवश्यकता है।
सबसे आम गलती यह मानना है कि मॉडल को कॉर्पोरेट डेटा से जोड़ना उसे कॉर्पोरेट संदर्भ में स्थिर करने के बराबर है, क्योंकि पहुंच प्रासंगिक निष्कर्षण की गारंटी नहीं देती है; दूसरी सबसे आम भ्रांति एजेंट की अवलोकन क्षमता को अनदेखा करना है, जो संगठन को नियामकों को एजेंट के निर्णयों की व्याख्या करने की क्षमता से वंचित करता है।
मॉडल का चयन उस संदर्भ की गुणवत्ता से बहुत कम मायने रखेगा जिस पर मॉडल अपने तर्क का आधार बनाता है। अच्छी तरह से स्थिर छोटी मॉडल खंडित संदर्भ के साथ काम करने वाले बड़े मॉडल से लगातार बेहतर प्रदर्शन करती है। प्रतिस्पर्धात्मक लाभ मॉडलों की खरीद से हटकर बौद्धिक स्तर पर स्थानांतरित हो जाता है जो यह निर्धारित करता है कि कोई भी मॉडल वास्तव में क्या जान सकता है और क्या कर सकता है।
इसके अलावा, उद्यमों को एआई सफलता मेट्रिक्स पर पुनर्विचार करने की आवश्यकता है। टोकन का उपयोग और मॉडल का आकार व्यावसायिक मूल्य के बारे में बहुत कम बताते हैं। परिणाम-उन्मुख संकेतक अधिक महत्वपूर्ण हैं: मानव हस्तक्षेप की आवृत्ति की तुलना में कार्यों के पूरा होने का प्रतिशत, परीक्षण की तुलना में कार्य वातावरण में निर्णयों की सटीकता, महत्वपूर्ण कार्यप्रवाहों में प्रतिक्रिया समय और नियामक अनुपालन के अनुसार ऑडिट की क्षमता, यानी यह व्याख्यात्मक रिकॉर्ड कि एजेंट ने किन डेटा पर परामर्श किया और क्यों।
गार्टनर का अनुमान है कि 2026 के अंत तक 40% कॉर्पोरेट एप्लिकेशन विशेष एजेंटों का उपयोग करेंगे, और एकल, विश्वसनीय डेटाबेस के बिना सिस्टम व्यक्तिगत एजेंटों के जोखिमों को विरासत में लेते हैं, उन्हें बढ़ाते हैं।
वे संगठन जो एआई से सबसे अधिक दीर्घकालिक मूल्य निकालते हैं, वे नहीं हैं जिन्होंने इसे पहले लागू किया या सबसे जटिल मॉडल चुना। वे वे हैं जिन्होंने अपनी कॉर्पोरेट ज्ञान की उपलब्धता, सटीकता और विश्वसनीयता सुनिश्चित करने में निवेश किया है, ताकि कोई भी तर्क प्रणाली उनके आधार पर आत्मविश्वास से कार्य कर सके। मॉडल एक सुरक्षा अवरोधक नहीं है। डेटाबेस आधार है।