Модель голосового ИИ Tencent Hunyuan Hy Realtime умеет самостоятельно определять необходимость поиска и исполнять песни по запросу
Подробнее
Pandaily
pandaily.com

Модель голосового ИИ Tencent Hunyuan Hy Realtime умеет самостоятельно определять необходимость поиска и исполнять песни по запросу

Tencent Hunyuan представила модель Hy Realtime, которая является голосовой моделью в режиме реального времени и интегрирует функции вызова инструментов и пения в повседневный разговор. Эта модель уже доступна в голосовых звонках на платформе Tencent Yuanbao и в службе поддержки клиентов Tencent. Компания сообщила, что в скором времени Hy Realtime будет предложена через API на Tencent Cloud. Анонс модели состоялся 13 ноября.

Согласно заявлениям Tencent, Hy Realtime разработана с учетом особенностей человеческой речи. Модель способна работать с такими особенностями, как бормотание, прерывание фраз или самокоррекция во время мысли. Для реконструкции истинного смысла используется контекст окружающего разговора. Кроме того, улучшены возможности многоходового следования инструкциям и управления контекстом, что позволяет модели отслеживать намерение пользователя в течение продолжительных диалогов.

Модель также обладает функцией вызова внешних инструментов. Основываясь на содержании беседы и намерениях пользователя, она принимает решение о необходимости веб-поиска, затем управляет этим поиском, выполняет вызов инструмента и предоставляет голосовой ответ в рамках единого процесса. В плане качества вывода Tencent утверждает, что модель превосходит свою предшественницу по аудиокачеству, произношению, просодии и эмоциональному выражению, обеспечивая более естественные изменения тональности в ходе диалога.

Функционал пения был разработан совместно с командой искусственного интеллекта Tencent Music Entertainment. Пользователи могут запрашивать композиции, указывая такие параметры, как исполнитель, альбом, жанр, язык, год выпуска или популярность, а также комбинировать эти условия и уточнять запрос в последующих репликах. В примере от Tencent пользователь попросил английскую народную песню, выпущенную между 2010 и 2020 годами, и модель нашла подходящий вариант и спела его. Tencent отмечает, что они настроили вокал для придания выразительности, естественной фразировки, дыханию, а также мелодии и ритму.

Tencent сообщает о положительных результатах в ходе внутренних слепых тестов экспертов по задачам поиска и ответа, а также в внутреннем тестовом наборе для режима без мышления и на ряде публичных голосовых бенчмарков. Компания характеризует свои общие результаты на этих публичных тестах как ведущие. Следует отметить, что это оценки самой компании, и в опубликованном тексте не приводятся размеры выборок или настройки тестов.

Пользователи могут протестировать модель в последнем приложении Yuanbao, выбрав голос под названием Chuyu в голосовых звонках, либо через веб-демонстрацию на Tencent Cloud. Tencent планирует дальнейшее развитие в направлении двустороннего взаимодействия, долгосрочной персонализированной памяти и координации между основным разговорным агентом и фоновыми агентами.

Похожие сюжеты

Система MOSS-Live демонстрирует высокие показатели в голосовых метриках, но уступает GPT-Live-1 в задачах с несколькими репликами
Подробнее
pandaily.com

Система MOSS-Live демонстрирует высокие показатели в голосовых метриках, но уступает GPT-Live-1 в задачах с несколькими репликами

Команда OpenMOSS из Университета Фудань и MOSI Intelligence представила детальную оценку своей полнодуплексной системы голосового взаимодействия MOSS-Live. Эта система была сравнена с моделями OpenAI, такими как GPT-Live-1 и GPT Realtime 2.1, а также с Doubao SeedDuplex от ByteDance и двумя моделями Qwen Audio 3.0. В публикации в блоге OpenMOSS от 13 ноября изложены области превосходства и отставания MOSS-Live. Стоит отметить, что все представленные цифры являются данными от вендоров, а информация о размерах выборок, оценках неопределенности и полных условиях тестирования не раскрыта.

MOSS-Live заняла первое место по всем шести заявленным метрикам полнодуплексного взаимодействия. Система реагировала на речь, не адресованную ей, лишь в 2% случаев, что значительно лучше, чем 68% у GPT-Live-1 и 75% у Doubao SeedDuplex. Кроме того, она вмешивалась во время паузы пользователя всего в 1,44% случаев, по сравнению с 10,37% и 14,29% у конкурентов. Система корректно игнорировала посторонние прерывания в 68% случаев, тогда как показатели у других моделей составили 21% и 13%, и поддерживала свою линию поведения во время кратких подтверждений вроде «мм-хм» в 98,17% случаев.

Результаты по другим параметрам оказались неоднозначными. При использовании инструментария FDB v3 MOSS-Live показала 51% успешности, что поставило ее наравне с Doubao SeedDuplex как лидера и опередило GPT-Live-1 с его 45%. Однако время отклика системы в сценариях использования инструментов, составлявшее 2,36 секунды, оказалось медленнее, чем 1,61 секунды у GPT Realtime 2.1. В бенчмарке многоходовых задач τ-Voice MOSS-Live набрала 57,93%, что уступило GPT-Live-1 с его 67,68%, но значительно превзошло Doubao с 17,38%. Процент случаев, когда система уступала право голоса в течение двух секунд, составил 52,49%, что намного ниже, чем более 93% у моделей Qwen Audio. По пониманию аудио на Big-Bench Audio MOSS-Live показала 88,40%, что было ниже, чем 90,50% у Doubao. При следовании многоходовым инструкциям система получила 3,35 из 5 баллов, в то время как GPT-Live-1 набрал 3,72, однако MOSS-Live лидировала по качеству ответов после прерываний, достигнув 4,88.

Архитектура MOSS-Live объединяет фоновую модель, которая занимается прослушиванием, управлением очередностью и речью, с фоновой моделью, отвечающей за рассуждения, вызовы инструментов и более длительные задачи. Эти две модели обмениваются памятью, контекстом и состоянием задачи через координационный уровень, что позволяет продолжать диалог, пока выполняется поиск отелей или другая операция. Система также поддерживает потоковое видео, демонстрацию экрана и интерпретацию в реальном времени.

Система доступна через онлайн-песочницу и посредством WebSocket realtime API под идентификатором модели moss-live-1.0. MOSI Intelligence, которая находится в инкубаторе Шанхайского инновационного института, совместно с командой OpenMOSS ранее выпустила модели MOSS-Image и MOVA.

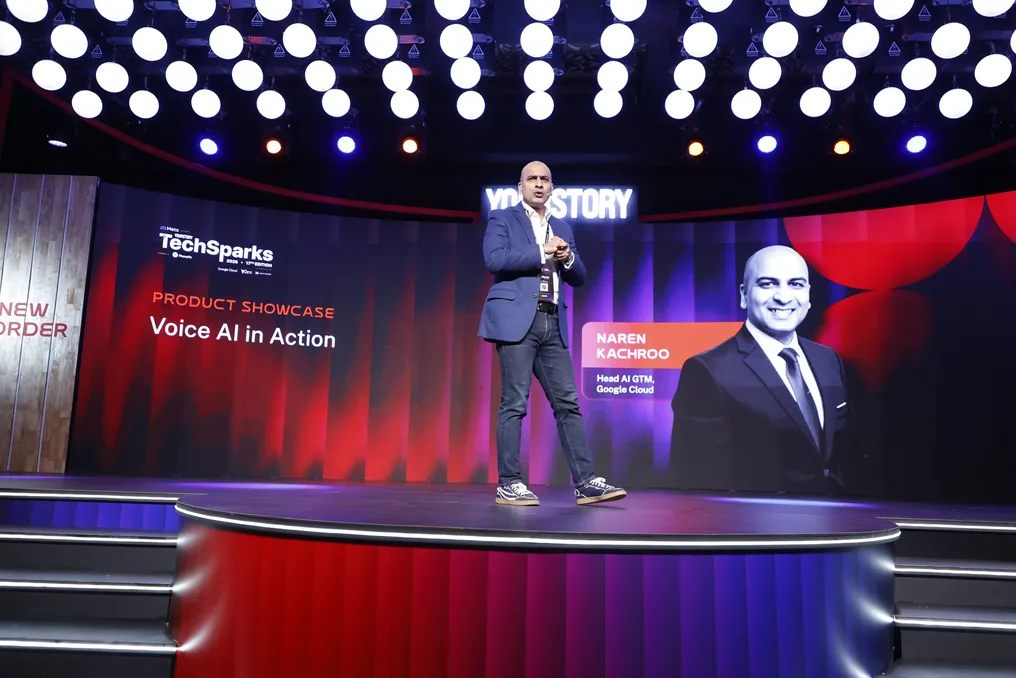
Naren Kachroo из Google Cloud представил развитие голосового ИИ на конференции TechSparks 2026
Подробнее
yourstory.com

Naren Kachroo из Google Cloud представил развитие голосового ИИ на конференции TechSparks 2026

Naren Kachroo, руководитель отдела продаж и GTM AI в Google Cloud, заявил, что наиболее ценным искусственным интеллектом является тот, который способен полностью выполнить поставленную задачу. Он подчеркнул, что ценность создается только тогда, когда задача действительно завершена с помощью ИИ.

На мероприятии TechSparks 2026, во время демонстрации продукта под названием «Голосовой ИИ в действии», Kachroo продемонстрировал последние голосовые модели Google, примеры использования у клиентов и живую демонстрацию, разработанную для малого бизнеса. Его основная мысль заключалась в том, что голос становится основным способом взаимодействия людей с ИИ, и в Индии этот переход произойдет на местных языках и акцентах.

Kachroo отметил, что индустрия отошла от концепции генеративного ИИ исключительно как инструмента для вопросов и ответов. Он пояснил, что фокус сместился на ИИ, который имеет доступ к данным, инструментам и возможностям, позволяющим действовать от имени человека.

Компания Google недавно представила Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking. Модель Gemini 3.8 Live способна распознавать и переключаться между 97 поддерживаемыми языками в рамках одного разговора. Kachroo объяснил, как предприятия могут выбрать между этими двумя моделями.

Модель Gemini 3.8 Live подходит для более простых задач, связанных с диалогом и агентскими функциями, например, для голосового чата с базовым вызовом инструментов. В то время как Extended Thinking предназначен для диалогов, требующих более глубокого рассуждения, переключения контекста и выполнения нескольких шагов. Также он упомянул, что Extended Thinking обходится дороже за токен.

Обе модели являются моделями типа «голос в голос», обрабатывая речь как входные, так и выходные данные в рамках одной системы. Для разработчиков, которым требуется только одна часть этого процесса, Google также предлагает отдельные модели для преобразования текста в речь, речи в текст и живого перевода.

Kachroo сообщил, что последняя модель Gemini для преобразования текста в речь показала высокие результаты в внутренних тестах Google с использованием индийских языков, акцентов и тональности. Он провел серию коротких демонстраций, чтобы показать спектр возможных сценариев использования.

В первом примере помощник Shopify, Sidekick, пошагово помог продавцу подключить домен через административную панель Shopify. Во втором примере голосовой агент забронировал столик в ресторане на восемь человек. В процессе звонка вызывающий спросил, разрешен ли торт, поделился фотографией из отзывов Google, чтобы узнать, является ли блюдо вегетарианским, и запросил информацию о других вегетарианских вариантах перед подтверждением бронирования. Этот второй сценарий требовал от агента отслеживания контекста на протяжении нескольких ходов диалога, запоминания предпочтений и выполнения нескольких вызовов инструментов, что, по словам Kachroo, идеально соответствует Extended Thinking.

Он также продемонстрировал Live Avatar, которая объединяет живой голос Gemini с генерацией видео в реальном времени и синхронизацией губ, позволяя пользователям видеть анимированное лицо, а не только слышать голос. Google недавно предоставил Live Avatar бизнесам через Gemini Enterprise, маркируя генерируемый аудио- и видеоконтент невидимым водяным знаком SynthID. Citi выступило в качестве пилотного клиента: его помощник Citi Sky, созданный с использованием технологии аватара в реальном времени от Google DeepMind и Gemini Live API, помогает клиентам из сферы благосостояния США принимать решения, например, относительно погашения сертификата депозита.

Kachroo отметил, что Gemini 3.8 Live имеет самую низкую стоимость за ход среди сопоставимых моделей, а Extended Thinking устанавливает отраслевые стандарты качества преобразования речи в речь. Google заявила, что Extended Thinking набрал 82.6 балла по индексу качества преобразования речи в речь от Artificial Analysis, что является самым высоким показателем.

Он уточнил, что низкая цена обусловлена тем, что Google управляет всем стеком самостоятельно — от чипов TPU и инфраструктуры до самих моделей и приложений, передавая полученную эффективность клиентам. Это позволяет Google предлагать как высококачественную модель, так и более экономичную рабочую лошадку.

В качестве примеров использования голосового ИИ Kachroo привел двух клиентов: Autotrader, который использует эту технологию для покупки и продажи подержанных автомобилей, и Equal AI, индийский стартап, чей помощник отвечает на звонки и обрабатывает их до того, как пользователь возьмет трубку.

Центральным элементом сессии стала живая демонстрация помощника для микро-, малых и средних предприятий (МСП), которую команда Kachroo разработала примерно за один день. Это крупный потенциальный рынок: по данным министерства МСП, на портале Udyam правительства зарегистрировано более 7,8 крора предприятий по состоянию на февраль 2026 года. Kachroo заранее предупредил об одном риске: он запускал демо через мобильный хотспот после того, как не смог подключиться к сети отеля.

Демонстрация включала вымышленную компанию по производству средств защиты и ее владельца, Раджеша, который только что получил около 500 шлемов. Общаясь с помощником, Раджеш спросил, сколько у него есть потенциальных клиентов для шлемов. Помощник нашел двух: строительную фирму в Мумбаи, которой нужно было 500 шлемов, и хозяйственный магазин в Агре, которому нужно было 50. Раджеш поручил помощнику отбросить меньший заказ, отправить коммерческое предложение покупателю из Мумбаи и позвонить ему для заключения сделки. Он установил одно условие: цена должна оставаться выше 400 рупий за шлем, и помощник мог оформить заказ без повторного одобрения. Затем помощник позвонил покупателю и провел переговоры на хинди. Kachroo отметил, что помощник сохранил контекст из внутреннего разговора с Раджешем при внешнем звонке, вел переговоры от имени компании и закрыл сделку.

Этот сквозной процесс, по мнению Kachroo, и является направлением развития голосового ИИ. Он считает, что с моделями 3.8 Live предприятия теперь могут интегрировать голосовых агентов в свои процессы, которые самостоятельно выполняют задачи. Kachroo добавил, что этот помощник мог бы вести такой же разговор на тамильском, телугу, малаялам, каннада, маратхи и других языках. Он подчеркнул, что это важно, поскольку индийский потребитель все больше ориентируется на голосовое взаимодействие. Сам Gemini Live теперь поддерживает более 25 индийских языков и диалектов. Согласно отчету IAMAI-Kantar Internet in India 2024, 98% из 886 миллионов активных интернет-пользователей Индии получали контент на индийских языках, а один из пяти использовал голосовые команды для выхода в сеть.

«Я считаю, что голос — это будущее», — заключил он. Он добавил, что голосовой ИИ в Индии должен быть адаптирован к языкам, на которых говорят люди, к их акцентам и к тому, к чему они привыкли. Kachroo сообщил, что у Google DeepMind есть команда в Бенгалуру, занимающаяся исследованиями голоса с акцентом на индийские акценты и культурные нюансы. Google также финансирует Проект Ваани, который реализуется Индийским институтом науки и ARTPARK, и который открыл более 31 000 часов речи на 105 языках из 165 округов.

В завершение Kachroo призвал основателей и разработчиков протестировать модели, использовать опыт и делиться обратной связью, включая информацию о том, что не работает, чтобы команды исследований и разработки Google могли их улучшить. Его более широкая мысль заключалась в том, что голосовой ИИ готов перейти от простого общения к фактическому исполнению, и Индия, благодаря своему разнообразию языков и ориентации пользователей на голос, является одним из рынков, где этот сдвиг будет протестирован в первую очередь.
Исследовательский агент Hyra 2.0 от Tencent Hunyuan самостоятельно создает инструменты для работы с белками, математическими доказательствами и чипами
Подробнее
pandaily.com

Исследовательский агент Hyra 2.0 от Tencent Hunyuan самостоятельно создает инструменты для работы с белками, математическими доказательствами и чипами

Tencent Hunyuan выпустила Hyra 2.0, вторую версию своего автономного исследовательского агента, которая была представлена 2 ноября. В отличие от Hyra 1.0, которая фокусировалась на решении отдельных задач, например, на разрешении проблемы показателя степени сумма против разности с помощью модели Hy3, новая версия разработана для создания многократно используемых исследовательских инструментов. Результаты работы и соответствующий код доступны в репозитории на GitHub под лицензией Apache 2.0.

Hyra 2.0 функционирует как трехуровневая система, состоящая из общих, миссионных и рабочих агентов. Эти агенты координируются через общую исследовательскую доску и постоянную очередь задач. Специализированный рабочий агент проводит проверку результатов, агенты поддерживают многоуровневую память, а общая база знаний обобщает полученные уроки в применимые навыки.

Инструменты, созданные системой

Компания Tencent представила ряд инструментов, разработанных этой системой. Среди них HyInv — модель обратного сворачивания белка с 1,96 миллионами параметров. Эта модель работает в 57 раз быстрее, чем ProteinMPNN, демонстрируя лучшее структурное соответствие и способная проектировать 128 последовательностей всего за 50 миллисекунд.

Также была представлена модель языка для белков HyPLM-Flash, обладающая 650 миллионами параметров и обученная на 726 миллиардах токенов. Она оказалась самой быстрой среди 12 сравниваемых моделей и заняла третье место в среднем по 35 задачам, обрабатывая около 130 000 остатков в секунду на одном процессоре H20.

Семейство силовых полей HyFF, включающее пять вариантов с параметрами от 2,3 миллиона до 1,2 миллиарда по 83 элементам, находится на паретовом фронте точности и скорости по сравнению с 16 другими моделями. Tencent утверждает, что их модель Largo показывает наименьшую ошибку энергии — 0,364 мэВ на атом, и этот комплекс смог симулировать систему аквапорина из 60 000 атомов в течение 100 наносекунд.

Достижения в математике и квантовых вычислениях

В области математики компонент HyProver достиг двух результатов. Он решил гипотезу Петти о равносторонних множествах в пятимерном пространстве, подняв максимальное решенное измерение с четырех. Что касается гипотезы Яу о действии круга, в описании на GitHub представлен контрпример для неограниченной формы — замкнутое семимерное многообразие, которое не является просто связным; при этом просто связная версия остается открытой проблемой.

В сфере квантовой коррекции ошибок HyQEC обнаружил код [[488,123,22]], который, по заявлению Tencent, превосходит предыдущего лидера по метрике qLDPC примерно на 48%.

Робототехника и чипы

Кроме того, Hyra спроектировала механизм имитируемой роботизированной руки, который оказался на 28,6% быстрее эталонного дизайна. На открытом процессоре XiangShan RISC-V агент повысил показатель SPECint2006 на гигагерц на 5,79%, при этом увеличив площадь всего на 0,3% и обнаружив десять ошибок. Tencent сообщает, что Hyra теперь используется для обучения следующих моделей серии Hy.

Важно отметить, что все представленные результаты принадлежат Tencent и еще не прошли независимую экспертизу.

Популярное