MiniMax выпустила модель H3-Image с открытыми весами для генерации и редактирования изображений 16 МП
Подробнее
Pandaily
pandaily.com

MiniMax выпустила модель H3-Image с открытыми весами для генерации и редактирования изображений 16 МП

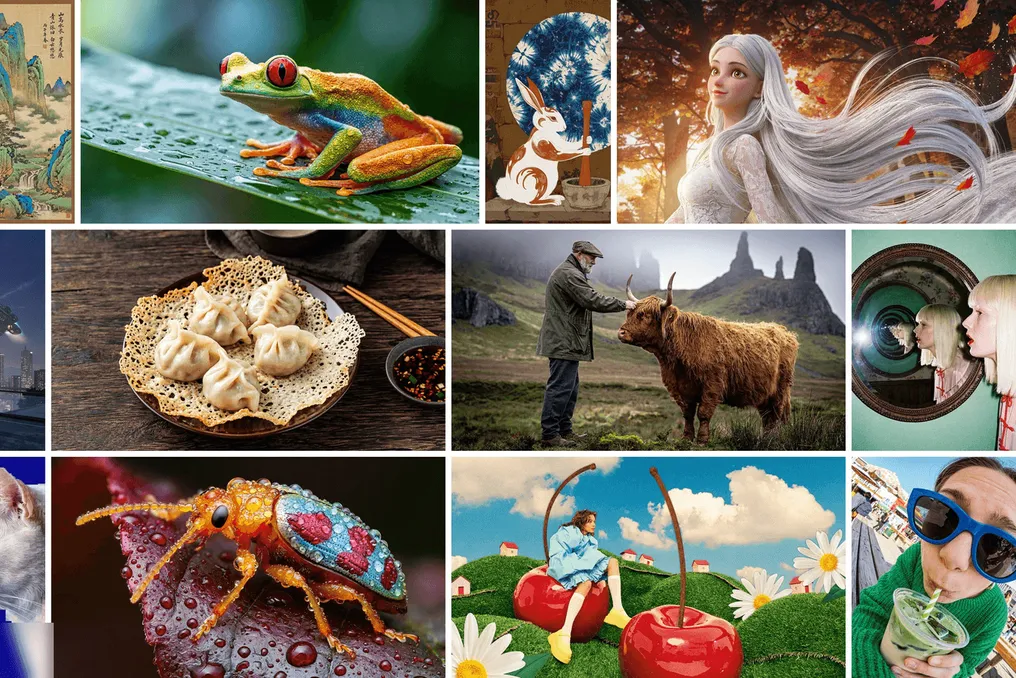
Компания MiniMax представила модель MiniMax-H3-Image с открытыми весами. Эта модель предназначена для задач преобразования текста в изображение и редактирования изображений, и она является частью семейства H3 компании.

Выпуск состоялся поздно вечером 10 ноября, а сами веса доступны на платформе Hugging Face. Согласно заявлению MiniMax, данная модель способна генерировать изображение с разрешением около 16 мегапикселей, размером 4096 на 4096 при соотношении сторон 1:1, менее чем за 10 секунд. Компания утверждает, что это примерно в пять раз быстрее, чем средний показатель на рынке для такого разрешения.

Характеристики и возможности модели

Согласно карточке модели, один контрольный файл способен выполнять как преобразование текста в изображение, так и редактирование одного или нескольких эталонных изображений, принимая до 16 таких ссылок. Диффузионный трансформер имеет 33,1 миллиарда параметров, использует архитектуру H3, но без аудиослоев, и был дистиллирован до шести шагов сэмплирования без использования классификатора без свободной направляющей. Текстовый энкодер модели представляет собой отдельный компонент — текстовый энкодер MiniMax-H3.

MiniMax указывает, что выходные размеры могут достигать 6272 на 2688 без использования апскейлера. Файл в формате BF16 весит 68,65 ГБ, а дополнительная модель расширения промпта под названием MiniMax-H3-Image-PE имеет размер 17,9 ГБ.

Компания заявляет, что следование инструкциям моделью является самым сильным среди моделей для изображений с открытым исходным кодом, и она избегает характерного «искусственного интеллекта» внешнего вида. Эти заявления являются собственными утверждениями компании, и в исходном материале отсутствовали независимые сравнения.

Карточка модели рекомендует использовать SGLang, vLLM-Omni, diffusers и ComfyUI для локального развертывания, а также перечисляет ускорители NVIDIA и AMD. Модель также доступна через API и приложения MiniMax, причем в течение первой недели компания предлагает скидку 50% на запросы API для изображений с разрешением 16 мегапикселей и выше.

Лицензионные условия

Лицензия, применяемая к модели, называется MiniMax-H3-Image Community License Agreement, и она не является стандартной лицензией с открытым исходным кодом. Данное соглашение действует по всему миру, за исключением Европейского Союза, Великобритании, Южной Кореи и Соединенных Штатов, и устанавливает, что использование за пределами этой территории не санкционировано договором. Кроме того, оно требует получения отдельного письменного разрешения от MiniMax для пользователей, чей годовой доход превышает 1 миллион долларов США, или для тех, кто предоставляет хостинговые услуги третьим сторонам. Также коммерческим продуктам предписывается отображать надпись «MiniMax-H3-Image» в своем интерфейсе.

Этот релиз последовал за более ранним выпуском MiniMax открытых весов для видео и аудио, основанных на модели H3.
Похожие сюжеты

Moonshot AI выпустила веса модели Kimi K3.1 Pro для независимого развертывания
Подробнее
technode.com

Moonshot AI выпустила веса модели Kimi K3.1 Pro для независимого развертывания

Компания Moonshot AI опубликовала веса своей флагманской мультимодальной модели Kimi K3.1 Pro на платформе Hugging Face, что позволяет пользователям самостоятельно развернуть модель.

Модель построена на архитектуре с использованием смеси экспертов (mixture-of-experts) и обладает общим количеством параметров в 2,8 триллиона, при этом около 104 миллиардов параметров активируются при каждом выводе. Кроме того, она поддерживает контекстное окно объемом приблизительно в один миллион токенов.

Версия K3.1 Pro представляет собой развитие модели Kimi K3, в которую были добавлены расширенные методы обучения с подкреплением для задач, связанных с кодированием, созданием трехмерных объектов, финансовыми исследованиями и выполнением длительных задач агента.

Выпуск весов произошел после того, как модель стала доступна через приложения и API сервиса Kimi. Также было объявлено, что Huawei предоставила поддержку инференса через системы Atlas A3 и Ascend 950 с использованием vLLM Ascend и SGLang.

Tencent выпустила модель Hy4 с возможностями компьютерного зрения и управления
Подробнее
technode.com

Tencent выпустила модель Hy4 с возможностями компьютерного зрения и управления

Компания Tencent представила свою флагманскую модель искусственного интеллекта Hy4, которая получила возможности визуального понимания и способности взаимодействовать с компьютером. Запуск модели состоялся 4 ноября.

Hy4 способна анализировать графики и документы, проводить рассуждения на основе нескольких изображений, а также управлять инструментами командной строки и графическими интерфейсами. Процесс обучения охватывает такие приложения, как Blender и программное обеспечение CAD, а также задачи, требующие работы в нескольких программах одновременно.

Модель Hy4 обладает 770 миллиардами параметров и доступна в продуктах самой Tencent, а также через сторонние платформы, включая OpenRouter. Вскоре компания планирует опубликовать веса модели и специальную карточку системы.

Стандартное ценообразование API осталось прежним по сравнению с предварительным просмотром Hy4: стоимость составляет $0.834 за миллион входных токенов и $2.501 за миллион выходных токенов. Кроме того, до 31 декабря предоставляется скидка в размере 50% на Tencent Cloud TokenHub.

Tencent интегрировала Hy4 в продукты WorkBuddy и CodeBuddy, предоставив ограниченный бесплатный лимит использования с 4 по 15 ноября. Также запланировано создание более экономичной версии модели Hy4 Flash. Компания отметила, что разработка была сосредоточена на офисных задачах, финансовом анализе и создании игр, при этом команды разработчиков помогали обучать и оценивать модель на основе реальных рабочих процессов.

DiffuSpace открывает модель Clover-35B-A3B — диффузионную языковую модель для агентов и кодирования
Подробнее
pandaily.com

DiffuSpace открывает модель Clover-35B-A3B — диффузионную языковую модель для агентов и кодирования

Команда DiffuSpace, которая ранее разработала диффузионную языковую модель Dream 7B, выпустила и сделала общедоступной модель Clover-35B-A3B-Preview. Эта модель предназначена для выполнения задач, которые традиционно решаются обычными большими языковыми моделями, таких как написание кода, взаимодействие с инструментами, просмотр веб-страниц и создание интерфейсов фронтенда.

Большинство существующих языковых моделей работают авторегрессивно, то есть они предсказывают токены последовательно, где каждый новый токен зависит от предыдущих. Диффузионные языковые модели используют иной подход: они обновляют множество позиций одновременно и уточняют результат в течение нескольких раундов, восстанавливая скрытый или зашумленный текст в связный ответ. Этот метод обещает более быструю генерацию, однако исторически диффузионные модели демонстрировали ненадежность при выполнении задач агентов, часто приводя к некорректным вызовам инструментов и повторению неудачных шагов.

Clover использует метод блочной диффузии. Выходной поток разбивается на блоки, которые генерируются последовательно, в то время как позиции внутри каждого блока очищаются от шума параллельно. Команда сообщила, что для этого они реструктурировали основу Gated DeltaNet для параллельного шумоподавления на уровне блоков и добавили калибровку размера блока, которую можно обучить. Модель представляет собой архитектуру типа 'смесь экспертов' с общим количеством параметров в 35 миллиардов и примерно 3 миллиардами активных параметров на токен, а также поддерживает режим мышления.

Согласно данным, опубликованным командой, Clover показал результат 73.6 на SWE-bench Verified и 51.7 на Terminal-Bench 2.1. Что касается использования инструментов, модель достигла 65.3 на общем бенчмарке tau-cubed и 67.9 на BFCL-v4. Команда утверждает, что эти показатели превосходят авторегрессивные модели аналогичного размера, включая Qwen3.6-35B-A3B. Следует отметить, что все эти цифры являются самоотчетными и еще не прошли независимую проверку.

Основным преимуществом является скорость. DiffuSpace заявляет о скорости 515 токенов в секунду при выполнении задач агента на одном чипе NVIDIA H200, по сравнению с 365 токенами в секунду при использовании настройки спекулятивного декодирования DFlash2, а также о скорости 680 токенов в секунду в целом на одном GB300. В тестовом сценарии веб-агента, охватившем 49 задач, медианное время выполнения Clover составило 1.52 секунды.

Веса модели доступны на платформах Hugging Face, GitHub и ModelScope под лицензией Apache 2.0. DiffuSpace также предлагает пробный доступ через свой веб-сайт и сообщает о разработке инструментария для агентов и настольного клиента для кодирования. Поскольку Clover обозначен как предварительная версия, его надежность в реальных сценариях длительных рабочих процессов агентов потребует внешнего тестирования. Тем не менее, это одна из крупнейших открытых диффузионных языковых моделей, ориентированных непосредственно на задачи кодирования и использования агентов.

Популярное