Huawei Ascend добавила поддержку Kimi K3.1 Pro для Atlas A3 и Ascend 950 SuperPoDs
Подробнее
Pandaily
pandaily.com

Huawei Ascend добавила поддержку Kimi K3.1 Pro для Atlas A3 и Ascend 950 SuperPoDs

Команда вычислительных систем Huawei Ascend сообщила о завершении адаптации для инференса модели Kimi K3.1 Pro, которая имеет 2,8 триллиона параметров. Полные веса этой модели были выпущены Moonshot AI 4 ноября, согласно официальному аккаунту Huawei Computing, как это сообщили IT Home и ifeng Tech.

Используя vLLM Ascend и SGLang, разработчики теперь могут развернуть эту модель на серверах Atlas 800 A3, в кластере Atlas 900 A3 SuperPoD и в серии Ascend 950 SuperPoD с момента ее выпуска.

Kimi K3.1 Pro является первой моделью в серии K3.1 от Moonshot AI. Это модель типа mixture-of-experts с нативной визуальной обработкой и окном контекста около миллиона токенов, активирующей примерно 104 миллиарда параметров на каждом шаге инференса. Модель сохраняет гибридное линейное внимание K3, основанное на слоях Kimi Delta Attention (KDA), и добавляет слои разреженного внимания DSA вместо некоторых слоев полного внимания для снижения затрат на моделирование длинного контекста.

Большая часть работы по адаптации была связана именно с этой архитектурой. Huawei заявила, что ее команда инференса опиралась на предыдущую адаптацию Kimi K3, предварительно анализируя новую модель и параллельно работая над интеграцией модели, разработкой операторов и валидацией сервисов. Благодаря уже имеющейся поддержке KDA и MoE, команда добавила новый путь разреженного внимания и мультимодальный инференс, сохранив при этом существующие функции обслуживания в фреймворках инференса.

Согласно информации от Huawei, оптимизация охватила основные операторы для выбора исторической информации, вычислений разреженного внимания, предварительной обработки и остаточных вычислений, что было объединено с распределенным кэшированием и функциями на уровне фреймворка для поддержки инференса с длинным контекстом и производственного обслуживания. Компания определила цель в том, чтобы пользователи и разработчики могли начать тестирование приложений и развертывание в первый день выхода модели.

Документация vLLM Ascend указывает, что Kimi K3.1 Pro поддерживается в экспериментальном режиме в версии vLLM Ascend 0.30.0. Ее эталонные конструкции используют разделение префилла и декодирования на восемь узлов с четырьмя узлами префилла и четырьмя узлами декодирования, включая конфигурацию с длинным контекстом в один миллион токенов. Серверы Atlas 800I A3 работают с квантованной контрольной точкой W4A8, в то время как продукты 950DT используют вариант W4A8 MXFP; руководство отмечает, что продукты Atlas A2 и 950PR пока не поддерживаются.

Размер модели делает аппаратную поддержку практическим вопросом. IT Home отмечает, что веса в формате BF16 занимают около 5,6 ТБ и все еще требуют около 1,4 ТБ при квантовании INT4, что исключает использование одного потребительского графического процессора. Huawei позиционировала свои системы A3 и 950 SuperPoD для этого класса инференса MoE с триллионными параметрами, и выпуск Kimi K3.1 Pro стал последней открытой моделью, которую она поддержала в день запуска.
Похожие сюжеты

Компания HongYun выпустила HyperLM V2.5 с поддержкой Huawei Ascend 950DT и Atlas 850E SuperPoD
Подробнее
pandaily.com

Компания HongYun выпустила HyperLM V2.5 с поддержкой Huawei Ascend 950DT и Atlas 850E SuperPoD

AI-компания HongYun, базирующаяся в Пекине, представила HyperLM V2.5 — новую версию своей платформы для комбинированного обучения и инференса больших моделей. Об этом сообщили издания IT Home и ifeng Tech 3 ноября. Компания утверждает, что стала первой, кто осуществил глубокую адаптацию к чипу Huawei Ascend 950DT, полностью совместима с системой Atlas 850E SuperPoD с воздушным охлаждением и прошла техническую сертификацию Huawei для Ascend Native.

HongYun считает, что определение поддержки часто бывает слишком расплывчатым, когда модель считается поддерживаемой лишь после установки и генерации токенов. Целью компании является помощь государственным и корпоративным клиентам, использующим частные развертывания, в получении максимальной производительности от новых ускорителей.

Компания описывает Ascend 950DT как флагманский чип для задач, требующих высокой пропускной способности, таких как длительное взаимодействие в чатах, обработка длинных документов и непрерывное рассуждение агентов. Кроме того, отмечается, что система Atlas 850E с воздушным охлаждением может быть интегрирована в существующие центры обработки данных без необходимости модернизации инфраструктуры.

HyperLM V2.5 адаптируется на нескольких уровнях. На уровне межсоединений платформа поддерживает технологию UnifiedBus 2.0 от Huawei, которая обеспечивает пропускную способность системного межсоединения в размере 13,4 ТБ/с, предотвращая узкие места при передаче трафика между картами, что важно для длинных контекстов или разделения этапов предварительного заполнения и декодирования. На уровне оператора система оптимизирована для инференса mxFP4, позволяя использовать 14,2 PFLOPS одного узла.

Платформа поддерживает последние модели с открытым исходным кодом, включая Qwen, GLM и DeepSeek, а ее планировщик был перестроен с учетом профиля памяти и пропускной способности 950DT.

Выпуск HyperLM V2.5 включает пять новых возможностей. Разделение предварительного заполнения и декодирования позволяет изолировать два этапа в независимые пулы ресурсов, чтобы они не конкурировали во время пиковых нагрузок. Многоуровневое кэширование KV повторно использует системные подсказки, часто встречающиеся контексты и фиксированные шаблоны сессий для снижения объема повторяющихся вычислений. Виртуализация vNPU сегментирует чипы Ascend 950DT, 910C и 910B, предоставляя гранулированные квоты и изоляцию для вычислений AI Core и памяти HBM, а также поддерживает горячую миграцию и автоматическое перепланирование при сбое оборудования.

Также добавлена унифицированная шлюзовая модель, совместимая с протоколом OpenAI, которая управляет маршрутизацией, ограничением скорости, бета-релизами и A/B-тестированием. Комплексный мониторинг всего стека отслеживает нагрузку, использование памяти, пропускную способность, задержку и QPS, предоставляя оповещения и автоматическую локализацию сбоев.

Для регулируемых отраслей, таких как государственное управление, энергетика, транспорт и финансы, платформа предусматривает разделение ролей администратора, службы безопасности и аудитора, многоуровневый контроль классификации и полные журналы операций, а также учет вычислительных мощностей, аудит вызовов моделей и статистику использования по каждому проекту.

HongYun была инкубирована Западным институтом вычислительных технологий при Китайской академии наук, а ее основная команда сформирована сотрудниками Института вычислительных технологий и Sugon. В 2020 году компания присоединилась к партнерской программе Ascend от Huawei. Компания планирует продолжать развитие на базе аппаратного обеспечения Ascend и Hygon DCU, уделяя особое внимание гетерогенному планированию, ускорению инференса, кэшированию и приложениям для агентов.

Lenovo представила AI хост Kaitian с процессором Zhaoxin KX-7000 и NPU Houmo LQ50 для локального запуска моделей 35B
Подробнее
pandaily.com

Lenovo представила AI хост Kaitian с процессором Zhaoxin KX-7000 и NPU Houmo LQ50 для локального запуска моделей 35B

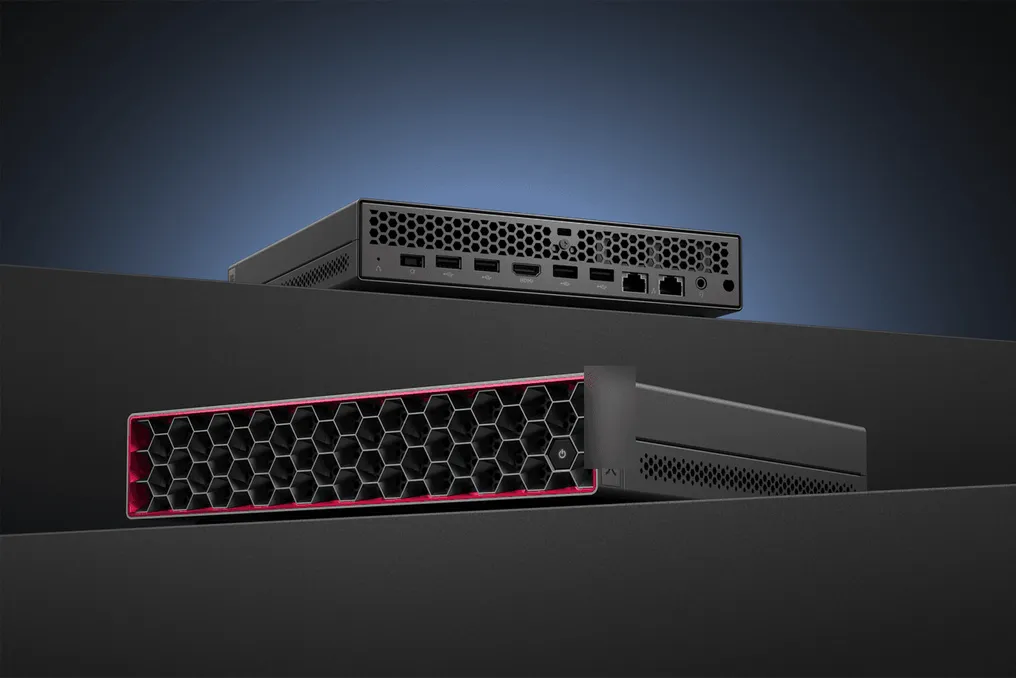
Lenovo выпустила первую AI хост-систему в линейке Kaitian, предназначенную для китайского рынка инноваций в области ИТ (Xinchuang). Этот настольный компьютер объемом 1,6 литра объединяет процессор Zhaoxin с AI NPU от Houmo, позволяя локально запускать модели размером около 35 миллиардов параметров.

Устройство оснащено восьмиядерным процессором Zhaoxin KX-7000 и NPU Houmo Liqing LQ50. В стандартной конфигурации система обеспечивает вычислительную мощность 160 TOPS в формате INT8, а с опцией NPU эта мощность может достигать 320 TOPS. NPU имеет 24 ГБ выделенной памяти с пропускной способностью 153,6 ГБ/с. Хост работает под управлением Kylin OS и предустановлен агентом Tianxi AI Pro от Lenovo.

Компания провела тестирование устройства с использованием открытых моделей, включая серии Qwen3.5 и Qwen3.6-35B-A3B. При использовании 24 ГБ NPU и квантизации W4A8 модель Qwen3.6-35B-A3B генерировала текст со скоростью примерно 28,99 токенов в секунду при локальном выводе. Система поддерживает ввод данных объемом до 200 000 токенов для обработки длинных документов и многоходовых задач. Платформа Houmo предоставляет разработчикам инструменты для профилирования, компиляции, управления временем выполнения и квантизации моделей.

Lenovo позиционирует этот хост как постоянно действующего цифрового сотрудника, спроектированного для круглосуточной работы. Это позволяет агентам выполнять запланированные задачи, такие как поиск локальных знаний, составление документов и обобщение информации, при этом обработка выводов происходит непосредственно на устройстве, а не через облачные токены, сохраняя данные локально. На мероприятии Tianxi AI Pro тестировщики дали одной инструкции проверить приложение мобильного оператора, и устройство выполнило тестовый звонок, измерило задержку SMS-кода верификации и предоставило отчет.

Что касается теплоотвода, процессор и NPU имеют отдельные воздушные каналы за гексагональной передней панелью с вентиляторами высокого давления. Lenovo сообщает, что при холостом ходе температура корпуса составляет около 33 градусов Цельсия в комнате с температурой 25 градусов, а под полной нагрузкой — 41 градус. В комнате с температурой 35 градусов под полной нагрузкой температура достигает примерно 46 градусов. Уровень шума составляет 19,4 дБ в режиме ожидания и около 29,5 дБ во время полной инференции NPU. Устройство весит около 1,5 кг и оборудовано двумя независимыми портами 2,5GbE.

Стоит отметить, что Kaitian хост отличается от Lenovo AI Host P7, который был представлен в октябре с чипами Houmo M50 и CIX P1.

Первый кластер SuperPoD на Ascend 950DT с 1024 NPU запущен в Ухане всего за месяц
Подробнее
pandaily.com

Первый кластер SuperPoD на Ascend 950DT с 1024 NPU запущен в Ухане всего за месяц

В городе Ухань был активирован первый вычислительный кластер, построенный на SuperPoD с 1024 картами Ascend 950DT от Huawei. Запуск состоялся 28 октября на конференции по искусственному интеллекту Huawei для провинции Хубэй, которая проходила в рамках китайского роуд-шоу Huawei 2026 года.

Инвестиции в данный кластер предоставила Провинциальная группа по инвестициям в науку и технологии Хубэя, являющаяся государственным инвестором провинции. Согласно данным этой группы, реализация проекта заняла всего один месяц с момента начала работ до ввода в эксплуатацию, что является относительно коротким сроком для системы такого масштаба.

Развертывание представляет собой единый жидкостно-охлаждаемый SuperPoD. Один узел оснащен 1024 ускорительными картами Ascend NPU. Как вычислительные, так и соединительные шкафы полностью оборудованы системами жидкостного охлаждения. Система способна обеспечивать производительность 1 EFLOPS в формате FP8 и имеет 256 ТБ глобально унифицированной памяти. Пропускная способность между картами достигает уровня терабайт в секунду, а задержка сквозной связи составляет микросекунды.

Архитектура дизайна основана на UnifiedBus, внутренней архитектуре соединения Huawei для SuperPoD. Эта технология позволяет каждой карте в кластере напрямую обращаться к другим картам, что дает 1024 NPU функционировать скорее как один крупный ускоритель, нежели как множество отдельных серверов, соединенных через стандартную сеть. Huawei позиционирует эту установку для обучения моделей с триллионами параметров и для выполнения инференса AI-агентов.

Основным преимуществом подхода SuperPoD является возможность прямого доступа. При обучении больших моделей значительная часть времени тратится на перемещение данных между чипами. Поддержание унифицированной памяти по всему поду и внутри него соединительной архитектуры снижает объем трафика, который должен проходить через более медленные каналы.

Кластер предназначен для удовлетворения местных потребностей. Он призван предоставить разработчикам моделей и компаниям в Хубэе доступный источник вычислительных мощностей для тренировки крупных моделей, а также для создания, настройки и эксплуатации отраслевых AI-агентов. Местные источники отмечают, что это восполняет пробел в поставках высокопроизводительных вычислений в провинции.

Запуск в Ухане также знаменует собой раннее практическое внедрение поколения Ascend 950. Ранее в этом году Huawei демонстрировала физический SuperPoD на базе Ascend 950 и тогда сообщала, что уже было коммерчески развернуто более 750 комплектов предыдущего поколения Ascend 384 SuperPoD. Кластер 950DT в Ухане демонстрирует переход новой конструкции SuperPoD из демонстрационного оборудования в региональные центры ИИ-вычислений.

Huawei не раскрыла данные о энергопотреблении кластера или подробные показатели использования; приведенные выше числовые значения были озвучены на мероприятии по запуску.

Популярное