GPUWorks, представляющая собой легковесную корпоративную платформу для инференса искусственного интеллекта, была выпущена с открытым исходным кодом под лицензией Apache-2.0 4 ноября. Информация об этом была опубликована изданием IT Home. Код доступен на GitHub в организации FlitAI, позволяя предприятиям и разработчикам использовать, модифицировать его или вносить вклад в шаблоны инференса и адаптации чипов.
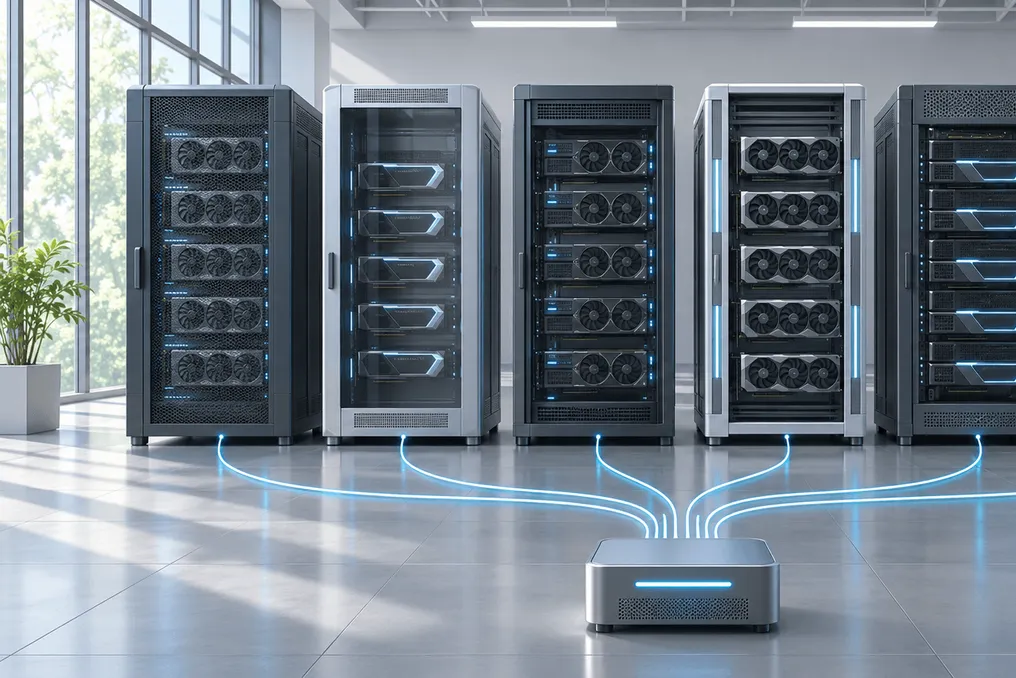
Данная платформа объединяет ускорители от различных производителей и источников в единый управляемый пул. Она осуществляет сопоставление моделей с аппаратным обеспечением, оценивает требования к памяти GPU и развертывает модели из шаблонов, после чего предоставляет к ним доступ через API, совместимый с OpenAI. Среди поддерживаемых чипов фигурируют NVIDIA и AMD, а также Huawei Ascend, T-Head PPU и Hygon DCU.
Серверы с bare-metal, виртуальные машины и облачные контейнеры могут функционировать в одном кластере, независимо от того, находятся ли они в собственных центрах обработки данных компании, частных или публичных облаках.
Особенности и производительность платформы
Разработчики особо отмечают компактность решения: установщик весит чуть более 40 МБ, устанавливается одной командой примерно за 60 секунд и не требует использования Kubernetes. Пользователи внутренней сети могут загрузить установщик, файлы моделей и образы среды выполнения в автономном режиме. Каталог включает более тысячи конфигураций запуска для почти 400 моделей, при этом для каждой комбинации модели и чипа упаковываются образ, движок инференса, версия весов и флаги запуска.
Встроенный помощник на базе ИИ помогает диагностировать сбои, а планировщик объясняет каждое принятое решение о размещении. Согласно собственным тестам команды, один сервер GPUWorks смог управлять 1003 серверами GPU и за четыре минуты поднять более 500 реплик инференса. При этом выход достигал 69 000 токенов в секунду, используя всего девять ядер ЦП и 1,6 ГБ памяти. Время пробуждения развернутого DeepSeek-V4.1-Flash составило всего 3,6 секунды.
Функция пробуждения позволяет нескольким крупным моделям попеременно использовать одни и те же GPU. Режим сна первого уровня сохраняет веса модели в памяти хоста, что исключает необходимость перезапуска движка или повторной загрузки весов из хранилища. В ходе испытания на восьми картах NVIDIA H20, где три большие модели распределены по всем восьми картам, холодный запуск из хранилища NFS занимал от 16 до 17,5 минут, тогда как восстановление сервиса после пробуждения из памяти заняло около четырех секунд, что представляет собой улучшение примерно в 200 раз. Администраторы имеют возможность настраивать политики приоритета, освобождения при простое или запланированной ротации.
Для более объемных рабочих нагрузок платформа поддерживает многоузловой параллелизм, множественные реплики и разделение предобработки и декодирования, позволяя конфигурировать сетевое взаимодействие RDMA или каналы Ascend HCCS. Также предусмотрены встроенные нагрузочные тесты для проверки пропускной способности и задержки перед масштабированием. Система отслеживает использование токенов и попадания в кэш по каждому ключу API, модели и развертыванию, а также часы карты на миллион выходных токенов и неиспользуемые GPU. Во время обслуживания узла платформа добавляет реплики до того, как начнет выводить из эксплуатации старые, и автоматически восстанавливает сервисы на другом подходящем узле, если машина выходит из строя.