Лидеры DeepSeek, Qwen и MiniMax обсуждают риски открытых моделей на саммите в Учжэне
Подробнее
Pandaily
pandaily.com

Лидеры DeepSeek, Qwen и MiniMax обсуждают риски открытых моделей на саммите в Учжэне

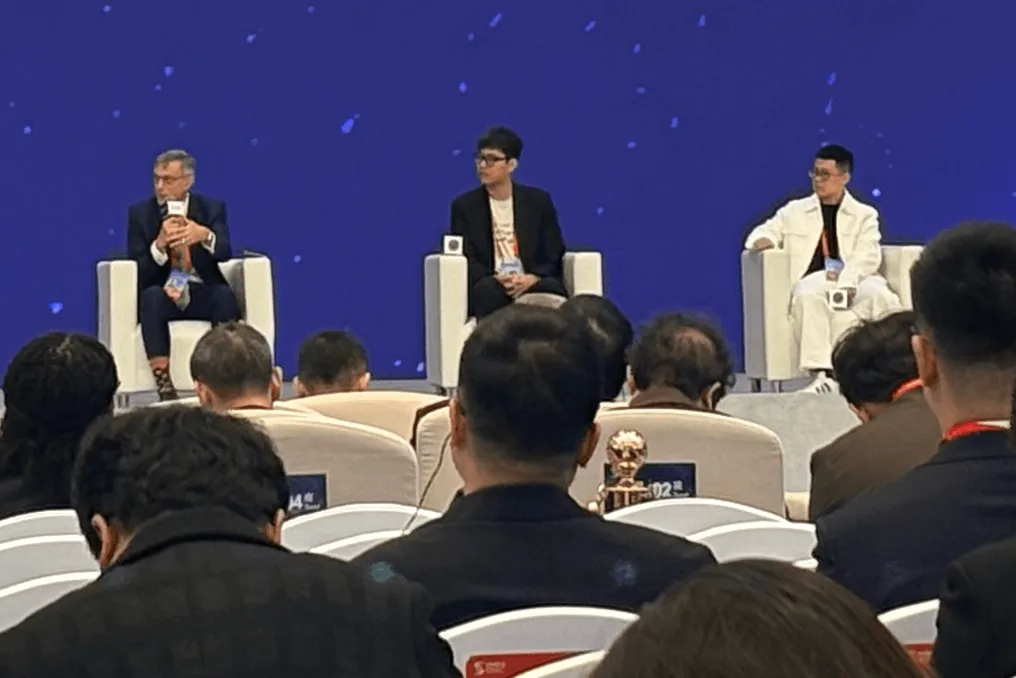
Представители трех ведущих разработчиков открытых моделей Китая — DeepSeek, команды Qwen от Alibaba и MiniMax — приняли участие в дискуссии о причинах выпуска своих моделей в открытый доступ и о том, как следует регулировать открытые модели. Мероприятие состоялось 3 ноября на Саммите Всемирной интернет-конференции в Учжэне.

Сессия, получившая название «Диалог Учжэня об искусственном интеллекте», была модерирована Ван Цзянем, академиком Китайской академии инженерии и директором Zhejiang Lab. Среди участников дискуссии были инженер DeepSeek Си Гао, руководитель проекта LLM Qwen Дайхэн Лю, главный архитектор и глава открытой платформы MiniMax Вэнь Фэн, а также Джон Хиггинс, председатель Международной ассоциации по управлению ИИ.

Си Гао заявил, что цель DeepSeek в открытом доступе проста: достичь общего искусственного интеллекта быстрее. По его мнению, главным конкурентом для лабораторий ИИ является время, а не другие компании. Он отметил, что технические препятствия могут ненадолго замедлить соперников, однако публикация исследований привлекает способных коллег для создания более совершенных моделей на основе работ DeepSeek.

Дайхэн Лю сообщил, что Qwen выпустила более 460 моделей с момента появления первой генерации три года назад, накопив более 4 миллиардов глобальных загрузок и более 330 000 производных моделей. Он утверждал, что открытый исходный код ускоряет инновации и делает ИИ широко доступным, предоставляя возможность не только использовать модели, но и участвовать в их создании.

В свою очередь, Вэнь Фэн объяснил, что MiniMax стремится привносить дифференцированную ценность путем выпуска моделей для различных модальностей и обмена инженерным опытом, включая информацию о возникших проблемах, проведенных экспериментах, модификациях данных и инструментов.

Что касается рисков, Лю выделил две особенности, присущие открытым моделям. Первая — необратимость: после выпуска модель распространяется повсеместно и не может быть исправлена так, как это возможно с размещенной моделью. Вторая проблема — отсутствие внешних систем защиты, поскольку безопасность зависит от встроенных мер предосторожности, которые сторонние разработчики могут попытаться обойти. Он подчеркнул, что одних ограничений моделей недостаточно для решения вопросов управления, призывая к принятию законов, отраслевых норм и созданию поддерживающей инфраструктуры.

Лю также добавил, что открытость способствует безопасности, поскольку модели с прозрачной архитектурой позволяют большему числу исследователей изучать их, а открытые модели могут использоваться в киберзащите. Он предположил, что текущие возможности могут быть недооценены, отметив, что даже модели с 1,5 миллиарда параметров могут быть активированы с помощью новых методов постобучения.

Вэнь Фэн возразил, что открытые модели часто являются более контролируемым выбором для индустрии, поскольку компании могут настраивать и конфиденциально развертывать их. Си Гао признал, что открытый исходный код может усилить риски безопасности ИИ, и заявил, что DeepSeek несет ответственность за предотвращение их распространения и занимается поиском решений.
Похожие сюжеты

Саммит WIC Wuzhen 2026 открылся с акцентом на открытый искусственный интеллект
Подробнее
cgtn.com

Саммит WIC Wuzhen 2026 открылся с акцентом на открытый искусственный интеллект

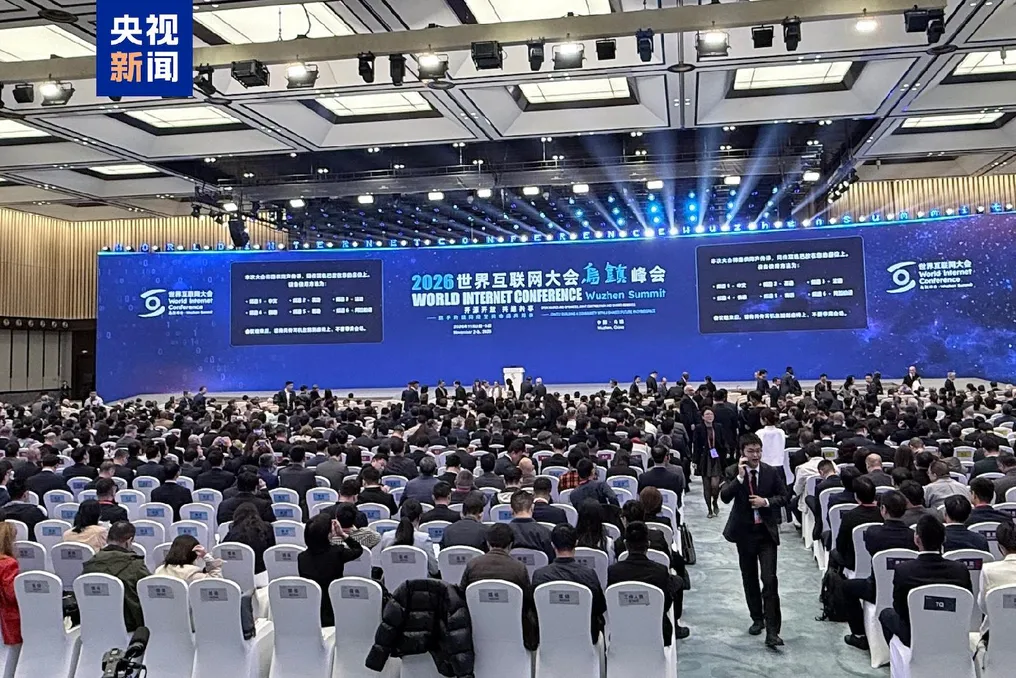
В городе Учжэнь, провинция Чжэцзян, на востоке Китая, во вторник состоялось открытие Саммита Всемирной интернет-конференции (WIC) Wuzhen. Мероприятие собрало представителей правительств, международных организаций, бизнеса и академических кругов со всего мира.

Тема этого года была сформулирована как «Открытый исходный код и открытость, совместная разработка и общие выгоды – совместно построение сообщества с общим будущим в киберпространстве». Основное внимание саммита уделяется открытому искусственному интеллекту, охватывая такие области, как технологические инновации, управление безопасностью, культурный обмен и международное сотрудничество.

Центральным элементом основного форума стал Диалог по ИИ в Учжэне, который объединил ведущие мировые технологические компании, руководителей компаний, занимающихся большими языковыми моделями с открытым исходным кодом, и ученых в области ИИ для изучения путей создания глобальной экосистемы открытого ИИ. Кроме того, саммит включает 27 подфорумов, посвященных таким темам, как сотрудничество в киберпространстве в рамках Инициативы глобального управления, теории и политика в цифровую и интеллектуальную эру, а также робототехника и воплощенный интеллект.

Международное участие было отмечено в конкурсах кейсов и технологических наград. Призыв к представлению выдающихся примеров совместного построения сообщества с общим будущим в киберпространстве получил 360 заявок из 80 стран и регионов, причем 22 страны участвовали впервые. Было отобрано одиннадцать лучших кейсов. Тем временем, награды Всемирной интернет-конференции за новаторскую науку и технологии получили более 430 заявок из 43 стран и регионов; восемнадцать стран и регионов представили свои работы впервые, а количество международных заявок увеличилось на 21% по сравнению с предыдущим годом. В итоге 20 проектов были удостоены наград.

Ваан Цзянь, академик Китайской академии инженерии, выразил мнение, что WIC продолжит играть значительную роль в развитии ИИ в Китае. Он отметил, что поскольку открытый исходный код и открытость носят глобальный характер, Саммит в Учжэне может способствовать вкладу Китая в глобальное развитие ИИ.

Джон Хоффман, генеральный директор GSMA Ltd., заявил, что Саммит в Учжэне служит площадкой для обмена информацией и объединения идей о том, как создать открытый интернет, доступный для всех. Он добавил, что тема этого года отражает давнюю приверженность саммита принципу «не оставить никого позади» и созданию возможностей для будущего мира.

Основатель QpiAI Нагендра Нагараджа выступает за моделирование интеллекта вместо традиционного ИИ
Подробнее
yourstory.com

Основатель QpiAI Нагендра Нагараджа выступает за моделирование интеллекта вместо традиционного ИИ

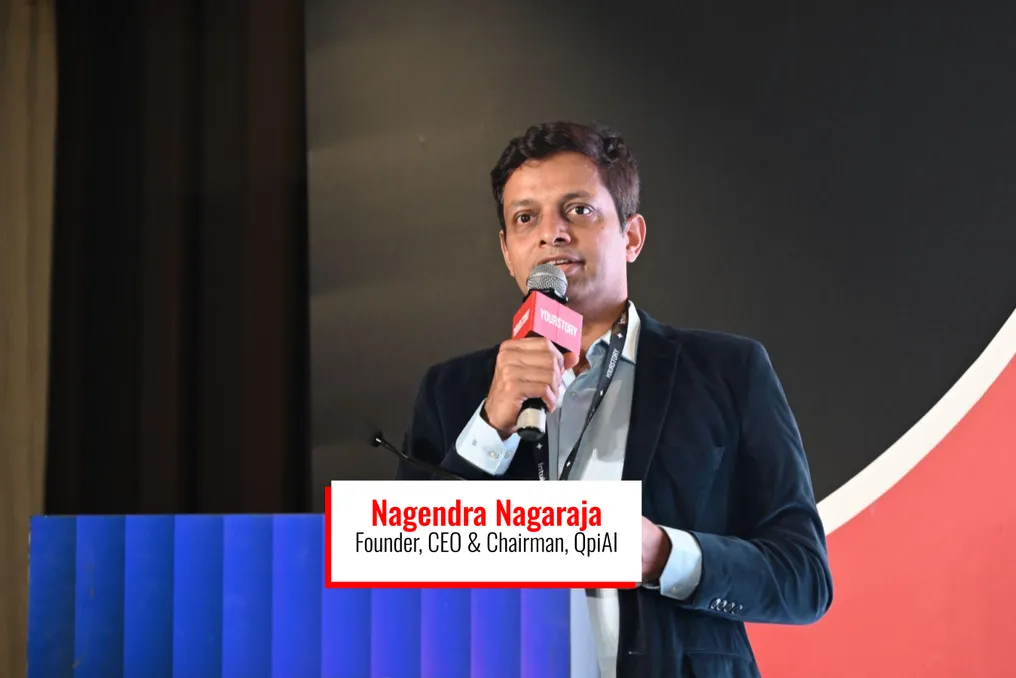
Нагендра Нагараджа, основатель, генеральный директор и председатель совета директоров QpiAI, считает, что искусственный интеллект понимается ошибочно. Он заявил, что предпочитает использовать термин «моделирование интеллекта» вместо «ИИ» во время своего основного выступления на мероприятии TechSparks, которое является флагманским технологическим стартап-событием YourStory.

По его словам, традиционный ИИ в основном занимается автоматизацией задач, используя оцифрованные человеческие знания, а не расширением человеческого понимания. Нагараджа утверждает, что истинный интеллект требует кардинального изменения парадигмы. Он определяет интеллект как способность узнавать новые вещи, которые ранее были неизвестны.

Сегодняшний бум ИИ опирается на классические микропроцессоры, обрабатывающие информацию с помощью бинарных кодов (нулей и единиц). Однако кремниевые полупроводники сталкиваются с физическими ограничениями по мере масштабирования производительности чипов. Тепловыделение из-за электрического сопротивления создает проблемы в проектировании чипов, что вынуждает компании внедрять передовые методы упаковки, включая трехмерную укладку чипов.

Параллельно с этим, крупные центры обработки данных предъявляют растущие требования к электросетям, некоторые из которых потребляют гигаватты электроэнергии. Нагараджа отметил, что многие компании, занимающиеся ИИ, вынуждены платить «налог NVIDIA» за использование графических процессоров.

Кроме того, большие языковые модели (LLM), обученные на человеческом тексте, достигают насыщения данных и дают все меньшую отдачу, несмотря на необходимость инвестиций в триллионы долларов. По мнению Нагараджи, фундаментальное ограничение текущего ИИ заключается в его полной зависимости от оцифрованного человеческого текста, который представляет собой ничтожную долю информации мирового масштаба.

Большая часть данных во Вселенной, закодированная в электронах, молекулах, ДНК и кристаллических материалах, существует в неквантовом, квантовом состоянии, которое классические ГПУ не способны обработать. Обработка сложных математических задач типа NP-hard на классических суперкомпьютерах может потребовать расчетов, растянутых на $10^{25}$ лет. Квантовые вычисления решают эту проблему, используя кубиты, которые обрабатывают многомерные данные экспоненциально быстрее.

Нагараджа подчеркнул срочность задачи: «Как человечество, последние 5000 лет мы знаем $10^{10}$ молекул... Нам нужно знать $10^{50}$ молекул. А у нас нет 25 000 лет. Мы должны сделать это за одно десятилетие».

Нагараджа утверждал, что переход от текста, созданного человеком, к моделированию природных систем способен трансформировать целые отрасли. Он указал, что в мире существуют только две крупные отрасли — энергетика и вычисления; все остальные производные от них.

Он привел в пример задачу моделирования сложных химических реакций, связанных с усвоением и переработкой удобрений растениями. По мнению Нагараджи, такие проблемы могут быть недоступны для классических вычислений в крупном масштабе. Он предположил, что квантовая система с 3000 логическими кубитами — кубитами с коррекцией ошибок, разработанными для более надежной работы, чем физические кубиты — могла бы смоделировать подобные реакции, потенциально изменив сельскохозяйственное производство.

Аналогичным образом, квантовые гибридные модели, сочетающие классическое программное обеспечение с квантовым оборудованием, уже повышают эффективность обнаружения финансового мошенничества в крупных банках при значительно меньших энергозатратах.

Раскрытие этих возможностей требует передового оборудования и быстрого исправления ошибок, то есть устранения квантового шума в режиме реального времени. Нагараджа сообщил, что QpiAI управляет тем, что они называют крупнейшим в Азии предприятием по квантовой фабрикации в Бенгалуру, производя чипы на 25 и 64 кубита с скоростью коррекции ошибок 1,4 микросекунды, что превосходит международные стандарты. Компания в настоящее время строит десятиакровый квантовый центр обработки данных, оснащенный 100 квантовыми компьютерами, а также планирует разработку чипов на 1000 кубитов.

Завершая, Нагараджа заявил, что Индия достигла значительных успехов, став одной из пяти стран мира, где производится более 50 кубитов. В конечном итоге, преодоление текущих пределов ИИ требует от человечества стать «очень хорошим учеником природы», чтобы использовать ее бесконечные данные.

DeepSeek открыл фреймворк для инференса DeepInfer с поддержкой чипов Nvidia и Huawei
Подробнее
technode.com

DeepSeek открыл фреймворк для инференса DeepInfer с поддержкой чипов Nvidia и Huawei

Компания DeepSeek выпустила DeepInfer, фреймворк для выполнения инференса, который лежит в основе ее сервисов больших моделей. Этот релиз состоялся 20 октября.

DeepInfer обладает поддержкой графических процессоров Nvidia, а также процессоров Huawei Ascend. Фреймворк предоставляет ряд функций, включая распределенный инференс, спекулятивное декодирование и структурированный вывод.

Согласно заявлению DeepSeek, цель этого выпуска — помочь разработчикам и предприятиям повысить пропускную способность и снизить задержки, одновременно уменьшая затраты на вычисления и потребление энергии.

Кроме того, компания сделала общедоступным компонент deepseek-recipe. Он отвечает за преобразование запросов API и обработку ввода и вывода модели в соответствии с собственными сервисами DeepSeek. В настоящее время DeepInfer поддерживает модель DeepSeek-V4.1-Flash-1017, и компания намерена продолжать выпуск кода инференса и оптимизаций для будущих моделей через данный проект.

Популярное