AgiBot представила робота GO-3 Preview, который занял первое место в трех рейтингах и планирует стать открытым проектом
Подробнее
Pandaily
pandaily.com

AgiBot представила робота GO-3 Preview, который занял первое место в трех рейтингах и планирует стать открытым проектом

Компания AgiBot выпустила модель GO-3 Preview 29 октября. Эта воплощенная модель искусственного интеллекта способна продолжать обучение в масштабе на всех этапах: во время предварительного обучения, после него и уже после внедрения в работу. AgiBot намерена сделать полную модель общедоступной к концу 2026 года.

GO-3 Preview основан на архитектуре, которую AgiBot называет WRAM, или Моделью Действий Рассуждения о Мире. Эта архитектура связывает рассуждение о задаче, прогнозирование будущих событий и генерацию действий, позволяя роботу понять инструкцию, предвидеть результат и выполнять соответствующие движения.

Модель недавно завоевала первое место в трех рейтингах для воплощенного ИИ: RoboDojo, RoboTwin и RoboColiseum. AgiBot утверждает, что модель масштабируется по двум направлениям. С одной стороны, богатые примеры обработки объектов и развития задач предоставляются видеозаписями людей от первого лица, а траектории роботов связывают наблюдения с действиями и физическими результатами.

С другой стороны, более высокая обучающая способность модели превращает этот разрозненный опыт в навыки, которые могут быть применены к новым задачам. После предварительного обучения компания отмечает, что роботы могут выполнять незнакомые задачи в домах, на кухнях, в системах с несколькими роботами и осуществлять тонкую манипуляцию без дополнительной тонкой настройки.

При помощи нескольких демонстраций модель способна осваивать длительные и деликатные операции, например, приготовление дзяньбина — китайского пикантного блинчика. После тонкой настройки и координации шагов агентом, робот также может собирать детали Лего.

Для этапа после обучения AgiBot разработала систему распределенного обучения Genie Evolver, которая объединяет около ста реальных роботов с симуляцией физики и моделями мира. В игре по керлингу на столе робот обошел среднего протестированного человека после четырех часов онлайн-тренировок. В игре с башнями из блоков он смог вытащить пять блоков подряд, сохраняя устойчивость башни.

После внедрения агентская структура Genie Master обеспечивает связь между суждением, исполнением и обратной связью, позволяя роботам непрерывно совершенствоваться в процессе работы. Робот AgiBot G2, работавший в реальном круглосуточном магазине, самостоятельно обнаружил причины собственных сбоев, скорректировал свой подход и сохранил полученные знания без участия человека или настройки. Успешность этого робота на полном рабочем процессе возросла с 28,6 процента в первый день до стабильных 85,7 процента через пять дней.

В задаче, подобной повешению небольших крючков, AgiBot заявляет, что этот метод повысил успех выполнения отдельной задачи на 17,7 процентных пункта по сравнению с традиционной контролируемой тонкой настройкой, и процесс обучения продолжается онлайн.
Похожие сюжеты

Система Genie Master от AgiBot позволяет роботам G2 самостоятельно диагностировать ошибки во время работы в магазине.
Подробнее
pandaily.com

Система Genie Master от AgiBot позволяет роботам G2 самостоятельно диагностировать ошибки во время работы в магазине.

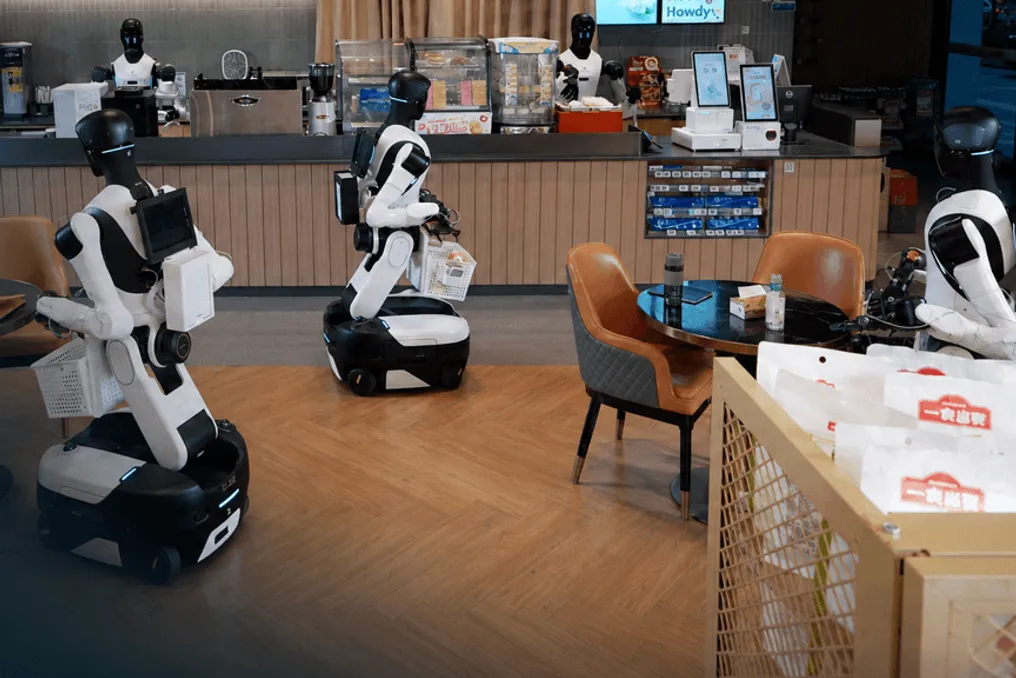
Компания AgiBot представила Genie Master — фреймворк воплощенного агента, который позволяет роботам продолжать совершенствоваться после развертывания, вместо того чтобы ждать, пока инженеры проведут повторное обучение. Компания утверждает, что роботы G2, использующие этот фреймворк, работали в реальном магазине у дома, выполняя задачи по упаковке готовых блюд, подбору товаров и пополнению полок, а также обнаруживая и устраняя собственные режимы сбоев без участия человека в процессе обучения.

AgiBot описывает полученный результат как первое подтверждение концепции, которую они называют Физическое RSI, или воплощенное рекурсивное самосовершенствование, вне симуляционных и лабораторных условий. Один из примеров, представленных на презентации, заключался в том, что робот неоднократно пропускал небольшой крючок на полке из-за того, что ценник загораживал обзор с камеры головы. Проанализировав собственные журналы выполнения, агент определил проблему, изменил подход, поднеся левую руку ближе, чтобы камера запястья могла подтвердить положение крючка, затем взял товар правой рукой и сохранил это исправление для последующего использования.

Этот фреймворк основан на Протоколе воплощенного выполнения (EEP) — унифицированном интерфейсе между агентом и роботом. Он состоит из четырех компонентов: интерфейса возможностей, который сообщает агенту, что робот способен делать; интерфейса руководства для передачи пространственных подсказок, ссылок на объекты и детальных инструкций политике действий; интерфейса обратной связи, который сообщает о физическом результате; и интерфейса непрерывности, который отслеживает прогресс и зависимости задач в рамках всего парка роботов, позволяя возобновить или перепланировать работу после перерывов.

Когда задачи постоянно терпят неудачу или выполняются медленно, агент планирует целенаправленную практику в часы наименьшей загруженности магазина. Улучшение происходит по двум направлениям. RSI, не затрагивающий веса модели, уточняет подсказки, память и правила выполнения, используя ежедневный анализ успехов и неудач для создания того, что команда сравнивает с блокнотом исправленных ошибок. Политика RSI собирает данные из автономных запусков, случаев вмешательства человека и восстановления, фильтрует и перевзвешивает их, а затем переобучает базовую политику действий с использованием обучения с учителем, имитации или подкрепления. AgiBot отмечает, что второй трек все еще использует данные о вмешательстве человека и обучение модели, поэтому люди полностью не исключаются.

Genie Master является четвертым элементом серии релизов AI WAVE от AgiBot, которая началась 22 октября. Согласно опубликованному графику компании, следующим пунктом на 28 октября станет обновление платформы симуляции Genie Sim с внутренним физическим движком, предназначенным для симуляции деформируемых объектов, что, по словам AgiBot, достигает более 95% согласованности между реальными и смоделированными результатами в сложных задачах. Более подробная информация на момент написания не была опубликована.

Публичное тестирование запланировано на 2 и 3 ноября, когда шесть роботов G2 будут работать в течение 24 часов в режиме реального времени в магазине у дома, охватывая пиковые часы обеда и ужина, ночную смену и подготовку к завтраку.

OpenAI विकसित करेगा человекоподобных роботов; первый демонстрационный показ ожидается в 2027 году
Подробнее
www.aajtak.in

OpenAI विकसित करेगा человекоподобных роботов; первый демонстрационный показ ожидается в 2027 году

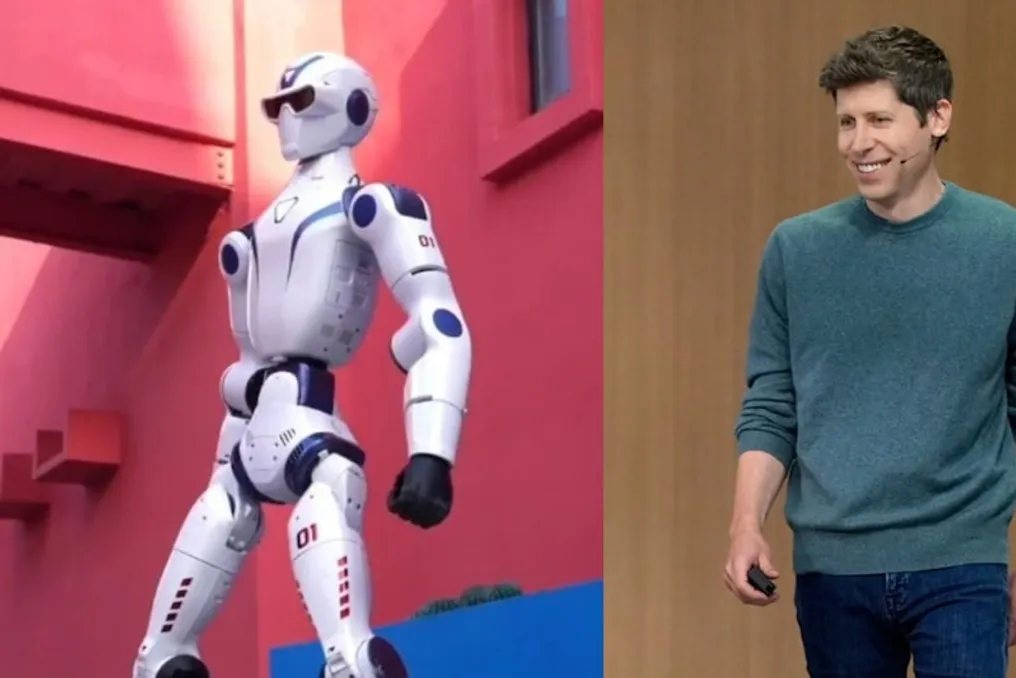
Компания OpenAI, которая создала ChatGPT, планирует заняться еще более масштабным проектом — разработкой роботов, внешне похожих на людей. Особое внимание уделяется не только способности этих роботов двигаться, но и их умению понимать окружающую среду и выполнять задачи.

Генеральный директор OpenAI, Сэм Альтман, дал намеки относительно демонстрации робота. Возникает вопрос о возможностях этого робота и сроках его появления.

Первая демонстрация возможна в 2027 году

Согласно отчету, Сэм Альтман сообщил, что OpenAI может представить демонстрацию своего гуманоидного робота в 2027 году. При этом компания пока не раскрыла полной информации о дате выпуска, цене или характеристиках робота, и это не означает, что он поступит в продажу именно в 2027 году.

Возникает закономерный вопрос о необходимости создания человекоподобных роботов, учитывая, что машины уже существуют. Современные дома, офисы и фабрики спроектированы с учетом человеческой анатомии. Робот, имеющий схожую с человеческой конструкцию, сможет легче функционировать в таких средах.

Однако простое создание человеческого тела недостаточно. Робот должен обладать способностью анализировать происходящее вокруг него и принимать решения о следующих действиях.

Мозг робота будет самым важным

Главная сила OpenAI заключается в ее технологиях искусственного интеллекта. Компания намерена использовать эту технологию для придания роботу разумности. Например, если роботу поручить поднять предмет, он должен сначала распознать этот предмет, понять, как его поднимать, а затем завершить работу. Таким образом, критически важным станет не просто следование заранее заданным командам, а способность робота принимать решения, основываясь на понимании текущей ситуации.

Конкуренция с Tesla?

OpenAI не является единственной компанией, участвующей в гонке гуманоидных роботов. Tesla, возглавляемая Илоном Маском, также работает над своим роботом Optimus. Другие компании также продвигают эту технологию вперед.

На данный момент полная информация о роботе OpenAI отсутствует. Остается наблюдать, что продемонстрирует компания в 2027 году и насколько эффективно ее робот сможет работать в реальном мире.

UBTECH представила Thinker-WM — модель мира, объединяющую видео, глубину и действия роботов
Подробнее
pandaily.com

UBTECH представила Thinker-WM — модель мира, объединяющую видео, глубину и действия роботов

Компания UBTECH раскрыла детали Thinker-WM, модели мира, разработанной ее командой Thinker. Эта модель способна кодировать RGB-видео, метрическую глубину и действия роботов в едином общем представлении. Техническая документация по этой разработке доступна на arXiv.

Согласно заявлениям компании, Thinker-WM заняла первое место в трех бенчмарках для воплощенных моделей мира. Эти рейтинги основаны на результатах, которые были доступны на момент анонса.

Результаты тестирования модели

По данным UBTECH, модель Thinker-WM показала общий результат 0.740 на WorldOlympiad. Этот бенчмарк создан на основе данных реального взаимодействия с роботами и охватывает более десяти роботов и несколько конфигураций камер. Кроме того, модель достигла наивысших индивидуальных показателей по согласованности 3D (0.531) и точности взаимодействия (0.765).

На платформе EWMBench модель продемонстрировала суммарный результат 4.66, опередив такие модели, как Qwen-RobotWorld и Sora 2, причем лидирующие результаты были достигнуты по метрикам динамики и сопоставления траекторий. На симуляционном бенчмарке WorldArena 1.0 Track-1 компания утверждает, что лидировала по 12 различным критериям оценки.

Архитектура и принцип работы

Основной аргумент в пользу разработки Thinker-WM заключается в том, что многие существующие модели мира состоят из отдельных частей: генерация видео отвечает за пиксели, сеть политик — за действия, а отдельный модуль прогнозирует геометрию. UBTECH считает, что такой подход разделяет физически связанные сигналы. Вместо этого Thinker-WM пропускает каждую модальность через собственный кодировщик в общее латентное пространство и совместно моделирует их в рамках Унифицированного Трансформера Динамики, прежде чем декодировать видео, карты глубины и исполняемые действия. Глубина рассматривается как неотъемлемый выходной сигнал, а не вспомогательный.

В экспериментах с одной задачей на RoboTwin было показано, что добавление глубины увеличило успешность манипуляции на 15 процентных пунктов по сравнению с базовой моделью, где глубина отсутствовала.

Благодаря тому, что все модальности используют один набор весов, модель может функционировать в шести различных режимах, включая совместную генерацию видео и действий, прогнозирование будущего, вывод политики, преобразование видео в действия и обратную динамику, просто меняя входные данные и генерируемые выходы.

Данные для обучения

Общий объем обучающих данных составляет около 30 000 часов. Из них примерно 20 000 часов — это видео первого лица, снятое в домашних условиях, розничных магазинах и на фабриках; около 10 000 часов — это данные реальных роботов разных типов; и около 1 000 часов — это симуляционные данные. Все действия роботов представлены в виде поз конечного эффектора с тегом, специфичным для корпуса, что позволяет различным машинам использовать одно и то же пространство генерации. Конвейер данных под названием Data Factory занимается выборкой, многоуровневой проверкой качества и выравниванием глубины и видео.

Чтобы проверить, действительно ли общее пространство связывает модальности, команда обучила небольшой пробный механизм движения на замороженных визуальных признаках для восстановления смещения конечного эффектора, что UBTECH представляет как доказательство кросс-модального связывания.

Популярное