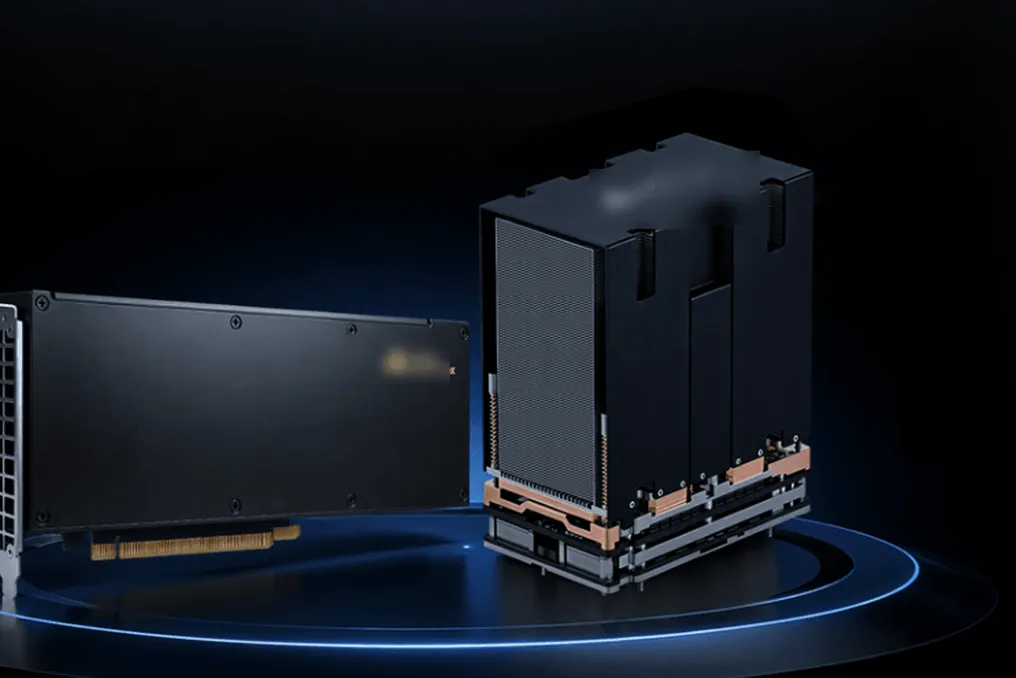
Iluvatar CoreX продемонстрировал работу GPU Tiangai 300, заявив о производительности, превышающей H200 на 1.05x
Подробнее
Pandaily
pandaily.com

Iluvatar CoreX продемонстрировал работу GPU Tiangai 300, заявив о производительности, превышающей H200 на 1.05x

Компания Iluvatar CoreX во время своего медиа-дня, состоявшегося 28 октября в Шанхае, впервые представила общецелевой графический процессор Tiangai 300 в работающем состоянии на реальном оборудовании. До этого момента публичные материалы компании о чипе фокусировались исключительно на архитектуре и дорожной карте, а не на функционирующих системах.

Основным заявлением является сравнение производительности. Iluvatar CoreX утверждает, что Tiangai 300 стал первым отечественным общецелевым GPU, чья измеренная производительность достигает уровня NVIDIA H200. Кроме того, стороннее тестирование, после конвертации данных, показало, что общая пропускная способность одной карты составляет 1.05 раза больше, чем у H200. Важно отметить, что компания не раскрыла методику тестирования, использованные модели или условия рабочей нагрузки, поэтому данный результат пока не может быть проверен независимо.

Этот чип предназначен для внедрения в суперузел IXL144, который ранее был представлен компанией на Китайской международной промышленной ярмарке. Один такой стеллаж IXL144 объединяет 144 GPU, 18 CPU и около 10.1 ТБ памяти GPU, что Iluvatar CoreX называет самым плотным суперузлом GPU в отрасли. По собственным оценкам, такая конфигурация снижает стоимость на миллион эффективных токенов на 40% по сравнению с основными международными решениями.

На открытом дне также была представлена информация о гетерогенном развертывании. Iluvatar CoreX сообщила, что реализовала первую отечественную схему дезагрегации AFD между GPU и XPU, что позволило сократить задержку инференса на 60%. Дезагрегация AFD обычно подразумевает разделение этапов вычислений модели, таких как слои внимания и прямого распространения, между различными типами процессоров, чтобы каждый выполнял ту работу, в которой он наиболее эффективен.

Что касается периферийных устройств, компания заявила, что ее чип Tongyang TY1200 превосходит NVIDIA Thor T5000 в проведенных тестах, опять же без публикации подробностей. TY1200, который ранее был анонсирован с 300 TOPS плотных вычислений для ПК с ИИ и воплощенного интеллекта, также назван первым отечественным периферийным продуктом, способным выполнять симуляцию физики с ускорением GPU на основе MuJoCo-Warp — функция, критически важная для обучения роботов в симуляции.

В целом, эти демонстрации выводят линейку продуктов следующего поколения от Iluvatar CoreX из области бумажных спецификаций к работающим системам. Следующим моментом, за которым стоит следить, станут независимые бенчмарки с раскрытыми рабочими нагрузками.
Похожие сюжеты

ShengShu транслирует процесс обучения Motubrain 2.0 перед открытием модели
Подробнее
pandaily.com

ShengShu транслирует процесс обучения Motubrain 2.0 перед открытием модели

Команда по мировым моделям компании ShengShu Technology начала прямую трансляцию полного процесса обучения Motubrain 2.0, следующей версии ее модели воплощенного искусственного интеллекта для роботов. Трансляция стартовала 21 октября и запланирована на продолжительность около двух недель.

Компания сообщила, что Motubrain 2.0 скоро будет выпущена в открытый доступ, и решила продемонстрировать процесс обучения до этого релиза.

Модели Motubrain представляют собой семейство фундаментальных моделей роботов от ShengShu, цель которых — предоставить роботам универсальный мозг, способный применять навыки в различных задачах, сценариях и на разных типах роботов. Первая версия Motubrain была представлена в апреле как модель мирового действия. Стоит отметить, что ShengShu более известна своими моделями генерации видео Vidu.

Структура трансляции

Прямая трансляция разделена на четыре этапа. Этап предварительного обучения исследует, как масштаб обучения влияет на производительность и способность к обобщению в условиях нулевого выстрела. Последующее обучение фокусируется на выполнении конкретных задач для улучшения исполнения. Затем следует этап задач агента, который проверяет, может ли модель переносить полученные знания на другие задания. Финальный этап посвящен рекурсивному самосовершенствованию, чтобы выяснить, способен ли модель оценивать свои действия на основе обратной связи от выполнения и улучшать их.

На странице трансляции в режиме реального времени отображаются шаги обучения и показатели успешности оценки по мере их обновления.

Основная идея этой демонстрации — прозрачность. Обычно прогресс в области воплощенного ИИ оценивается внешними наблюдателями через отполированные демонстрации роботов, таблицы бенчмарков и научные статьи, которые мало раскрывают, как именно формируются возможности в процессе обучения или какие проблемы возникают. ShengShu утверждает, что трансляция покажет не только успехи, но и ошибки, процесс проб и ошибок, а также корректировки, и надеется поделиться с другими исследователями открытыми вопросами, касающимися масштабирования, кросс-задачного обобщения и автономного улучшения.

Этот шаг соответствует более широкой тенденции среди китайских команд в сфере ИИ, которые публично делятся прогрессом обучения. Ранее Ло Фули, руководитель моделей MiMo от Xiaomi, опубликовал детали этапа обучения с подкреплением для MiMo-V2.6.

Тем не менее, существуют ограничения тому, что может доказать прямая трансляция. Веса модели еще не выпущены, и сама компания заявляет, что исследование остается исследовательским, и результаты потребуют последующих экспериментов и оценки для подтверждения. Анонс был предоставлен ShengShu и освещен китайскими технологическими СМИ. Реальным испытанием станет выпуск в открытый доступ и соответствие его бенчмарков тому, что показано в стриме.

Популярное