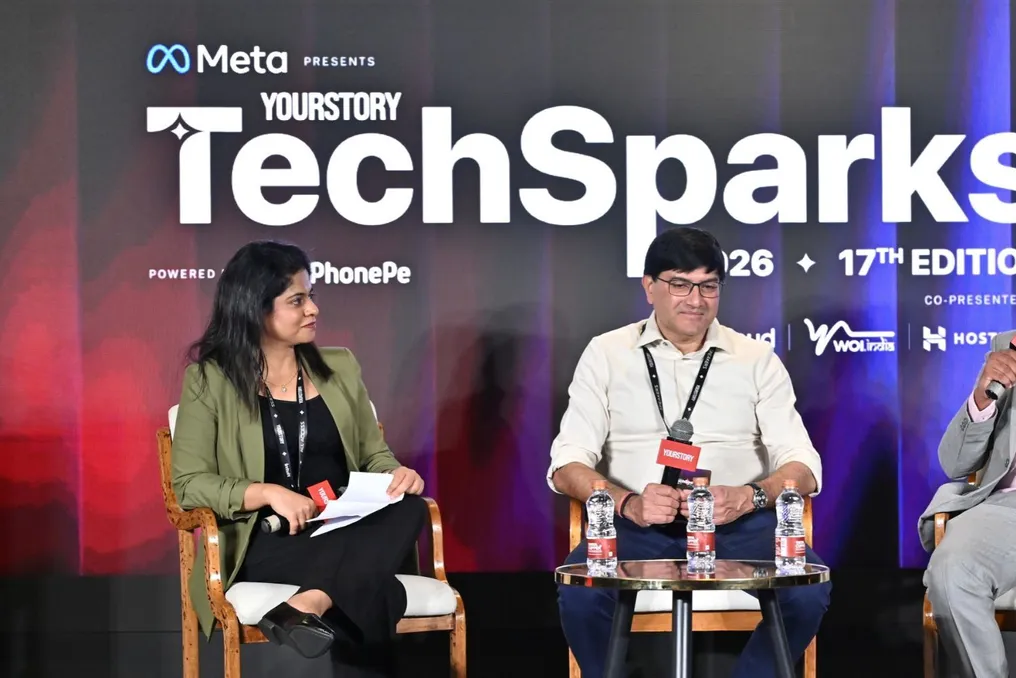
При обсуждении технологической инфраструктуры обычно упоминаются полупроводники, центры обработки данных и модели искусственного интеллекта. Однако, согласно мнению экспертов, решающую роль в работе этих технологий играет лежащий в их основе массив данных, который Индия все еще должна создать.
Во время панельной дискуссии на мероприятии TechSparks 2026, посвященной теме «Невидимая инфраструктура нового технологического порядка», модератор Чави Махаджан из YourStory собрала экспертов. Панелисты подчеркнули, что преимущество Индии будет заключаться в владении надежными, насыщенными контекстом данными в таких областях, как языковой ИИ и биотехнологии.
Арвинд Пани, основатель стартапа CoreMantle, специализирующегося на интеллектуальных данных ИИ, заявил, что данные являются той частью технологического стека, которую невозможно заменить. Он отметил: «Вы можете продолжать заменять вычислительные мощности. Вы можете продолжать заменять приложение, но данные заменить нельзя».
Анкит Багария, соучредитель и генеральный директор Loopworm, компании, занимающейся насекомой биотехнологией, указал, что пробел особенно велик в сфере биофармацевтики, где значительная часть работы до сих пор выполняется методом проб и ошибок. По его словам, улучшенные данные могли бы сократить время вывода продукта на рынок.
Багария также акцентировал внимание на том, что биотехнологиям следует уделять столько же внимания, сколько ИИ, квантовым вычислениям и чипам, особенно после пандемии COVID-19. Он выделил, что Индия импортирует около 73% своих ключевых материалов, включая активные фармацевтические ингредиенты и реагенты, из Китая. При этом, несмотря на то, что страна по объему производит значительную долю мировых вакцин, это составляет лишь около 5% от рынка по стоимости.
Он добавил, что долгое время они работали в сегменте биоаналогов, при этом молекулы открывались кем-то другим. Багария утверждал, что теперь Индии необходимо перейти к разработке лекарств.
Пани согласился, что необходимость локального контекста применима и к языкам. Интернет в Индии изначально был создан для англоговорящих пользователей, что создало два препятствия для большинства граждан: им приходилось изучать и саму технологию, и новый язык. Он отметил, что только около 4–5% населения Индии чувствует себя комфортно, используя только английский язык.
Кроме того, Пани указал, что даже английский язык не является полностью решенной проблемой для ИИ. Модели, обученные преимущественно на американском английском, часто испытывают трудности с австралийскими или региональными акцентами, а английский, на котором говорят в разных штатах Индии, сильно различается. Он заключил: «Это нюансы, которые никто другой не поймет, но Индия поймет».
Оба спикера согласились, что больший объем данных не всегда означает лучший. Пани объяснил, что модели ИИ, построенные на меньшем количестве обогащенных, контекстуальных данных, превосходят те, которые обучались на больших объемах необработанных данных. Он заметил, что многие наборы данных индийских языков записываются в студиях из скриптов, поэтому модели, обученные на них, хорошо работают в контролируемых условиях, но терпят неудачу в реальном общении.
Багария подтвердил эту мысль, заявив, что в отношении биологических данных действует принцип «мусор на входе — мусор на выходе».
Компания Loopworm потратила примерно 12–13 месяцев на очистку существующих данных и создание цифрового инструмента, который отображает внутреннюю работу шелкопряда. Эта работа требовала адаптации к штаммам индийского шелкопряда и патогенам, которые его поражают. Loopworm использует шелкопрядов для производства устойчивого корма для животных и высокоценных рекомбинантных белков.
Багария объяснил выбор шелкопряда тем, что шелк состоит более чем на 98% из белка, что делает насекомое одним из самых эффективных преобразователей листьев растений в белок в природе. Шелкопряд одомашнен около 4000 лет назад, его геном был секвенирован в 2007 году, а около 175 институтов в Индии преподают серикультуру и связанные с ней биотехнологии.
Он добавил, что этот подход, основанный на данных, уже позволил сократить серию экспериментов с 10 месяцев и 25 лакхов рупий до двух с половиной месяцев и примерно 4,5 лакхов рупий. «Я уверен, что через 10 лет мы все будем говорить, что наибольшее влияние ИИ оказал именно на биотехнологии».
Пани отметил, что проприетарные данные уже становятся конкурентным барьером. Он привел в пример юридическую компанию Harvey, которая изменила как свои модели, так и свои вычислительные мощности, сохраняя при этом свои предметно-ориентированные данные в качестве основного преимущества.
О том, что необходимо изменить, Пани заявил, что Индия должна разрабатывать технологии для собственных нужд. Он вспомнил, что его предыдущая компания внедрила поддержку индийских языков в Android в 2011 году в партнерстве с Qualcomm, раньше, чем это сделала Google. «Если мы продолжим думать, что кто-то другой решит нашу проблему, мы всегда будем отставать».
Багария приветствовал государственные инициативы, такие как политика BioE3 и Фонд исследований, разработок и инноваций. Однако он призвал к увеличению государственного и фундаментального финансирования для генерации базовых данных, например, для углубленного секвенирования и характеристики индийских организмов, поскольку традиционные инвесторы вряд ли будут финансировать фундаментальную науку.