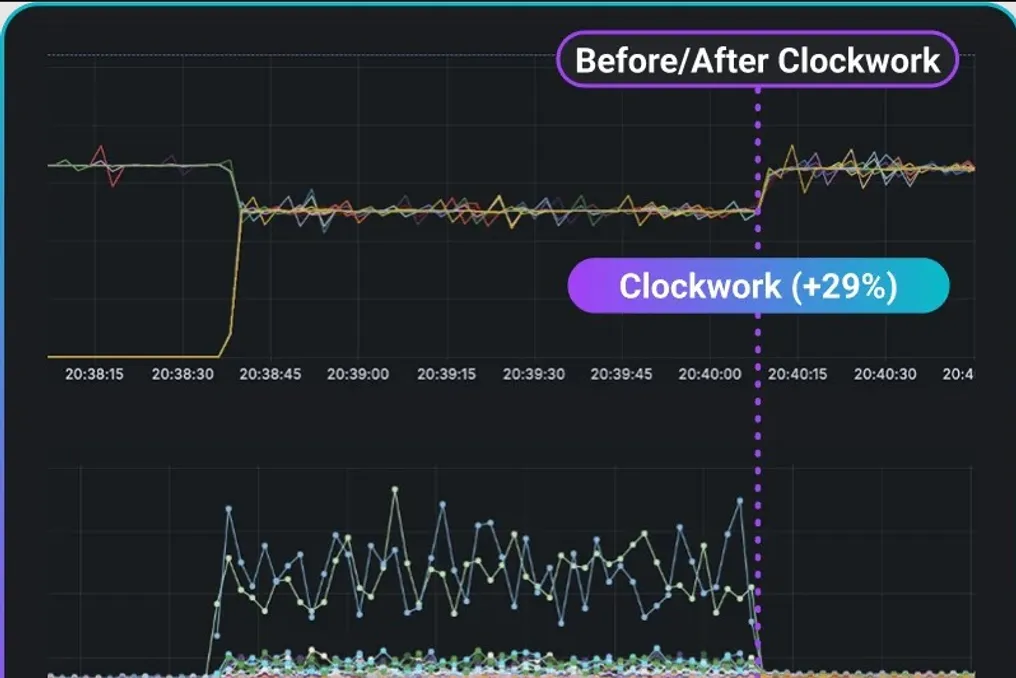
Clockwork.io привлекла 31 миллион долларов нового капитала для борьбы с операционными проблемами, возникающими из-за сбоев в инфраструктуре, которые могут привести к потере огромных объемов вычислительных ресурсов GPU.
Даже незначительный сбой в инфраструктуре способен остановить работу тысяч взаимосвязанных графических процессоров. Во время медленной перезагрузки системы значительные финансовые средства фактически теряются. Компания стремится внедрить передовое программное обеспечение для повышения отказоустойчивости, которое обнаруживает задачу обучения до того, как произойдет фактический отказ оборудования.
Масштабирование искусственного интеллекта является чрезвычайно затратным и сложным процессом. Когда компании обучают гигантские модели на тысячах связанных чипов, абсолютно необходима идеальная синхронизация. Если один только сервер зависает, вся распределенная нагрузка останавливается.
Исторически единственным способом решения этой проблемы была слепая перезагрузка контрольной точки, однако этот неэффективный процесс вынуждает отбрасывать часы ценных вычислений. Например, Meta сообщила, что во время обучения своей модели Llama 3 они сталкивались с непредвиденными сбоями примерно каждые три часа. Продолжение оплаты за простой кремния во время перезагрузки просто неустойчиво в современной высококонкурентной технологической среде.
Решение заключается в том, чтобы перестать пытаться предотвратить отказ оборудования и начать обучать программное обеспечение игнорировать повреждения. Именно здесь проявляется гениальность Clockwork. Их основные инструменты, TorchPass и LinkPass, функционируют как невидимый интеллектуальный буфер между хрупким оборудованием и критически важными рабочими процессами.
Если сетевое соединение внезапно выходит из строя, LinkPass мгновенно перенаправляет трафик. Если GPU начинает выходить из строя во время вычислений, TorchPass плавно передает текущую работу на исправный чип. Кроме того, компания недавно представила функцию, ставшую первой в отрасли, которая позволяет делать снимки многоузловой задачи в процессе работы без необходимости внесения изменений в код разработчиков.
Подтверждением легитимности решения служит его внедрение крупнейшими игроками рынка. Этот подход уже проверен в реальных условиях. Например, LinkedIn использует этот слой отказоустойчивости в своих обширных системах, активно предотвращая десятки тысяч часов неиспользованного времени GPU ежемесячно. Сбои, которые раньше вызывали крупные операционные кризисы, теперь рассматриваются как рутинное обслуживание.
Поставщики облачных решений, такие как Together AI и WhiteFiber, также активно внедряют эту технологию. Они инвестируют в Clockwork.io, поскольку предоставление надежной и бесперебойной вычислительной мощности клиентам составляет основу их бизнес-модели.
Благодаря этому значительному вливанию средств, которое совместно возглавили такие крупные инвесторы, как Premji Invest и Wing Venture Capital, общий объем финансирования компании достиг 73 миллионов долларов. Clockwork.io планирует использовать этот капитал для коренного изменения правил отказоустойчивости инфраструктуры.
По мере экспоненциального роста моделей вероятность отказа оборудования приближается к математической неизбежности. Защита этих колоссальных рабочих нагрузок — это не просто желательная опция, а критически важный механизм выживания. Поддержание активной работы дорогих чипов вместо их простоя в цикле перезагрузки является главным преимуществом для следующего поколения разработки искусственного интеллекта.