Компания Knowin представила фреймворк GLOW для обучения роботов по одному примеру
Подробнее
Pandaily
pandaily.com

Компания Knowin представила фреймворк GLOW для обучения роботов по одному примеру

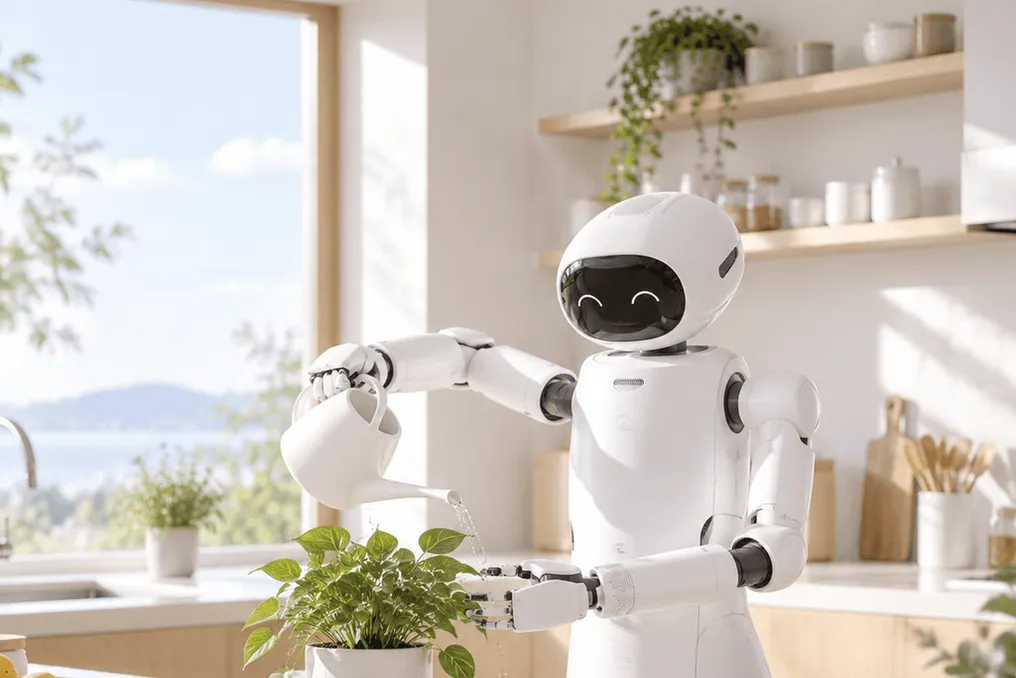
Компания Knowin, специализирующаяся на воплощенном ИИ, опубликовала технический отчет 24 сентября о GLOW, который является сокращением от Generative Learning of World. Этот фреймворк разработан для того, чтобы бытовые роботы могли осваивать новую задачу, основываясь всего на одной полной демонстрации человека. Компания утверждает, что полученный навык затем можно применять к различным объектам, средам и задачам без необходимости повторного обучения или изменения параметров модели.

GLOW состоит из четырех основных компонентов. KnowinGLOW представляет собой унифицированную мультимодальную авторегрессионную модель, которая объединяет понимание визуальной информации, пространственное рассуждение, планирование задач и генерацию действий, напрямую выдавая команды для захвата и позы конечного эффектора. KnowinDream создает физически обоснованный опыт в бытовых условиях, превращая повседневные рутины в симуляции 3D-сцен, после чего варьируются освещение, материалы, объекты и ракурсы камеры. KnowinWorld оценивает вероятные результаты предложенных действий, ранжируя их по прогрессу выполнения задачи, физической согласованности, достижимости и риску. Агент KnowinAgent, также известный как Harness, выступает в роли среды выполнения, управляя памятью, вызовами инструментов, пространственными запросами, обратной связью об исполнении и перепланированием при выполнении длительных задач.

Метод обучения по одному примеру опирается на обучение в контексте. Кодировщик демонстрации сжимает видео одного показа в многократно используемый контекст навыка, который модель комбинирует с текущими видами с камеры, языковыми инструкциями, состоянием робота и историей задачи, при этом веса модели остаются неизменными. Knowin продемонстрировала применение этой технологии в таких сценариях, как хранение коробок, полив растений, протирание стола и смешивание напитков, при этом роботы адаптировались к изменениям в расположении предметов или их положению. Обратная связь по исполнению играет существенную роль: при задаче в одном ящике робот запросил движение на 24,3 мм, но достиг лишь 1,6 мм, обнаружил препятствие и изменил свой подход.

Knowin приводит ряд результатов тестирования на собственных эталонных настройках. На 18 симулированных задачах RoboDojo GLOW показал средний процент успеха 62,2% и балл 71,1, что значительно выше показателей базовой модели на основе GPT-6 (22,2% и 29,8 соответственно). При шести условиях возмущения LIBERO-Pro он достиг среднего показателя 86,7% как единая политика, что является наивысшим среди моделей с одной политикой в сравнительной таблице, хотя некоторые системы агентов с несколькими политиками показали лучшие результаты. Модель KnowinBrain-1.5 занимает первое место среди 20 моделей в рейтинге ответов на воплощенные вопросы Embodied Arena с общим баллом 65,62 по девяти бенчмаркам.

В отчете также отмечены ограничения, включая случаи срабатывания проверок успешности, когда объект все еще находился в захвате, а также то, что подсчет шагов не позволяет проводить строгие сравнения скорости. Knowin была основана в августе 2025 года и занимается разработкой обобщенных воплощенных моделей для потребительского домашнего использования. В ее исследовательской команде работает более 200 человек, а первый продукт компании, Knowin-X1, проходит валидацию перед массовым производством.
Похожие сюжеты

Xiaomi открыла модель воплощенного мирового фундамента и набор для обучения Robotics-U0
Подробнее
pandaily.com

Xiaomi открыла модель воплощенного мирового фундамента и набор для обучения Robotics-U0

Компания Xiaomi сделала доступным для общественности свой продукт Xiaomi-Robotics-U0 — авторегрессивную фундаментальную модель воплощенного мира. Эта модель рассматривает синтез, ориентированный на роботов, не просто как узкоспециализированный процесс генерации траекторий, а как продолжение генерации изображений и видео на основе фундаментальных моделей.

Согласно официальным материалам, основная линия модели содержит около 38 миллиардов параметров и постоянно обучается для достижения воплощенного интеллекта. Дополнительные публичные веса, включая варианты Xiaomi-Robotics-U0-4B и FlashAR, доступны на платформах Hugging Face и ModelScope, а также предоставляется код для инференса, демонстрации через Gradio и релизы обучения FSDP, датированные началом сентября.

В рамках одного фреймворка следующего токена данная модель объединяет несколько функций: генерацию изображений из текста, редактирование изображений из любого источника, создание многовидовых сцен, воплощенный контролируемый трансфер и генерацию воплощенного видео. Xiaomi утверждает, что этот стек сохраняет фундаментальную визуальную семантику, одновременно добавляя способность к рассуждению, ориентированному на роботов, посредством стадий обучения — как одношаговых, так и последовательных. Эти стадии включают потоки подзадач-целей, чередующиеся друг с другом, а также воплощенное видео с частотой 1, 3 и 5 кадров в секунду.

Архитектурные заметки указывают на использование токенизации изображений IBQ и мультимодального словаря, который поддерживает авторегрессивное масштабирование между различными модальностями. Эта архитектура построена на компонентах, происходящих от линий Qwen3-32B и EMU3.5.

Вторым важным аспектом является эффективность инференса. Технология FlashAR+ заменяет последовательное декодирование токенов изображения на антидиагональную параллельную генерацию и используется совместно с пакетной обработкой vLLM. Xiaomi сообщает о возможном ускорении генерации изображений размером 1024x1024 до почти 83 раз быстрее, что снижает задержку для одного образца с примерно 450,8 секунд до 5,44 секунд на заявленном оборудовании.

Страницы возможностей заявляют, что показатели побед в многовидовых сценах и трансфере превосходят GPT-Image-2 при внутреннем разделении данных на сложные и простые. Кроме того, UNIS (Xiaomi-Robotics-U0) занимает первое место среди более чем 100 моделей на WorldArena с показателем EWMScore_P, равным 73,64.

В области применения, данные для переноса стиля из модели смешиваются с реальными демонстрационными наборами для последующего обучения политики. Xiaomi сообщает об увеличении прогресса по задачам вмешательства с приблизительно 36,9% до 63,2% при использовании фонов и освещения, которые не использовались в обучении, при этом снижение по сравнению с базовым лабораторным уровнем было меньшим.

Хотя контрольные точки для генерации видео все еще догоняют релизы изображений и трансфера, команды должны проверить условия лицензирования, выбор движка FlashAR и воспроизводимость WorldArena сторонних разработчиков, прежде чем использовать открытые веса как готовый завод по данным для производственных роботов.

Популярное