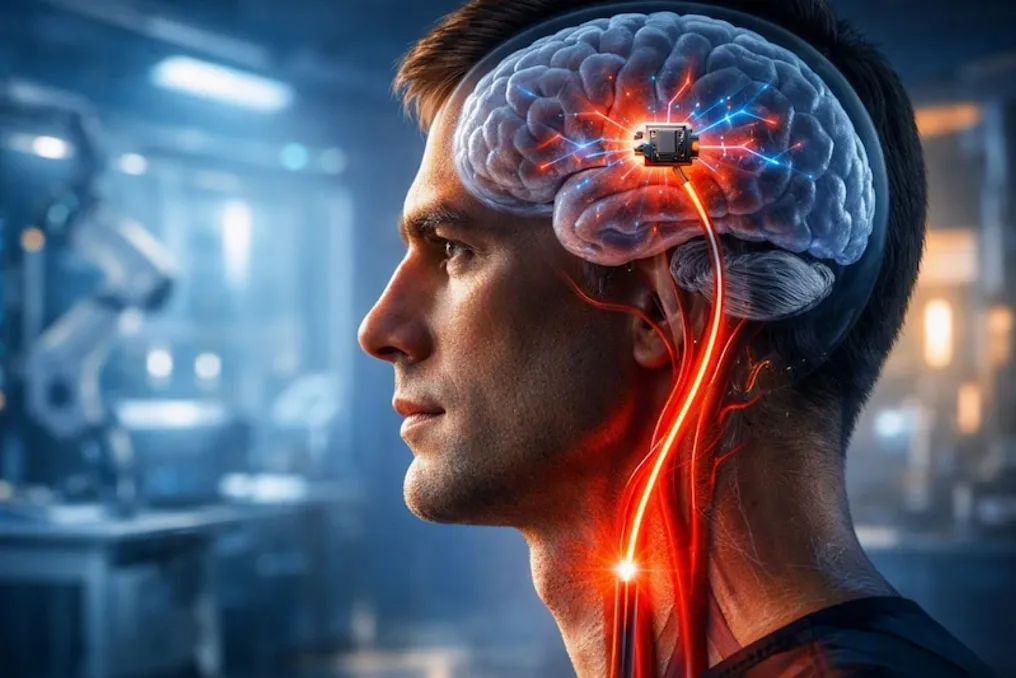
В области медицинской науки и нейротехнологий достигнут революционный прорыв, который способен навсегда изменить жизнь миллионов людей, страдающих параличом. Ранее парализованные пациенты могли общаться, печатая сообщения на цифровом экране или издавая ограниченные звуки, однако теперь они смогут не только говорить, но и совершать жесты.
Ученые из 'Лаборатории Чанга' Университета Калифорнии в Сан-Франциско (UCSF) создали нейронный имплантат, способный декодировать одновременно сигналы речи и движений, исходящие из мозга пациента. Это исследование, опубликованное в журнале New Scientist Journal, вызвало значительный резонанс в мире неврологии.
Исследователи отмечают, что значительная часть повседневного общения зависит от физических жестов; например, кивок головой при слове 'возможно' имеет другое значение, чем наклон головы. Ученые установили микроимплантат размером с iPhone в 'сенсоримоторную кору' двух парализованных пациентов, которая отвечает за речь и движение.
После этого пациентам предложили повторить 10 выбранных фраз (таких как 'привет' или 'приятно познакомиться') и 10 различных жестов (например, рукопожатие или хлопок). На основе сигналов, поступающих из их мозга, была разработана специальная модель машинного обучения на базе ИИ. Эта технология мгновенно декодирует мысли пациента и преобразует их в цифрового 'аватара' на экране, который произносит те же слова и выполняет те же движения, что и задумывал пациент.
Эксперимент был проведен на двух пациентах, которым присвоены названия 'Bravo-1r' (парализован после инсульта) и 'Bravo-6' (страдает моторной нейронной болезнью). Оба пациента полностью утратили способность к физической активности и речи. В случае первого пациента (Bravo-1r) модель ИИ смогла декодировать его жесты с точностью 88%, а сигналы голоса — с точностью 84%. У второго пациента точность составила 66% и 70% соответственно.
Нейроспециалисты из Университета Лозанны в Швейцарии назвали это крайне убедительным и надежным научным достижением. Научный сотрудник UCSF, руководившая исследованием, Саманта Брослер, сообщила, что в настоящее время технология дорабатывается для распознавания большего количества слов и более точных жестов. Конечная цель в будущем — сделать так, чтобы пациенты могли общаться напрямую с помощью синтезированного голоса и собственных мышц и суставов (если они безопасны), без необходимости использования какого-либо 'аватара' или 'экрана'.