Surgiu a questão sobre o estado do nosso senso de responsabilidade em situações em que os sistemas mecânicos não apenas contribuem para a tomada de decisão, mas também para sua justificativa. De acordo com as pesquisas científicas mais recentes, os algoritmos podem atuar não apenas como consultores, mas também como intermediários, aos quais é conveniente delegar aquela parte da escolha associada a dificuldades morais.
Histórias semelhantes
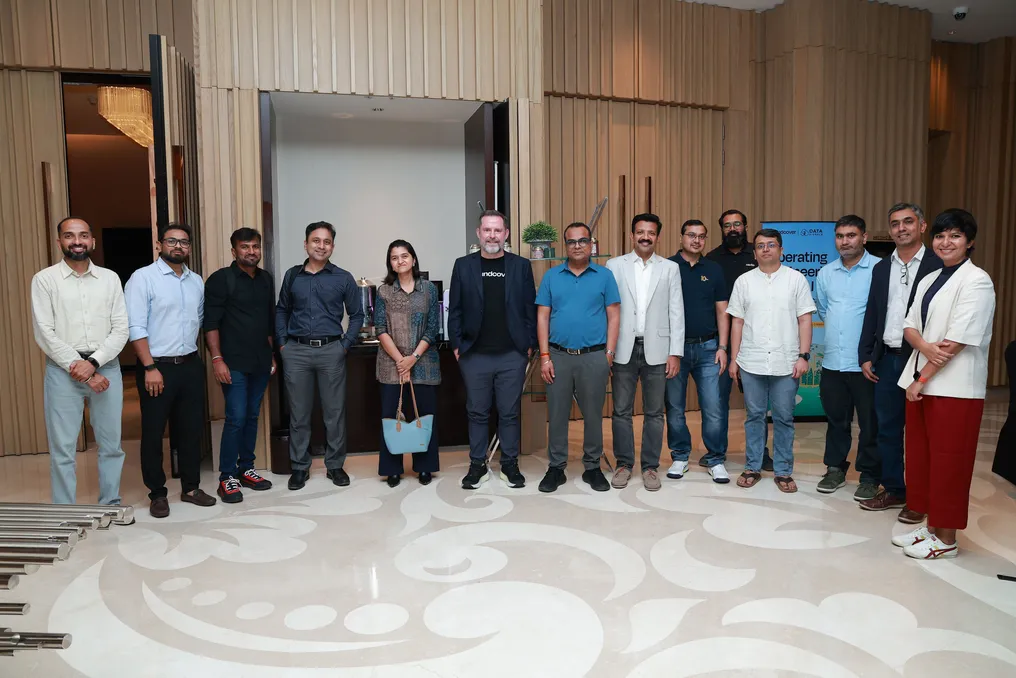
Discussão em mesa redonda de engenharia sobre gerenciamento de confiança e confiabilidade na era da inteligência artificial
A inteligência artificial acelerou significativamente o processo de escrita de código, mas os líderes em engenharia enfrentam uma questão mais complexa: o que acontece após a conclusão da codificação. Em uma mesa redonda dedicada às operações na era da IA, líderes de setores como logística, tecnologia de alimentos, saúde, telecomunicações, fintech, comércio eletrônico e educação superior trocaram experiências sobre como escalar com IA, mantendo ao mesmo tempo a confiabilidade, segurança e controle.
A conclusão geral dos participantes foi que a velocidade deixou de ser o principal problema; agora, o aspecto chave é gerenciar esse processo. A moderadora da mesa redonda foi Ipsita Basu, e entre os participantes estavam especialistas como Manjunath Nakshatri (líder de engenharia da Mojro), Shobhit Suman (CPO da HungerBox), Pawan Kumar A T (CTO da Digii/DigiiCampus), Pranjal Nadani (cofundador e CTO da Cautio), Kenil Paul (vice-presidente de tecnologia e soluções da 6D Technologies), Rimjim Agrawal (cofundador e CTO da BrainSightAI), Dhruv Rastogi (diretor principal de IA da MediAssist), Chandrakesh Pandey (vice-presidente sênior de tecnologia da Niyo Solutions Inc.), Achal Sharma (CTO da TechnoSport), Sunil Kumar (diretor de engenharia da Meesho) e Anshul Sharma (diretor de engenharia da Scaler).
O evento foi organizado pelas empresas groundcover e Data Signals com o apoio da YourStory. Do lado dos organizadores estavam Paul Trebe (líder de vendas e parcerias da groundcover) e Satish Dange (fundador da Data Signals).
Os participantes concordaram que a IA reduziu o tempo de compilação, mas a pressão mudou para as etapas subsequentes. Quando os agentes geram grandes volumes de código, surgem questões sobre quem irá verificar, testar e controlar dezenas de implantações diariamente. Muitos líderes observaram que suas equipes agora gastam mais tempo no desenvolvimento do conceito, contexto e gerenciamento do que na escrita direta dos componentes. A eficácia dos agentes depende diretamente da qualidade do contexto recebido, e poucas organizações possuem conhecimento de repositório, documentação e modelos em um formato que o agente possa usar de forma confiável.
Durante a discussão, chegou-se a um consenso sobre uma abordagem progressiva: tarefas reversíveis e somente leitura, como obtenção de dados ou criação de relatórios, podem ser delegadas aos agentes com mínimas dificuldades. No entanto, ações irreversíveis, como exclusão de dados ou atualização de banco de dados, devem permanecer sob controle humano. A avaliação do raio de impacto também é importante; se uma chamada errônea puder afetar usuários finais ou sistemas de produção, isso deve ser feito por um humano.
Um dos participantes descreveu o modelo de «quatro olhos», onde a IA realiza o trabalho de leitura e análise, regras determinísticas fornecem respostas claras de «sim» ou «não», e a aprovação final é dada por um humano. Outro palestrante propôs um sistema de avaliação de riscos baseado na gravidade e frequência de ocorrência, permitindo concentrar o controle humano em elementos de criticidade média e alta. Alguns traçaram uma linha pela especialização, permitindo que os engenheiros usassem agentes livremente em sua área, enquanto a responsabilidade pela produção permanece com pessoas capazes de resolver problemas a qualquer momento.
Surgiu também um cenário mais otimista: em vez de acordar um engenheiro, o agente pode investigar um incidente e fornecer um relatório pela manhã, deixando a decisão para o humano. Os participantes enfatizaram que a confiança será construída gradualmente, assim como ocorreu com pagamentos online, e essa fronteira continuará a mudar.
A questão da responsabilidade recebeu um forte acordo: este dever não pode ser delegado a um modelo. Os líderes permanecem responsáveis pelas ações dos agentes. Um participante observou que a IA atua como um multiplicador de inteligência, o que significa que os erros são amplificados tão rapidamente quanto as boas soluções.
A discussão sobre a obsolescência de habilidades gerou debates mais acalorados. Alguns viram nisso apenas uma mudança nas competências exigidas, semelhante à forma como a aritmética mudou com o advento das calculadoras. Outros, especialmente no setor de saúde, temiam a perda de experiência necessária para avaliar os resultados do trabalho da IA. Uma solução prática foi definir conscientemente as áreas onde a IA faz rascunhos e onde os humanos executam o trabalho.
Para líderes dos setores de telecomunicações e saúde, o controle dos dados é determinado na fase de projeto. Os modelos não podem simplesmente operar em nuvem pública se regulamentações, requisitos de separação de espaços de arrendamento e regras de residência forem aplicados, pois um erro pode levar a multas graves. Outros enfatizaram o gerenciamento desde o início, abrangendo os dados recebidos, o que é usado para treinamento versus saída, bem como métodos de mascaramento ou desidentificação de dados. Preocupações com propriedade intelectual e viés também levaram a um apelo para avaliar ferramentas de IA com o mesmo rigor que novos funcionários.
A Observabilidade permeou todos os tópicos discutidos. As equipes falaram sobre a necessidade de rastrear entradas, decisões e transferências de tarefas pelos agentes para entender a causa de suas ações e corrigi-las. Uma equipe de comércio eletrônico aprendeu o preço de investimentos insuficientes: uma alteração de classificação deixou todos os painéis de controle verdes até que o impacto nos negócios se manifestasse dias depois, e a análise da causa raiz levou mais de uma semana. Desde então, eles criaram um registro de mudanças, um sistema de origem, um grafo do sistema e um agente de depuração que sugere hipóteses ranqueadas.
Do ponto de vista da observabilidade, ela não pode mais existir separada do desenvolvimento. Paul Trebe declarou diretamente: «Você não pode mais separar a observabilidade do desenvolvimento». Ele acrescentou que os agentes precisam de dados ricos em contexto para agir corretamente, e os próprios agentes devem ser monitorados, pois os rastreamentos de IA podem atingir 500.000 linhas, que realisticamente só podem ser analisadas por outros agentes.
Ninguém apresentou um guia pronto. Permanecem abertas questões sobre métodos de medição da confiabilidade dos agentes e retorno sobre o investimento, proteção de dados e propriedade intelectual, bem como sobre manter a agudeza suficiente nos engenheiros para contestar os resultados do trabalho da IA. No entanto, a conversa apontou para uma direção geral: dar aos desenvolvedores a capacidade de avançar rapidamente, mas primeiro construir barreiras de proteção. O controle humano deve ser mantido sobre decisões irreversíveis e de alto risco, e a automação deve se expandir à medida que a confiança for conquistada. Muitos participantes afirmaram que a inação é inadmissível, pois os concorrentes não esperarão. O verdadeiro teste da era da IA não é quão rápido as equipes podem construir, mas quão confiantes elas podem operar o que construíram.
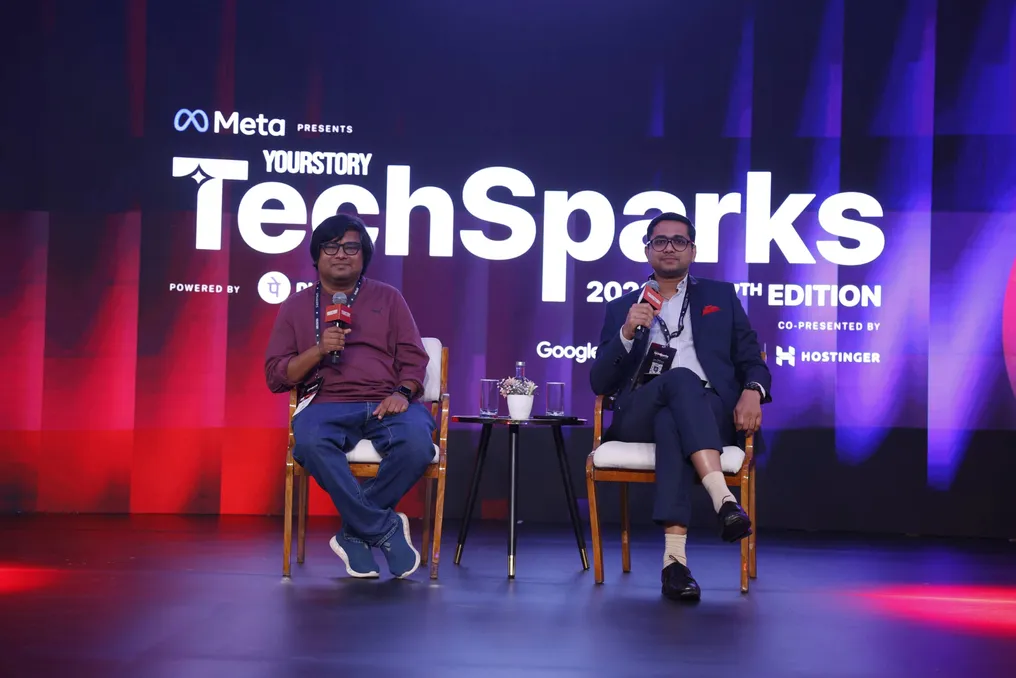
Vignesh Subrahmaniam da Intuit discute a transição do engenharia de prompts para a criação de sistemas de inteligência artificial funcionais
Nos últimos anos, a melhoria dos resultados com IA dependeu da capacidade de escrever solicitações (prompts) de maior qualidade. No entanto, essa paradigma está mudando rapidamente, à medida que os sistemas de IA começam a raciocinar, tomar decisões e executar ações dentro de fluxos de trabalho inteiros de forma autônoma.
No evento TechSparks 2026, o principal evento da YourStory, o Dr. Vignesh Subrahmaniam, pesquisador sênior de IA na Intuit, conduziu uma conversa com Aditya Charlie, editor-chefe da YourStory e The CapTable. A discussão, intitulada «Além do Prompt: Criando IA que Pensa, Age e Aprende», abordou o que os desenvolvedores precisam repensar à medida que a inteligência se torna cada vez mais autônoma.
A sessão começou com perguntas sobre o dia de trabalho típico de Subrahmaniam e um pedido para simplificar os conceitos de fintech e IA para o público. Ele usou uma analogia com xadrez, perguntando: se um algoritmo não for ensinado as regras do xadrez, mas sim mostrado um milhão de partidas concluídas com vencedores, ele será capaz de deduzir tanto as regras quanto as estratégias mais prováveis para vencer?
A equipe da Intuit aplica uma abordagem semelhante para apoiar pequenas empresas, pois a empresa atende tanto consumidores quanto contadores. Subrahmaniam observou: «Assim como estudamos o jogo dos negócios, analisando dados, ações reais e resultados que as empresas tomam». O objetivo é entender os fatores que levam ao sucesso empresarial na aquisição de clientes, crescimento rápido e melhoria do fluxo de caixa.
Em seguida, a conversa passou para a mudança de paradigma para os desenvolvedores: de estudar por muitos anos a escrita de prompts mais inteligentes para projetar agentes que têm um objetivo e determinam os passos para alcançá-lo. Subrahmaniam comparou a engenharia de prompts com a longa história das linguagens de programação, desde o código binário e assembly até Fortran, C e Python. Os grandes modelos de linguagem permitiram que qualquer pessoa programasse em inglês simples, mas este método tem suas limitações.
Os pesquisadores rapidamente perceberam que a inteligência não deveria residir apenas no modelo. O modelo deve atuar como um orquestrador, dividindo uma tarefa complexa em uma sequência de ações e chamadas de ferramentas. A inteligência real move-se para as ferramentas que são chamadas; e essas ferramentas também devem ser projetadas de forma diferente: «não para que um humano, ou um desenvolvedor de software, ou qualquer outra pessoa possa usá-las, mas de modo que o orquestrador LLM possa realmente usá-las».
Isso exige a criação de ferramentas de alta precisão com resultados extremamente determinísticos. Para os desenvolvedores, a maestria muda de formulações espirituosas para componentes confiáveis que o modelo pode chamar repetidamente sem surpresas.
Sobre fontes de novos dados, Subrahmaniam declarou abertamente que o treinamento em dados textuais está em grande parte resolvido. O desafio mais complexo é treinar em fontes multimodais e ações reais. Ele deu o exemplo de como uma criança pequena aprende principalmente através do que vê, ouve e observa, e não através da leitura, afirmando que incluir tais sinais do mundo real nos sistemas de IA ajudará os modelos a ir além da geração de texto e começar a sugerir ações. Ele chamou isso de próximo marco.
Ao considerar os problemas de setores regulamentados, ele levou o público de volta a 18 anos atrás, a um dos primeiros laboratórios de aprendizado de máquina em Bangalore, onde trabalhou com regressão logística e perceptrons multicamadas. Naquela época, o maior problema não era o próprio algoritmo. Ele lembrou: «Na verdade, era a qualidade dos dados».
Este problema não mudou. Independentemente de a equipe estar treinando regressão simples ou ajustando um transformador, o princípio de «lixo na entrada, lixo na saída» permanece válido. Segundo ele, as empresas capazes de coletar, agregar e armazenar dados da mais alta qualidade obterão vantagem.
Durante uma breve sessão de perguntas e respostas, um participante perguntou como as restrições de armazenamento de dados financeiros afetam o trabalho da Intuit. Subrahmaniam nomeou o consentimento como a base de qualquer sistema de treinamento e citou um estudo de Framingham, onde os residentes da cidade de Massachusetts permitiram que os médicos monitorassem sua saúde ao longo do tempo, o que moldou a compreensão moderna de doenças cardiovasculares. Ele acrescentou que as empresas também são obrigadas a explicar ao público em geral os benefícios do uso de dados.
À medida que a conversa terminava, a ideia central foi que, à medida que a IA passa de reativa para proativa, os fundamentos se tornam mais importantes do que a interface. Os prompts permanecerão sendo o ponto de partida, mas o verdadeiro trabalho agora reside na criação de ferramentas confiáveis que os agentes podem chamar, no fornecimento de dados de alta qualidade aos sistemas e na obtenção do consentimento que lhes permite aprender. É aqui, além do prompt, que a próxima onda de IA será ganha pelos desenvolvedores.

Por que os clientes continuam se sentindo ignorados, mesmo quando a automação funciona conforme o planejado
Apesar da automação estar presente em todos os lugares, isso não garante que ela traga benefícios aos clientes. Um chatbot que não consegue responder a uma pergunta, um menu de resposta de voz interativa (IVR) inadequado para o problema ou uma resposta automática que leva a um beco sem saída podem transformar uma solicitação simples em uma experiência extremamente desagradável. Embora a interação possa ser contabilizada como concluída no papel, para o cliente, não é assim.
De acordo com o relatório CallMiner CX Landscape Report 2026, existe uma lacuna significativa. Enquanto 99% das organizações utilizam automação nas interações com clientes, apenas 23% afirmam que esses processos são simultaneamente altamente automatizados e continuamente otimizados com base nos dados de experiência do cliente (CX). Além disso, apenas 24% descrevem a experiência do cliente recebida como verdadeiramente positiva. Assim, a tarefa mudou da implementação da automação para garantir que ela atenda às necessidades atuais dos clientes.
O que define as tecnologias de automação CX?Apesar da tentação de ver essa lacuna como um problema puramente tecnológico que pode ser resolvido substituindo a plataforma ou usando um modelo mais inteligente, as organizações que eliminam essa lacuna nem sempre usam as ferramentas de automação mais recentes. Elas aprimoram continuamente a automação, utilizando feedback e dados obtidos de conversas reais, em vez de dependerem de suposições feitas durante o desenvolvimento inicial do fluxo de trabalho.
Sem esse direcionamento, a maioria das equipes recorre a um dos três hábitos reativos. Alguns continuam configurando o sistema sem saber o que está falhando. Outros abandonam completamente a plataforma e começam tudo de novo, esperando que a nova tecnologia resolva um problema que nunca foi diagnosticado. Os terceiros retornam ao atendimento baseado exclusivamente em humanos, desfazendo investimentos de muitos anos em CX. Todas as três abordagens pulam a mesma etapa crítica: entender a essência do problema na própria conversa.
Como a análise do cliente muda a abordagem de trabalho?A análise do cliente forma uma visão holística do que acontece em todas as interações com os clientes, transformando a automação de tática em estratégia. Ela permite ver onde a automação realmente ajuda e onde a organização simplesmente supõe sua utilidade. Essa ferramenta identifica sinais comportamentais e contextuais, como contato repetido sobre o mesmo tópico ou mudança de humor no meio de uma conversa, que um perfil estático do cliente não conseguiria captar. Além disso, ela conecta métricas técnicas, como taxas de retenção e abandono, com indicadores de resultado, como satisfação do cliente (CSAT) e resolução no primeiro contato, prevenindo situações em que um painel de controle bem apresentado esconde um cliente insatisfeito.
Essa diferença é mais importante do que frequentemente reconhecida. Uma alta taxa de retenção não garante um resultado positivo. Um bot pode concluir tecnicamente a interação, mesmo que o cliente saia sem solução. A análise de conversas revela essa lacuna, mostrando o que aconteceu durante a interação, em vez de apenas constatar se ela terminou sem intervenção humana. Isso se aplica tanto a empresas que estão refinando a automação antiga quanto a equipes que estão implementando seu primeiro agente virtual. A questão principal não é: 'Automatizamos o suficiente?', mas sim: esta automação é baseada no que os clientes dizem hoje, e não no que eles disseram ao criar o fluxo de trabalho.
Medir a eficácia da automação além da mera eficiência. Isso não significa que a eficiência deixe de importar. Significa que as estratégias de automação mais fortes reduzem esforços desnecessários tanto para clientes quanto para funcionários, ao mesmo tempo em que protegem os momentos em que o julgamento humano e a empatia criam o maior valor. O cumprimento correto desse equilíbrio distingue a automação que os clientes toleram da automação em que eles confiam.
Um novo documento técnico da empresa explica como usar a análise de conversas para determinar onde a automação deve ser aplicada, projetar a experiência em torno do comportamento real do cliente e medir o sucesso com base nos resultados com o cliente, e não apenas em métricas técnicas. O documento completo está disponível, demonstrando como uma organização implementou esses princípios, reduzindo o tempo de processamento de chamadas em 78% ao dobrar a capacidade sem aumentar o quadro de funcionários.