Nitin Vagulde da VeloDB explica os motivos das falhas dos agentes de IA após a fase de demonstração
Leia mais
YourStory [india, en]
yourstory.com

Nitin Vagulde da VeloDB explica os motivos das falhas dos agentes de IA após a fase de demonstração

Agentes artificiais frequentemente demonstram bons resultados na fase de teste piloto, pois nessas condições o escopo de aplicação é estreito, os dados são controlados e as solicitações são previsíveis. No entanto, o ambiente de produção é diferente, e essa lacuna leva ao encerramento de muitos projetos.

A Gartner prevê que até o final de 2027, mais de 40% dos projetos de IA de agentes serão cancelados devido aos custos crescentes, valor de negócio incerto ou controle de risco insuficiente. Na opinião de Nitin Vagulde, diretor regional para a Ásia-Pacífico na VeloDB, uma parte significativa do problema não reside no modelo em si, mas sim no nível dos dados.

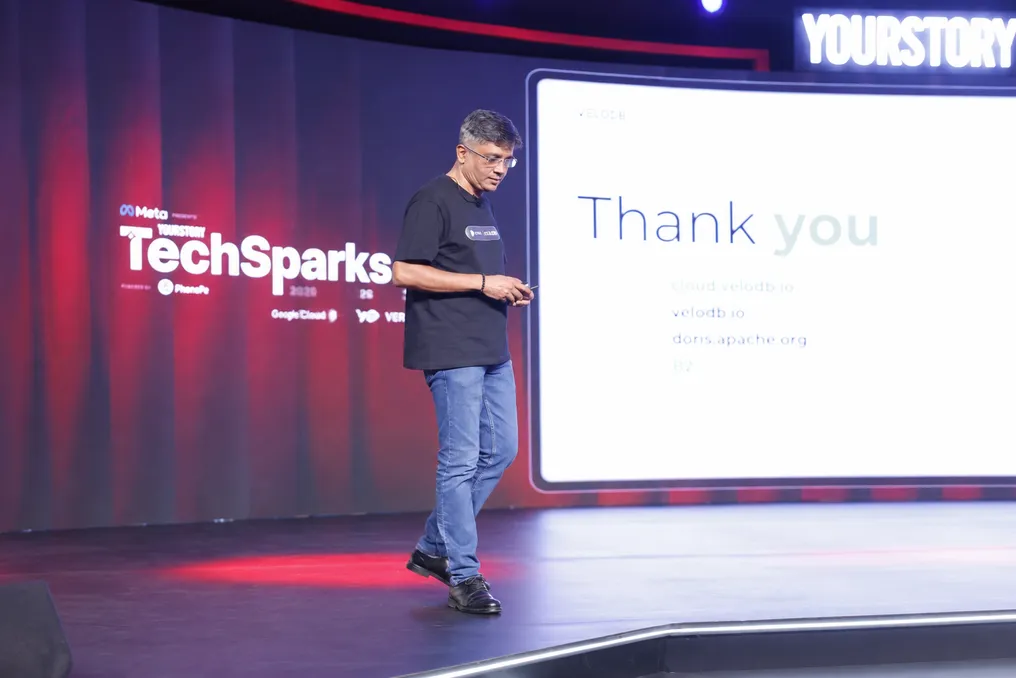
Em sua apresentação intitulada 'Agentes de IA em Escala: Sobrevivência Após a Demonstração', Nitin detalhou como os agentes de IA utilizam os dados de maneira diferente dos humanos, o que eles precisam para operar de forma confiável em grandes volumes e como as empresas estão reestruturando sua infraestrutura de dados para suportar esses sistemas.

Nitin começou com um exemplo: em um sistema tradicional, um gerente poderia obter dados de vendas do ano anterior executando um relatório pronto. A situação muda drasticamente quando você pede a um agente de IA para explicar a queda nas vendas nos últimos três trimestres. O agente é forçado a extrair registros de pedidos dos sistemas ERP e CRM, analisar tickets de suporte e chats em busca de problemas de clientes importantes, e também estudar relatórios de vendas sobre a dinâmica territorial. Se suas deduções forem incompletas, ele solicita informações adicionais.

Ele observou: 'O que antes era concluído com uma simples pesquisa ou uma simples solicitação, agora exige centenas de operações de pesquisa para obter a mesma informação'. Anteriormente, os principais consumidores de dados de negócios eram pessoas e relatórios, e os sistemas eram construídos em torno de relatórios fixos com limites claros.

Agora, segundo Nitin, a IA se tornou um novo cliente desses dados, e ele se comporta de maneira completamente diferente. Os agentes operam 24 horas por dia, fazem múltiplas perguntas simultaneamente e funcionam em um ciclo iterativo: perguntar, pensar, pesquisar e repetir tentativas até obter uma resposta. Suas perguntas também não são pré-escritas, o que cria uma carga forte e imprevisível na camada de dados.

A complexidade é agravada pelo fato de que os dados de negócios estão distribuídos em vários locais: registros transacionais, memória de chat, documentos, painéis de controle e armazenamentos vetoriais para busca semântica. O agente precisa procurar em todas essas fontes e consolidar os resultados antes de fornecer uma resposta.

Cada solicitação adicional de dados aumenta os custos. Se os dados estiverem desatualizados, a resposta será incorreta. Nitin comparou isso a dirigir com um mapa de tráfego impreciso. Além disso, quando os dados vêm de múltiplas fontes, torna-se mais difícil determinar a origem da resposta, o que gera um problema de confiança.

Ele comparou essa situação a enviar uma pessoa para cinco armários de arquivo para coletar papéis. Quando a pessoa retornar do quinto armário, a informação do primeiro pode já estar desatualizada.

Nitin delineou quatro requisitos que os agentes devem atender para passar do modo piloto para a operação completa. A resposta da VeloDB é um motor unificado que atende a todas essas necessidades. A empresa foi fundada em 2023 por desenvolvedores originais do Apache Doris, um banco de dados de código aberto para análise em tempo real que se tornou um projeto de nível superior da Fundação Apache Software em junho de 2022. De acordo com a VeloDB, o Apache Doris possui mais de 14.000 estrelas no GitHub e 700 contribuidores, e é usado por mais de 5.000 empresas em todo o mundo.

Para reduzir o número de consultas de retorno que retardam o trabalho dos agentes, a VeloDB suporta consultas híbridas. Uma única consulta pode combinar SQL, busca vetorial e busca de texto, executando buscas determinísticas e probabilísticas em paralelo. O resultado é uma fonte única e confiável em vez de dados dispersos.

Nitin apresentou dois exemplos de empresas que usam tal arquitetura em suas operações. A primeira é uma das maiores bolsas de criptomoedas com mais de 120 milhões de usuários, que ele não nomeou. A bolsa fornece dados de transações aos agentes de IA, que podem ser solicitados por investidores de varejo, por exemplo, para ver as posições de grandes traders em algum ativo. Ele relatou que seus agentes processam cerca de 33.000 diálogos com uma latência final de cerca de 3 milissegundos, operando 24 horas por dia.

O segundo exemplo é a empresa chinesa de IA MiniMax, que listou na Bolsa de Valores de Hong Kong em janeiro de 2026 e atende 212 milhões de usuários em mais de 200 países. A MiniMax reestruturou seu sistema de logging para o Apache Doris após abandonar o Grafana Loki, pois os logs se tornaram uma fonte valiosa de informação que merecia ser preservada e consultada.

Nitin especificou que a MiniMax carrega dados a uma velocidade de 10 Gbps e pode consultar cerca de 10 petabytes em menos de dois segundos, reduzindo os custos em 70%. A VeloDB informou separadamente que o sistema baseado em Doris agora suporta logs em todas as áreas de negócios da MiniMax em escala de petabytes com disponibilidade superior a 99,9%.

Os mesmos problemas são relevantes para startups em estágios iniciais que criam agentes, acrescentou Nitin. A VeloDB colabora com startups de fintech que enfrentam os mesmos problemas de escalabilidade que a MiniMax ou a bolsa de criptomoedas, apenas em um estágio mais inicial.

Sua tese final foi que os agentes sempre farão centenas de perguntas, portanto, a infraestrutura deve garantir que cada uma delas seja barata, rápida e atual. Para Nitin, a escalabilidade dos agentes de IA depende menos da busca pelo melhor modelo e mais da fornecimento de dados confiáveis em tempo real de uma fonte unificada. Ele afirmou que as empresas que configurarem corretamente o nível de dados poderão tomar decisões mais rapidamente, reduzir custos e migrar seus agentes do modo piloto para a operação de trabalho com confiança.

Histórias semelhantes

Queda do índice Nasdaq em meio a preocupações com gastos com IA e expansão de data centers
Leia mais
techcentral.co.za

Queda do índice Nasdaq em meio a preocupações com gastos com IA e expansão de data centers

O índice Nasdaq caiu significativamente após seu fechamento recorde na quinta-feira, perdendo mais de 10%. Este movimento indica um possível início de correção, impulsionado pela preocupação com os custos maciços de inteligência artificial e o aumento do controle sobre a expansão dos centros de dados.

O índice composto Nasdaq, que depende fortemente do setor de tecnologia, caiu quase 4% durante o pregão diário em Nova York. Essa queda ultrapassou 10% do máximo recorde de fechamento atingido em 6 de outubro.

A queda na quinta-feira apagou os ganhos diários anteriores, já que os democratas venceram em ambas as câmaras do Congresso. Os investidores começaram a avaliar o potencial de uma atenção mais rigorosa à futura construção de infraestrutura para IA.

Samir Samana, estrategista sênior de mercado global no Wells Fargo Investment Institute, observou que a transição de um controle unificado total de um partido para um controle unificado total de outro pode causar incerteza significativa, ruptura e uma mudança brusca de política.

Ele acrescentou que quando parecia que os democratas obteriam uma maioria significativa tanto na Câmara dos Representantes quanto no Senado, os analistas previram que isso levaria pelo menos a uma pausa temporária nos mercados.

A queda de 10% do último máximo recorde é amplamente vista como uma correção e será a segunda correção do Nasdaq neste ano. Nos últimos dias, o sentimento em relação às ações relacionadas à IA piorou, e o Nasdaq perdeu mais de 2,5 trilhões de dólares em valor de mercado em outubro.

Várias grandes empresas de tecnologia estão recorrendo aos mercados de dívida para financiar investimentos multimilionários planejados em data centers, chips e outra infraestrutura necessária para o desenvolvimento de IA.

Os investidores estão cada vez mais questionando a velocidade com que esses investimentos se transformarão em lucros, especialmente diante da tensão geopolítica persistente no Oriente Médio e das preocupações com inflação prolongada, que sustentam taxas de juros elevadas.

Os relatórios publicados no mês passado pelas empresas Alphabet e Meta, dois dos maiores hyperscalers envolvidos na criação e operação dos maiores data centers do mundo, não conseguiram tranquilizar os investidores sobre o retorno dos gastos com IA, o que contribuiu para uma venda geral de ativos relacionados à IA.

O principal problema da inteligência artificial não está no modelo em si, mas na infraestrutura de dados
Leia mais
yourstory.com

O principal problema da inteligência artificial não está no modelo em si, mas na infraestrutura de dados

Apesar da crescente disponibilidade de modelos de inteligência artificial, transformar esses modelos em produtos comerciais confiáveis continua sendo um desafio complexo, especialmente quando as empresas enfrentam uma infraestrutura de dados fragmentada.

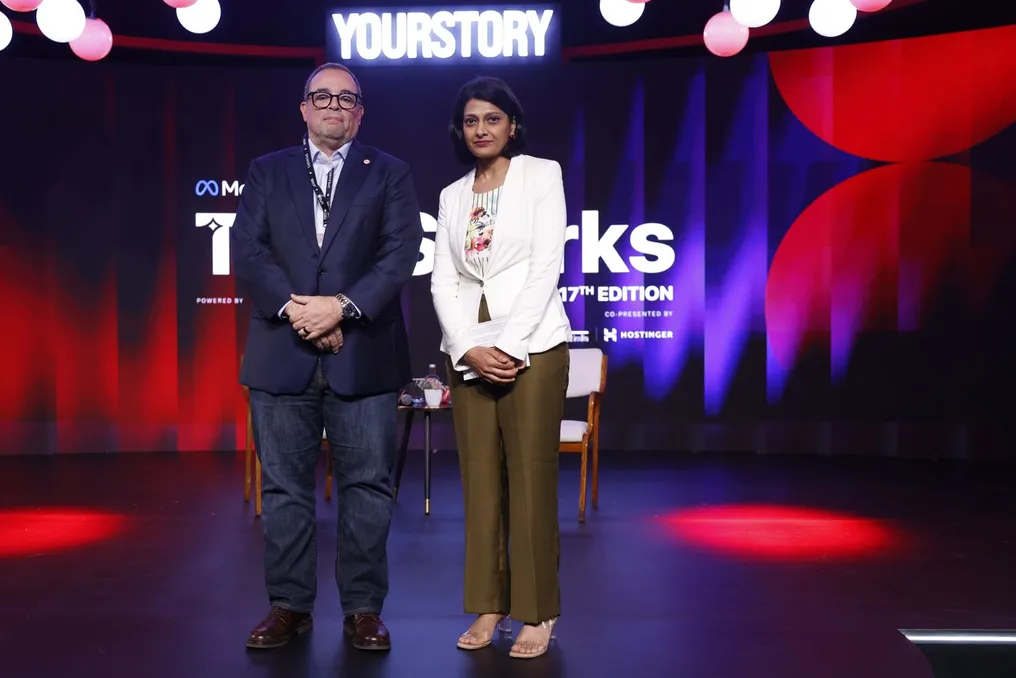
No evento TechSparks 2026, Michael Cronin, vice-presidente de vendas para a Ásia-Pacífico, Japão e Índia da Couchbase, participou de um debate com Shivani Mutanna, diretora sênior de conteúdo estratégico e vídeo da YourStory. Eles discutiram a transição da IA da fase de experimentação para a produção completa, os desafios de gerenciamento, a experiência do cliente e o papel crescente da Índia nas inovações de IA.

Durante décadas, grandes corporações implementaram vários bancos de dados e soluções altamente especializadas para resolver tarefas específicas. Embora cada uma delas resolvesse um problema imediato, o resultado era frequentemente um nível de dados fragmentado, composto por múltiplos sistemas que interagem mal entre si.

Cronin considera essa fragmentação um sério obstáculo para a adoção de IA. Ele cita estimativas do setor de que 70-80% dos projetos de desenvolvimento de IA nunca chegam à fase de produção, e uma pesquisa do MIT mostrou que 95% desses projetos não se tornam lucrativos.

A plataforma operacional de dados da Couchbase foi desenvolvida para resolver esse problema, ajudando as empresas a consolidar sua infraestrutura de dados. Em vez de tentar consertar tudo de uma vez, Cronin aconselhou as empresas a começarem pequeno, recomendando que fundadores e empresas que lutam contra a fragmentação de dados escolham primeiro os casos de uso mais críticos.

Ele citou o varejista Tesco do Reino Unido, que possui um grande Centro de Competências Global (GCC) em Bengaluru. Muitos sistemas desse varejista afetavam negativamente a experiência do cliente, especialmente durante períodos de compras intensas, como a Black Friday e fins de semana. A Tesco começou a consolidar seu nível de dados, começando com uma instância e um caso de uso, antes de expandir os esforços por todo o seu stack tecnológico. Essa consolidação permitiu ao varejista processar milhões de transações por segundo com latência inferior a um milissegundo. Na opinião de Cronin, este exemplo demonstra como as empresas podem começar a resolver o problema da fragmentação através de um único caso de uso antes de expandir as mudanças para toda a sua operação.

A pressão relacionada ao desenvolvimento de produtos de IA levou muitas empresas a priorizar modelos e aplicativos. No entanto, os projetos piloto são frequentemente realizados em pequenos conjuntos de dados em ambientes controlados, o que não prepara as organizações para os requisitos de produção reais. Cronin chamou a atenção para a crescente escala do tráfego de máquina. Ele declarou: «Em dezoito meses, o tráfego de máquina ultrapassou o tráfego humano na internet. Este é o escopo da IA. É a escala da velocidade da máquina na qual as empresas devem operar».

Quando os aplicativos de IA encontram cargas de trabalho do mundo real, os sistemas de dados fragmentados podem impedir seu funcionamento confiável em escala. O uso crescente de agentes de IA agrava esse problema. À medida que os agentes se tornam mais autônomos e assumem funções de tomada de decisão, as empresas devem garantir que eles possam acessar os dados necessários dentro das estruturas de governança apropriadas.

Sistemas fragmentados podem dificultar a comunicação e o gerenciamento, limitando a capacidade dos agentes de agir autonomamente. Cronin também pediu que as empresas revissem a abordagem de alocação de investimentos em IA. Embora os modelos evoluam rapidamente, os dados corporativos permanecem um ativo crucial. Ele enfatizou: «Modelos podem ser alugados. O melhor modelo hoje é o jornal de ontem. O verdadeiro ativo para uma empresa são os dados».

À medida que as empresas começaram a perceber que dados fragmentados estavam atrasando suas iniciativas de IA, muitas reagiram adicionando APIs e conectores para ligar sistemas existentes. No entanto, Cronin alertou que esse método pode criar complexidade adicional em vez de resolver o problema principal. Cada conexão adicional aumenta a latência, o risco e cria outro ponto potencial de falha.

Em vez disso, ele recomendou consolidar o nível de dados para que os aplicativos e agentes de IA pudessem interagir com ele de forma mais direta, aproximando os dados dos clientes. Segundo Cronin, muitas empresas, incluindo grandes GCCs na Índia, estão atualmente revisando sua arquitetura para eliminar a fragmentação de dados. Sem essas mudanças, futuros investimentos no desenvolvimento de IA podem levar aos mesmos problemas.

A consolidação de dados também pode melhorar a experiência do cliente, ajudando os sistemas a lidar com a demanda crescente, permanecer disponíveis e responder rapidamente. Como os clientes esperam mais dos serviços baseados em IA, ter dados na periferia torna-se cada vez mais importante.

Cronin observou que as culturas empresariais variam na Ásia-Pacífico, mas a infraestrutura de dados fragmentada permanece um problema comum para a implementação de IA. Ao mesmo tempo, a Índia está se tornando um centro importante de inovação e tomada de decisões em IA. Ele observou que 80% dos principais 50 clientes globais da Couchbase têm presença significativa na Índia, e a maior parte de suas inovações e liderança em IA está baseada neste país. A Couchbase também está expandindo sua presença na Índia, mudando sua sede na Ásia-Pacífico para Bengaluru. Entre os clientes corporativos da Couchbase na Índia estão Air India, Airtel, BigBasket e Mahindra Finance. Na opinião de Cronin, o papel da Índia nos negócios mundiais vai além da economia de custos; inovações, liderança e a tomada de decisões de negócios importantes estão ocorrendo cada vez mais aqui. Ele mencionou a plataforma de entretenimento de nova geração da Air India, que é construída sobre a Couchbase. Esta plataforma visa fornecer aos passageiros uma experiência personalizada de compra e entretenimento, mesmo sem conexão de rede a bordo do avião. Para Cronin, este projeto mostra como as empresas indianas estão usando tecnologia para melhorar a experiência do cliente em condições de operação reais.

Especialista da Forge Code explica por que uma 'fábrica de software' baseada em IA é necessária para um desenvolvimento de software eficaz
Leia mais
yourstory.com

Especialista da Forge Code explica por que uma 'fábrica de software' baseada em IA é necessária para um desenvolvimento de software eficaz

Apesar de a inteligência artificial ser capaz de gerar código com velocidade sem precedentes, o processo de seu teste, verificação e implantação no ambiente de produção representa um desafio complexo separado. As equipes de engenharia estão cada vez mais utilizando agentes de IA para escrever código, corrigir erros e criar novas funcionalidades, mas acelerar a codificação não garante a aceleração da entrega de software.

À medida que a geração de código ganha força, o número de verificações aumenta, os testes desaceleram e as equipes têm dificuldade em coordenar o volume crescente de mudanças.

Na conferência TechSparks 2026, Tushar Mathur, CEO da Forge Code, abordou este problema em sua sessão 'Anatomia da Fábrica de Software'. Ele explicou como as organizações de engenharia orientadas por IA podem ir além da automação de tarefas individuais de codificação e começar a criar sistemas que gerenciam todo o ciclo de vida de desenvolvimento de software (SDLC).

Mathur observou que o fato de a geração de código ter se tornado mais fácil e rápida não significa que o SDLC geral será acelerado. Ele lembrou que a abordagem tradicional de desenvolvimento focava na escrita eficiente de código, exigindo que as equipes definissem requisitos, preparassem especificações e projetassem arquiteturas para reduzir a carga na fase de implementação.

No entanto, como a IA assume grande parte do trabalho de codificação, os gargalos mudam para outras áreas. Mathur descreveu uma situação em que as organizações enfrentam um enorme número de solicitações de mesclagem (pull requests) aguardando revisão, ciclos de teste mais longos e mais erros do que os conjuntos de regressão existentes conseguem detectar.

Ele enfatizou que a solução para o problema não reside necessariamente em contratar mais engenheiros ou lançar mais agentes de IA. Funcionários adicionais podem aumentar os custos de coordenação, e adicionar agentes sem mecanismos eficazes de feedback pode levar à criação de código que sobrecarrega os sistemas de verificação e teste.

'A razão para isso é a ausência de sinal', explicou Mathur, ao explicar por que simplesmente conectar etapas automatizadas não cria uma fábrica de software eficaz.

Mathur apresentou a Forge Code como uma fábrica de software que coordena agentes de IA durante todo o ciclo de desenvolvimento. O processo começa com a triagem de solicitações, criação de especificações e implementação de funcionalidades. Em seguida, os agentes verificam as alterações antes que sejam implantadas, com intervenção de engenheiros humanos quando são necessárias decisões ou feedback.

O sistema também monitora em ambiente de produção, usando os dados coletados para informar tarefas futuras. Isso forma um ciclo de feedback, permitindo que a fábrica identifique problemas, aprimore seus fluxos de trabalho e gere novo trabalho com base na experiência adquirida. Durante a apresentação, Mathur relatou que a Forge Code utilizou cerca de 100 agentes em segundo plano para trabalhar em funcionalidades, compatibilidade e detecção de erros.

Ele delineou seis princípios para criar uma fábrica de software eficaz: operação autônoma, escalabilidade, eficiência econômica, mensurabilidade, autoaperfeiçoamento e alinhamento com objetivos de negócios. O último princípio é particularmente importante.

A fábrica deve operar não como uma tarefa de codificação para cada solicitação, mas sim ser direcionada ao alcance de resultados específicos, como aumento da retenção de clientes ou conformidade regulatória. As equipes podem então priorizar funcionalidades com base no valor que elas agregam. Neste modelo, os engenheiros gastam menos tempo gerenciando cada tarefa e mais tempo observando os resultados, analisando sinais e melhorando o próprio sistema. Os líderes de negócios também podem fornecer solicitações e prioridades diretamente, permitindo que a fábrica transforme objetivos organizacionais em um backlog de desenvolvimento.

A velocidade de codificação é boa, mas criar software melhor é a verdadeira vitória. Para as equipes de engenharia, a chave é transformar a velocidade fornecida pela IA em produtos confiáveis, progresso mensurável e resultados de negócios reais.

Popular