Qingmao Intelligence planeja criar uma rede de tokens Ascend 950DT com 10.000 placas até 2027
Leia mais
Pandaily
pandaily.com

Qingmao Intelligence planeja criar uma rede de tokens Ascend 950DT com 10.000 placas até 2027

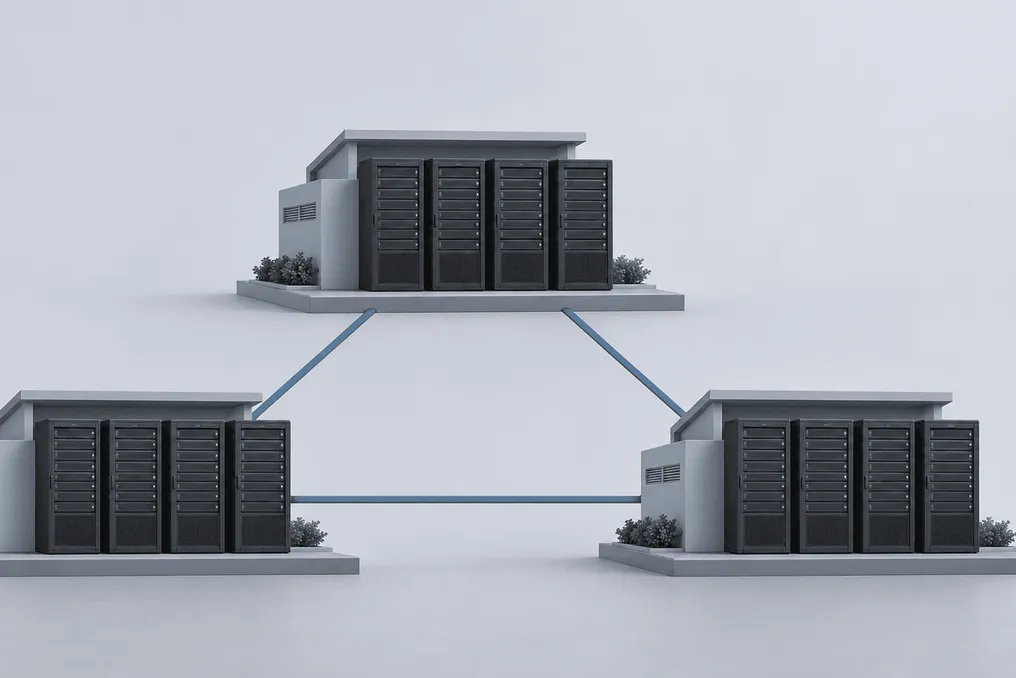
A Qingmao Intelligence apresentou um plano de operações conjuntas para criar uma rede de inferência de inteligência artificial baseada no hardware Huawei Ascend 950DT. De acordo com o plano, a rede deve incluir 10.000 placas aceleradoras até 2027. Um objetivo de longo prazo, descrito no relatório QbitAI de novembro, prevê a expansão dessa rede para 100.000 placas em cinco anos, abrangendo várias regiões e plataformas de chips.

Esta iniciativa foi anunciada em 17 de novembro com a participação de parceiros do ecossistema Ascend e outros participantes do setor. A proposta 'Fábrica de Tokens' representa um modelo operacional para fornecer tokens gerados por modelos, e não um anúncio sobre o funcionamento de uma instalação existente de 10.000 placas.

Distribuição de Responsabilidades

O plano distribui as tarefas entre quatro grupos. Os parceiros do ecossistema Ascend são responsáveis pelo fornecimento de chips, supernós e suporte técnico. Operadores de data centers fornecem recursos computacionais, energia e infraestrutura. Desenvolvedores de modelos e parceiros de tráfego garantem a demanda e ajudam a avaliar a qualidade dos serviços. A Qingmao assume a coordenação da otimização de software, planejamento, contabilidade unificada e operações diárias.

A empresa afirma que os acordos de nível de serviço e as métricas gerais definirão a contribuição de cada parte, as obrigações operacionais e o mecanismo de distribuição de lucros. O objetivo é fornecer um serviço de inferência unificado em recursos pertencentes ou gerenciados por diferentes partes, e não apenas somar o número total de aceleradores instalados.

A Qingmao indica que sua experiência anterior inclui colaboração com mais de 20 centros de computação, planejamento de quase 20.000 placas aceleradoras internas e adaptação de mais de 15 tipos de chips. Além disso, a empresa relata a implantação de cerca de 10 supernós Ascend 910C. Esses números referem-se a trabalhos realizados anteriormente em várias plataformas e não devem ser considerados como capacidade concluída para o programa planejado 950DT.

A empresa vê o software como uma camada de ligação: o motor de inferência melhora a execução em plataformas de hardware individuais, enquanto o software de gerenciamento coordena recursos, monitoramento e contagem de tokens entre os centros. Os critérios de aceitação incluem taxa de transferência eficiente, latência do primeiro token, velocidade de saída, consistência de precisão, disponibilidade e custo por milhão de tokens efetivos.

Este roteiro difere da solução de otimização de inferência baseada em BAAI e Qingmao FlagOS, apresentada no mesmo evento e relacionada às cargas de trabalho específicas Ascend 910C e 910B. A nova abordagem enfatiza como a capacidade e a demanda dos clientes serão organizadas em uma escala maior.

É importante notar que atingir a meta de 2027 e a expansão de cinco anos permanecem planos da empresa. O relatório não confirma que o pool proposto de 950DT com 10.000 placas está operacional, nem realiza uma verificação independente de sua futura utilização, qualidade de serviço ou viabilidade econômica da prestação de serviços.
Histórias semelhantes

China Mobile Hunan e Huawei registram velocidade de 1,86 Gbps em campo de teste 5G-Advanced na frequência de 2,3 GHz
Leia mais
pandaily.com

China Mobile Hunan e Huawei registram velocidade de 1,86 Gbps em campo de teste 5G-Advanced na frequência de 2,3 GHz

A China Mobile Hunan, em colaboração com a Huawei, anunciou o alcance de uma velocidade de pico de downlink de 1,86 Gbps durante um teste de campo da tecnologia 5G-Advanced. O teste foi realizado na cidade de Changsha, utilizando a agregação de três portadoras nas faixas de frequência de 2,3 GHz e 2,6 GHz.

É importante notar que o resultado obtido refere-se a um teste de rede interno específico, e não a uma implementação nacional ou ao anúncio de um novo chip. Nos relatórios chineses, a faixa de frequência de 2,3 GHz é denominada banda E, com largura de banda de 50 MHz, que é combinada com 160 MHz na banda D de 2,6 GHz. Este termo local não deve ser confundido com os canais troncos da banda E de milímetros.

O valor de 1,86 Gbps foi alcançado graças ao funcionamento da rede de três portadoras. Ao usar apenas a portadora na frequência de 2,3 GHz, o projeto demonstrou velocidades de downlink de cerca de 400 Mbps e de uplink de mais de 100 Mbps. Esses indicadores não garantem que um usuário individual atinja a mesma velocidade fora das condições de medição.

O teste foi conduzido na rede de antenas distribuída interna da Universidade Agrícola de Hunan, onde alta carga devido a aulas, transmissão de vídeo e arquivos pode criar problemas de largura de banda. A combinação dos espectros disponíveis visa resolver esse gargalo enquanto utiliza a infraestrutura de cobertura interna existente.

Em três dias de projeto, houve um aumento de 4% no tráfego de downlink e de 10% no tráfego de uplink. As mudanças no volume de tráfego não são equivalentes a uma comparação controlada da velocidade de download individual, e os relatórios apresentados não contêm metodologia de teste independente que confirme um aumento mais amplo de desempenho.

A China Mobile Hunan declarou que sua rede atual inclui aproximadamente 13.500 módulos de banda E, que podem obter essas capacidades através de uma atualização de software. Isso indica potencial de modernização, e não a confirmação de que todos os módulos foram convertidos ou que equipamentos semelhantes em outros locais suportam o mesmo caminho.

Outra limitação é a disponibilidade dos terminais: estima-se que cerca de 10% dos dispositivos na rede existente suportem essa funcionalidade. O acesso real também depende das faixas suportadas, da agregação de portadoras, da cobertura local, da condição do sinal e do número de usuários simultâneos. A presença do ícone 5G-A por si só não garante um desempenho de pico sustentado.

O próximo passo planejado é expandir os testes internos nas províncias e avaliar uma ativação mais ampla. Assim, as medições publicadas confirmam uma demonstração de engenharia local, pois a cobertura prática continua sendo determinada pelas condições da rede e dos dispositivos.

Moore Threads agendou MDC 2026 para 29 e 30 de dezembro em Pequim, apresentando as esperadas placas S6000 e GPUs Lushan
Leia mais
pandaily.com

Moore Threads agendou MDC 2026 para 29 e 30 de dezembro em Pequim, apresentando as esperadas placas S6000 e GPUs Lushan

A Moore Threads anunciou a realização da sua Conferência de Desenvolvedores MUSA 2026 (MDC 2026) em Pequim, que ocorrerá nos dias 29 e 30 de dezembro. A empresa comunicou isso em 11 de novembro, anunciando que mais de dez novos produtos, tecnologias e soluções seriam apresentados no evento.

O fundador, presidente e CEO Zhang Jianzhong fará uma palestra principal sobre os planos da empresa para computação de função completa baseada nos chamados GPUs de função completa, bem como sobre o roteiro da arquitetura.

Novidades Esperadas

Embora a Moore Threads ainda não tenha confirmado a lista de lançamentos, relatórios citados pela Sina Tech e Jiemian indicam que, até o final do ano, haverá no mercado a placa de computação de IA S6000 e a série de GPUs gráficas 'Lushan', construídas na arquitetura de próxima geração 'Huagang'. A placa S6000 é a sucessora da série S5000.

Mídias chinesas descrevem a S6000 como um elemento chave nos planos da empresa para criar clusters de 100.000 placas aceleradoras, mas as especificações da S6000 ainda não foram publicadas pela empresa. Além disso, a empresa demonstrou os supernós C128 e C256, e mais detalhes são esperados na conferência.

Características das GPUs Lushan

Quanto ao Lushan, os relatórios repetem dados que a Moore Threads apresentou pela primeira vez ao introduzir a arquitetura Huagang em dezembro passado: 16 vezes maior desempenho de processamento geométrico, 64 vezes maior desempenho de computação de IA e 50 vezes maior desempenho de rastreamento de raios, além de melhor preenchimento de texturas, acesso à memória atômica e maior capacidade de memória. O nível base desses multiplicadores não foi reafirmado nos relatórios recentes.

O Lushan combina renderização generativa de IA, uma arquitetura de renderização chamada UNITE e um novo motor de rastreamento de raios de hardware, e é destinado a jogos AAA de alto desempenho e trabalho gráfico profissional.

Escopo do Evento

De acordo com o Shanghai Securities News e o site da indústria ijiwei, o evento deste ano foi maior. Ele incluirá 26 fóruns temáticos em 11 áreas, incluindo 'fábricas' para treinamento de modelos, produção de tokens e agentes, inteligência de borda, supernós e infraestrutura de IA. A área de exposição aumentou de 1.000 para 3.000 metros quadrados, e espera-se a participação de mais de 4.000 desenvolvedores, em comparação com mais de 2.000 no evento anterior. O site da conferência está disponível em mdc.mthreads.com.

Informações sobre preços, prazos de entrega e testes independentes para ambas as linhas de produtos permanecem não divulgadas. As romanizações de 'Lushan' e 'Huagang' são nomes chineses; o estilo oficial em inglês da Moore Threads para eles, bem como o nome completo do produto S6000, não puderam ser confirmados.

Lenovo lança fábrica híbrida de tokens Wanquan e escolhe Zhangjiakou para o primeiro local principal
Leia mais
pandaily.com

Lenovo lança fábrica híbrida de tokens Wanquan e escolhe Zhangjiakou para o primeiro local principal

A Lenovo apresentou sua marca proprietária Wanquan Hybrid Token Factory durante um evento realizado em 10 de novembro na cidade de Zhangjiakou, província de Hebei. No âmbito deste evento, foi assinado um acordo de cooperação com as autoridades locais, que prevê a criação da primeira 'fábrica matriz' — um termo que a Lenovo usa para designar seu principal local da rede.

A Lenovo define o poder computacional de inteligência artificial como uma fábrica cujo produto são os tokens — unidades de texto que o modelo lê e gera. Para Zhangjiakou, a empresa planeja construir um cluster de computação heterogênea com capacidade de 15.000P e um centro de computação inteligente com capacidade total de cerca de 100 MW até 2027. Embora os relatórios não especifiquem a precisão numérica da classificação 'P', a Lenovo visa atingir uma produção anual superior a 2.000 quatriliões de tokens, uma velocidade de pico de 200 milhões de tokens por segundo e suportar mais de 100.000 usuários simultâneos.

Até 2030, a empresa pretende aumentar os indicadores de clusters supernós, centros de dados e produção anual de tokens em mais de dez vezes. A Lenovo também apresentou dados de eficiência: aumento de cinco vezes na velocidade de geração de tokens, 'taxa de rendimento' acima de 99,9%, redução de 70% nos custos totais por milhão de tokens e eficiência energética abaixo de 1,1. Deve-se notar que esses números são apresentados como declarações da empresa, pois os relatórios não contêm uma linha de base ou definição de taxa de token.

A escolha de Zhangjiakou deve-se à sua localização no plano nacional 'Leste de Dados, Oeste de Computação' para a região Pequim-Tianjin-Hebei, bem como à disponibilidade de energia eólica e solar. Liu Jun, vice-presidente da Lenovo e presidente da China, descreveu o modelo de 'potência híbrida' de três camadas. O nível básico representa a infraestrutura de IA da Lenovo para computação. A camada intermediária é a fábrica de tokens, que combina a construção e operação do centro de computação inteligente com o serviço xCloud da Lenovo. O nível superior inclui soluções e serviços de agentes que entregam tokens aos fluxos de trabalho dos clientes. A Lenovo também oferece pacotes de serviços como agente-como-serviço e token-como-serviço.

Zhangjiakou é o primeiro de uma série de locais planejados. A Lenovo pretende criar fábricas para a transformação da indústria pesada no nordeste, manufatura inteligente no norte da China, educação no noroeste, geração de séries dramáticas curtas no centro da China e manufatura avançada no leste. O próximo destino será Changsha, onde haverá colaboração com a Mango TV em uma fábrica de tokens para novas mídias e um centro de filmes de IA, visando reduzir os custos de produção em mais de 50%, encurtar os ciclos em mais de 60%, alcançar um volume mensal de material pronto de 1.200 horas e atrair mais de 10.000 criadores de conteúdo.

Informações sobre clientes, fornecedores de chips, acordos energéticos e fases de construção até 2027 não foram divulgadas.

Popular