DeepSeek disponibiliza acesso a ferramentas de busca, manipulação de arquivos, OCR e entrada de voz via API para desenvolvedores
Leia mais
Pandaily
pandaily.com

DeepSeek disponibiliza acesso a ferramentas de busca, manipulação de arquivos, OCR e entrada de voz via API para desenvolvedores

A DeepSeek anunciou a disponibilização de um conjunto completo de APIs para seu aplicativo, permitindo que os desenvolvedores integrem as principais funcionalidades do DeepSeek App em seus próprios produtos. A atualização foi apresentada no log de alterações da API da empresa em 13 de novembro.

Os desenvolvedores podem ativar a funcionalidade usando parâmetros nas APIs existentes, enquanto os servidores da DeepSeek cuidam do processamento das chamadas de ferramentas e da coleta de contexto.

Capacidades dos modelos e API

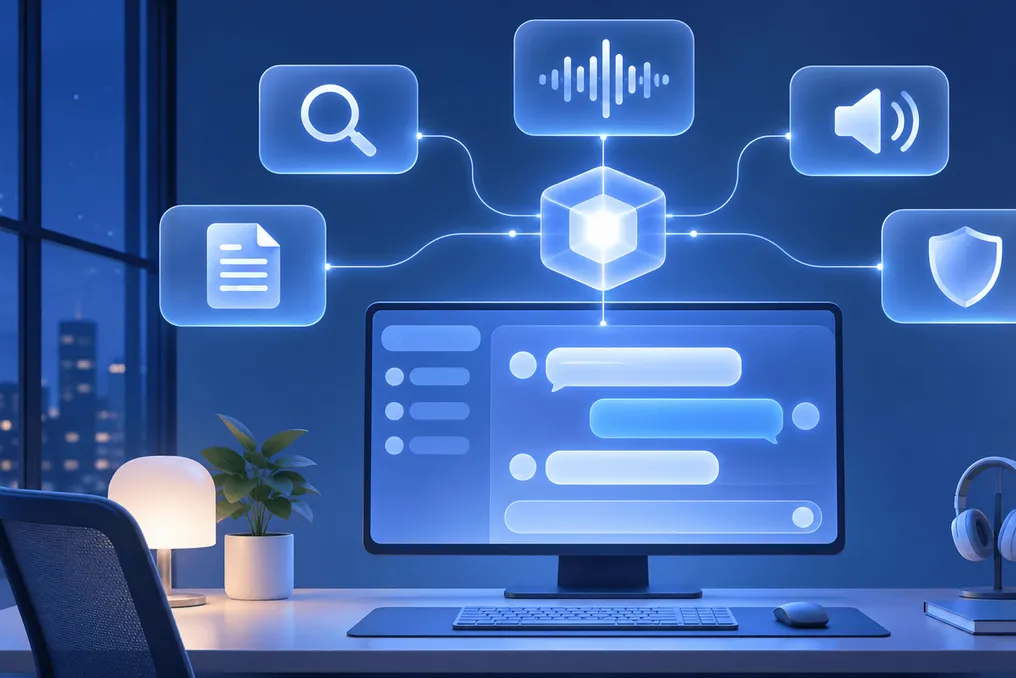
De acordo com o log de alterações, o modelo deepseek-flash, atualmente usado no DeepSeek-V4.1-Flash-1017, suporta cinco funções nas APIs Messages, Responses e Chat Completions. Além disso, funcionalidades básicas estão disponíveis como APIs separadas: Search and Fetch, OCR, ASR para reconhecimento de fala e TTS para síntese de fala.

Para demonstrar essas capacidades, a DeepSeek abriu o código-fonte de um chat demo, um cliente web estático que se conecta diretamente à API a partir do navegador. Este cliente suporta raciocínio profundo, busca, leitura de links, upload de anexos e entrada de voz, além de poder importar o histórico de bate-papo do usuário DeepSeek.

Tarifas e precificação

O uso das ferramentas é cobrado acima do custo dos tokens. Na página de preços da DeepSeek, as seguintes tarifas são indicadas: busca (para texto ou imagens) e obtenção de dados da web custam US$ 0,75 a cada 1000 requisições, ou 5 yuans no site chinês. O processamento de arquivos e OCR custa US$ 0,225 a cada 1000 páginas. A síntese de fala (Text-to-speech) é tarifada em US$ 0,45 por 10.000 caracteres, e o reconhecimento de fala em US$ 0,116 por hora de áudio; ambos os serviços estão atualmente oferecidos com 50% de desconto.

As taxas de busca e obtenção de dados são aplicadas independentemente de os desenvolvedores chamarem essas APIs diretamente ou se o modelo as utiliza através de suas ferramentas. Estas novas APIs expandem as APIs Search and Fetch abertas em 17 de outubro, que operam no motor de busca interno da DeepSeek. Os preços dos tokens para deepseek-flash permanecem inalterados: US$ 0,30 por milhão de tokens de entrada em caso de falha de cache e US$ 1,20 por milhão de tokens de saída em horários de pico, sendo que fora dos horários de pico as tarifas são reduzidas pela metade.
Histórias semelhantes

Plataforma DeepSeek Harness atinge 1,54 milhão de usuários diários com crescimento de 545%
Leia mais
olhardigital.com.br

Plataforma DeepSeek Harness atinge 1,54 milhão de usuários diários com crescimento de 545%

A plataforma DeepSeek Harness, focada na criação e operação de agentes de inteligência artificial, atingiu a marca de 1,54 milhão de usuários diários. Além disso, ela processa impressionantes 92,1 trilhões de tokens a cada 24 horas, conforme dados oficiais divulgados pela startup chinesa através da rede X.

Este notável avanço foi significativamente impulsionado pelo recente lançamento da versão da plataforma destinada a computadores. Atualmente, o DeepSeek Harness conta com 5,48 milhões de usuários ativos mensalmente e registra uma média de 261 solicitações diárias por indivíduo.

Em um curto espaço de tempo, o número de usuários ativos diários experimentou um aumento de 545%. Paralelamente, o consumo de tokens disparou para 92,1 trilhões por dia, representando um crescimento de 306%. Tokens são definidos como as unidades fundamentais empregadas pelos modelos de IA para processar e gerar informações. Entre os modelos que contribuíram para essa expansão, destaca-se o V4.5-Flash.

A comunidade de desenvolvedores também desempenha um papel crucial neste crescimento. O Harness já disponibiliza quase 35 mil plugins de terceiros, sendo que cerca de 30 mil desses estão alojados no GitHub. Aproximadamente 59% dos usuários ativos utilizam ou desenvolvem pelo menos uma extensão para automatizar tarefas de trabalho.

Conhecida pela sigla DSH, a DeepSeek Harness funciona como uma estrutura de código aberto projetada para gerenciar agentes autônomos. Tais sistemas possuem a capacidade de executar funções no computador sem necessitar de intervenção humana em cada fase do processo.

Com o lema «tudo é um plugin», a plataforma possibilita que desenvolvedores externos integrem ferramentas e funcionalidades ao seu ambiente. A ambição é transformar o Harness em algo semelhante a um sistema operacional dedicado a agentes de inteligência artificial, onde diversas extensões potencializam as habilidades do assistente.

É importante notar que os indicadores apresentados referem-se exclusivamente ao ecossistema do Harness e não incluem os usuários do chat tradicional da DeepSeek. Ademais, esses dados não devem ser comparados diretamente com métricas de outros assistentes, visto que eles utilizam períodos de medição distintos. Por exemplo, o ChatGPT reporta mais de 1,2 bilhão de usuários semanais, e o Claude também se mantém entre os principais serviços do setor.

Para fomentar ainda mais o ecossistema, a startup anunciou a criação de um marketplace exclusivo para a descoberta e instalação de plugins. Esta iniciativa também prevê oferecer incentivos tanto para desenvolvedores independentes quanto para empresas interessadas em criar ferramentas para a plataforma.

O programa de incentivo contemplará a concessão de créditos de computação gratuitos, denominados token grants, juntamente com suporte técnico. Com estas ações, a DeepSeek busca estimular a produção de novas extensões e aumentar a participação de terceiros no desenvolvimento do Harness.

Equipe DeepSeek lança protótipo de agente de pesquisa para codificação proativa
Leia mais
technode.com

Equipe DeepSeek lança protótipo de agente de pesquisa para codificação proativa

A equipe DeepSeek Harness tornou público o dsh-superagent, um protótipo de pesquisa que aceita solicitações de desenvolvimento via GitHub e, opcionalmente, via Feishu. O agente executa o trabalho em sessões separadas e retorna os resultados, por exemplo, na forma de solicitações de mesclagem (pull requests) no diálogo original.

Este protótipo é configurado em torno de um repositório GitHub e funciona como um pacote para o DeepSeek Harness. Ele transforma solicitações autorizadas em tarefas de trabalho, aloca um diretório de trabalho e uma sessão de agente dedicados para cada tarefa, e fornece um painel web para exibir questões que requerem atenção humana.

O projeto explora as capacidades de agentes de codificação para executar tarefas de longa duração com menor necessidade de coordenação humana. A implementação, que foi publicada, surgiu do fluxo de trabalho diário da equipe e está disponível sob a licença MIT.

Equipe DeepSeek Harness lança protótipo de superagente capaz de encontrar e corrigir erros autonomamente
Leia mais
pandaily.com

Equipe DeepSeek Harness lança protótipo de superagente capaz de encontrar e corrigir erros autonomamente

A equipe DeepSeek Harness publicou a descrição de seu projeto, que nomearam Superagente. Este agente foi projetado como um sistema em funcionamento contínuo que avança múltiplas tarefas simultaneamente, busca trabalho autonomamente e se recupera de falhas. Um protótipo de pesquisa correspondente foi lançado no GitHub sob licença MIT, informaram mídias tecnológicas chinesas.

O repositório dsh-superagent-prototype representa um pacote de agente de codificação proativo, destinado a operar com um repositório do GitHub dentro do ecossistema DeepSeek Harness. O agente monitora a atividade no GitHub, bem como opcionalmente no Feishu. Quando um usuário autenticado solicita a execução de uma tarefa, o agente cria um item de trabalho, processa-o em sua sessão e diretório, e então responde no diálogo original, por exemplo, criando um pedido de pull request.

Na documentação anexa, é enfatizado que este código é de natureza de pesquisa e não um produto oficial da DeepSeek, e algumas das concepções descritas no documento ainda não foram implementadas.

Arquitetura do Sistema

O conceito principal é construído sobre uma arquitetura de duas camadas. A Sessão do Roteador (Router) recebe toda a atividade humana de vários canais, mas não executa o trabalho e pode nem ter a ferramenta Bash. As tarefas são delegadas a sessões isoladas de agentes de trabalho (Worker), que executam o trabalho em paralelo usando um conjunto completo de ferramentas, e enviam relatórios de volta ao Roteador, sem comunicação com os usuários.

Cada Agente de Trabalho se inscreve nos branches de seu interesse, como discussões no chat ou pedidos de pull request, permitindo que eventos subsequentes cheguem diretamente a ele, sem passar pelo Roteador. O sistema funciona com base em eventos: os gatilhos são mensagens de chat, e-mails, comentários em revisões e resultados de integração contínua (CI), que são primeiro filtrados por código determinístico e depois pelo modelo.

A equipe também separou o estado do agente e do ambiente de execução para que o agente possa permanecer ativo na nuvem, interagindo com máquinas locais do usuário. Uma sessão externa de Vigilante (Watchdog) é usada adicionalmente para monitorar se os Agentes de Trabalho estão obtendo progresso real. Em um grupo interno de usuários, a equipe estabeleceu uma regra: a instância deve reproduzir silenciosamente os erros relatados e só comunicá-los após encontrar uma solução simples, às vezes abrindo um pull request antes que alguém marque o problema.

Durante testes preliminares com cargas sintéticas, incluindo cerca de 300 mensagens e aproximadamente 20 solicitações de trabalho, o Superagente concluiu metade das tarefas em 12,4 minutos e 95% em 15,7 minutos. Esses resultados superaram os alcançados por uma única sessão com ferramenta de subagente, embora tenham exigido mais tokens em cache. Sem o direcionamento direto dos eventos subsequentes aos Agentes de Trabalho, as soluções do Roteador aumentaram em cerca de 30%, e o processamento em lote sob alta carga reduziu o tempo de saída de uma solução do Roteador de 6,4 segundos para 1,6 segundo. A equipe classificou esses resultados como um ponto de referência preliminar.

Entre as questões não resolvidas listadas pela equipe estão: escalabilidade do Roteador, memória de longo prazo, interação entre agentes e o risco de injeção de prompts (prompt-injection) caso o agente em nuvem tenha acesso às credenciais em dispositivos locais.

Popular