Modelo de IA de voz Tencent Hunyuan Hy Realtime consegue determinar autonomamente a necessidade de busca e executar músicas sob demanda
Leia mais
Pandaily
pandaily.com

Modelo de IA de voz Tencent Hunyuan Hy Realtime consegue determinar autonomamente a necessidade de busca e executar músicas sob demanda

A Tencent Hunyuan apresentou o modelo Hy Realtime, que é um modelo de voz em tempo real e integra funcionalidades de chamada de ferramentas e canto em conversas cotidianas. Este modelo já está disponível em chamadas de voz na plataforma Tencent Yuanbao e no suporte ao cliente da Tencent. A empresa informou que Hy Realtime será oferecido via API no Tencent Cloud em breve. O anúncio do modelo ocorreu em 13 de novembro.

De acordo com declarações da Tencent, Hy Realtime foi desenvolvido levando em consideração as características da fala humana. O modelo é capaz de lidar com características como murmúrios, interrupção de frases ou autocorreção durante o pensamento. O contexto da conversa circundante é usado para reconstruir o significado verdadeiro. Além disso, as capacidades de seguir instruções de múltiplos passos e gerenciar o contexto foram aprimoradas, permitindo que o modelo rastreie a intenção do usuário durante diálogos prolongados.

O modelo também possui uma função de chamada de ferramentas externas. Com base no conteúdo da conversa e nas intenções do usuário, ele decide se é necessário realizar uma pesquisa na web, gerencia essa pesquisa, executa a chamada da ferramenta e fornece uma resposta de voz dentro de um processo unificado. Em termos de qualidade de saída, a Tencent afirma que o modelo supera seu antecessor em qualidade de áudio, pronúncia, prosódia e expressão emocional, proporcionando mudanças de tonalidade mais naturais durante o diálogo.

A funcionalidade de canto foi desenvolvida em colaboração com a equipe de inteligência artificial da Tencent Music Entertainment. Os usuários podem solicitar composições especificando parâmetros como artista, álbum, gênero, idioma, ano de lançamento ou popularidade, além de combinar essas condições e refinar o pedido em réplicas subsequentes. Em um exemplo da Tencent, um usuário pediu uma canção folclórica inglesa lançada entre 2010 e 2020, e o modelo encontrou uma opção adequada e a cantou. A Tencent observa que ajustou o vocal para conferir expressividade, fraseado natural, respiração, bem como melodia e ritmo.

A Tencent relata resultados positivos em testes cegos internos de especialistas em tarefas de busca e resposta, bem como em um conjunto de testes interno para o modo sem pensamento e em vários benchmarks de voz públicos. A empresa caracteriza seus resultados gerais nesses testes públicos como líderes. Deve-se notar que estas são avaliações da própria empresa, e os tamanhos das amostras ou configurações dos testes não são fornecidos no texto publicado.

Os usuários podem testar o modelo no aplicativo Yuanbao mais recente, selecionando a voz chamada Chuyu em chamadas de voz, ou através da demonstração web no Tencent Cloud. A Tencent planeja continuar o desenvolvimento em direção à interação bidirecional, memória personalizada de longo prazo e coordenação entre o agente de conversação principal e agentes de fundo.

Histórias semelhantes

Sistema MOSS-Live demonstra altos índices em métricas de voz, mas fica atrás do GPT-Live-1 em tarefas com múltiplas falas
Leia mais
pandaily.com

Sistema MOSS-Live demonstra altos índices em métricas de voz, mas fica atrás do GPT-Live-1 em tarefas com múltiplas falas

A equipe OpenMOSS da Universidade Fudan e da MOSI Intelligence apresentou uma avaliação detalhada de seu sistema de interação de voz full-duplex MOSS-Live. Este sistema foi comparado com modelos da OpenAI, como GPT-Live-1 e GPT Realtime 2.1, bem como com o Doubao SeedDuplex da ByteDance e dois modelos Qwen Audio 3.0. A publicação no blog da OpenMOSS, datada de 13 de novembro, descreve as áreas de superioridade e deficiência do MOSS-Live. Vale notar que todos os números apresentados são dados dos fornecedores, e informações sobre tamanhos das amostras, avaliações de incerteza e condições completas de teste não foram divulgadas.

O MOSS-Live obteve o primeiro lugar em todas as seis métricas declaradas de interação full-duplex. O sistema reagiu à fala não direcionada a ele apenas em 2% dos casos, o que é significativamente melhor do que os 68% do GPT-Live-1 e 75% do Doubao SeedDuplex. Além disso, ele interveio durante pausas do usuário em apenas 1,44% dos casos, em comparação com 10,37% e 14,29% dos concorrentes. O sistema ignorou corretamente interrupções externas em 68% dos casos, enquanto os indicadores de outros modelos foram de 21% e 13%, e manteve sua linha de comportamento durante breves confirmações como 'hm-hmm' em 98,17% dos casos.

Os resultados em outros parâmetros foram inconclusivos. Ao usar a ferramenta FDB v3, o MOSS-Live demonstrou 51% de sucesso, colocando-o ao lado do Doubao SeedDuplex como líder e superando o GPT-Live-1 com seus 45%. No entanto, o tempo de resposta do sistema em cenários de uso de ferramentas, que foi de 2,36 segundos, mostrou-se mais lento do que os 1,61 segundos do GPT Realtime 2.1. No benchmark de tarefas de múltiplos passos τ-Voice, o MOSS-Live alcançou 57,93%, ficando atrás do GPT-Live-1 com seus 67,68%, mas superando significativamente o Doubao com 17,38%. A porcentagem de casos em que o sistema cedeu a palavra por dois segundos foi de 52,49%, muito abaixo dos mais de 93% dos modelos Qwen Audio. Em compreensão de áudio no Big-Bench Audio, o MOSS-Live mostrou 88,40%, o que foi inferior aos 90,50% do Doubao. Ao seguir instruções de múltiplos passos, o sistema recebeu 3,35 de 5 pontos, enquanto o GPT-Live-1 obteve 3,72, mas o MOSS-Live liderou em qualidade de respostas após interrupções, atingindo 4,88.

A arquitetura do MOSS-Live combina um modelo de fundo, que cuida da escuta, gerenciamento de fila e fala, com um modelo de fundo responsável pelo raciocínio, chamadas de ferramentas e tarefas mais longas. Esses dois modelos trocam memória, contexto e estado da tarefa através de um nível de coordenação, permitindo a continuação do diálogo enquanto uma busca por hotéis ou outra operação está sendo executada. O sistema também suporta vídeo em streaming, compartilhamento de tela e interpretação em tempo real.

O sistema está disponível através de um sandbox online e via API WebSocket realtime sob o identificador do modelo moss-live-1.0. A MOSI Intelligence, localizada no incubador do Instituto de Inovação de Xangai, juntamente com a equipe OpenMOSS, lançou anteriormente os modelos MOSS-Image e MOVA.

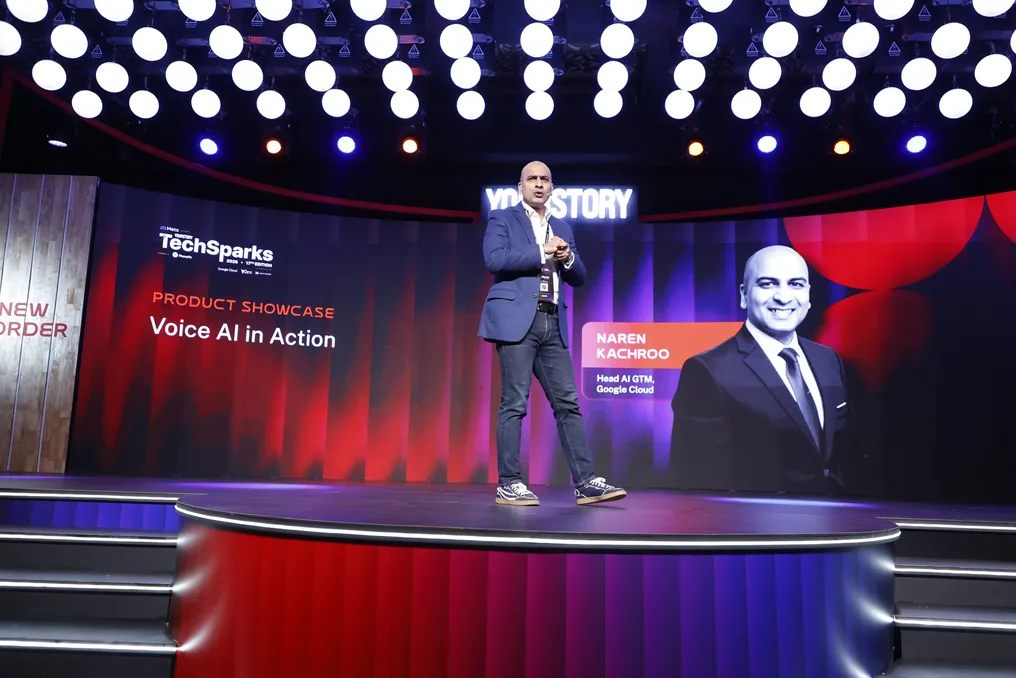
Naren Kachroo do Google Cloud apresenta o desenvolvimento da IA de voz na conferência TechSparks 2026
Leia mais
yourstory.com

Naren Kachroo do Google Cloud apresenta o desenvolvimento da IA de voz na conferência TechSparks 2026

Naren Kachroo, líder de vendas e GTM AI no Google Cloud, afirmou que a inteligência artificial mais valiosa é aquela capaz de completar totalmente a tarefa proposta. Ele enfatizou que o valor só é criado quando a tarefa é realmente concluída com a ajuda da IA.

No evento TechSparks 2026, durante uma demonstração do produto intitulado 'IA de Voz em Ação', Kachroo apresentou os modelos de voz mais recentes do Google, exemplos de uso por clientes e uma demonstração ao vivo desenvolvida para pequenas empresas. Sua ideia principal foi que a voz está se tornando a principal forma de interação das pessoas com a IA, e essa transição ocorrerá na Índia em idiomas e sotaques locais.

Kachroo observou que a indústria se afastou do conceito de IA generativa apenas como uma ferramenta de perguntas e respostas. Ele explicou que o foco mudou para a IA que tem acesso a dados, ferramentas e capacidades que permitem agir em nome de uma pessoa.

A Google lançou recentemente o Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking. O modelo Gemini 3.8 Live é capaz de reconhecer e alternar entre 97 idiomas suportados dentro de uma única conversa. Kachroo explicou como as empresas podem escolher entre esses dois modelos.

O modelo Gemini 3.8 Live é adequado para tarefas mais simples relacionadas a diálogos e funções de agente, como bate-papo de voz com chamada básica de ferramentas. Enquanto o Extended Thinking é projetado para diálogos que exigem raciocínio mais profundo, mudança de contexto e execução de várias etapas. Ele também mencionou que o Extended Thinking custa mais por token.

Ambos os modelos são do tipo 'voz para voz', processando fala tanto como entrada quanto como saída dentro de um único sistema. Para desenvolvedores que precisam apenas de uma parte desse processo, o Google também oferece modelos separados para conversão de texto em fala, fala em texto e tradução ao vivo.

Kachroo relatou que o modelo Gemini mais recente para conversão de texto em fala demonstrou altos resultados em testes internos do Google usando idiomas, sotaques e tons indianos. Ele realizou uma série de demonstrações curtas para mostrar o espectro de cenários de uso possíveis.

No primeiro exemplo, o assistente Shopify, Sidekick, ajudou passo a passo um vendedor a conectar um domínio através do painel de administração do Shopify. No segundo exemplo, um agente de voz reservou uma mesa em um restaurante para oito pessoas. Durante a chamada, o solicitante perguntou se havia bolo disponível, compartilhou uma foto de uma avaliação do Google para saber se o prato era vegetariano e solicitou informações sobre outras opções vegetarianas antes de confirmar a reserva. Este segundo cenário exigiu que o agente rastreasse o contexto ao longo de várias rodadas de diálogo, lembrasse preferências e executasse várias chamadas de ferramentas, o que, segundo Kachroo, corresponde perfeitamente ao Extended Thinking.

Ele também demonstrou o Live Avatar, que combina a voz ao vivo do Gemini com geração de vídeo em tempo real e sincronização labial, permitindo que os usuários vejam um rosto animado, e não apenas ouçam a voz. A Google forneceu recentemente o Live Avatar para empresas através do Gemini Enterprise, marcando o conteúdo de áudio e vídeo gerado com uma marca d'água invisível SynthID. O Citi atuou como cliente piloto: seu assistente Citi Sky, criado usando a tecnologia de avatar em tempo real do Google DeepMind e a API Gemini Live, ajuda clientes do setor de patrimônio dos EUA a tomar decisões, como sobre o resgate de um certificado de depósito.

Kachroo observou que o Gemini 3.8 Live possui o custo mais baixo por turno entre os modelos comparáveis, e o Extended Thinking estabelece padrões da indústria de qualidade de conversão de fala para fala. A Google declarou que o Extended Thinking obteve 82,6 pontos no índice de qualidade de conversão de fala para fala da Artificial Analysis, o mais alto registrado.

Ele esclareceu que o baixo custo é devido ao fato de o Google gerenciar toda a pilha sozinho — desde chips TPU e infraestrutura até os próprios modelos e aplicativos, transferindo essa eficiência aos clientes. Isso permite que o Google ofereça tanto um modelo de alta qualidade quanto um cavalo de batalha mais econômico.

Como exemplos de uso de IA de voz, Kachroo citou dois clientes: Autotrader, que usa essa tecnologia para comprar e vender carros usados, e Equal AI, uma startup indiana cujo assistente atende e processa chamadas antes que o usuário atenda.

O elemento central da sessão foi uma demonstração ao vivo de um assistente para micro, pequenas e médias empresas (PMEs), que a equipe de Kachroo desenvolveu em cerca de um dia. Este é um grande mercado potencial: de acordo com o ministério de PMEs, mais de 7,8 bilhões de empresas estão registradas no portal Udyam do governo até fevereiro de 2026. Kachroo alertou antecipadamente sobre um risco: ele iniciou o demo através de um hotspot móvel depois de não conseguir se conectar à rede do hotel.

A demonstração incluiu uma empresa fictícia de equipamentos de proteção e seu proprietário, Rajesh, que acabara de receber cerca de 500 capacetes. Ao interagir com o assistente, Rajesh perguntou quantos clientes potenciais ele tinha para os capacetes. O assistente encontrou dois: uma construtora em Mumbai, que precisava de 500 capacetes, e uma loja de ferragens em Agra, que precisava de 50. Rajesh instruiu o assistente a descartar o pedido menor, enviar uma proposta comercial ao comprador de Mumbai e ligar para ele para fechar o negócio. Ele estabeleceu uma condição: o preço deveria permanecer acima de 400 rúpias por capacete, e o assistente poderia finalizar o pedido sem nova aprovação. Em seguida, o assistente ligou para o comprador e negociou em hindi. Kachroo observou que o assistente manteve o contexto da conversa interna com Rajesh durante a ligação externa, negociou em nome da empresa e fechou o negócio.

Este processo ponta a ponta, na opinião de Kachroo, é a direção do desenvolvimento da IA de voz. Ele acredita que, com os modelos 3.8 Live, as empresas agora podem integrar agentes de voz em seus processos, que executam tarefas autonomamente. Kachroo acrescentou que este assistente poderia conduzir uma conversa semelhante em tâmil, telugu, malayalam, kannada, marathi e outros idiomas. Ele enfatizou que isso é importante porque o consumidor indiano está cada vez mais orientado para a interação por voz. O próprio Gemini Live agora suporta mais de 25 idiomas e dialetos indianos. De acordo com o relatório IAMAI-Kantar Internet in India 2024, 98% dos 886 milhões de usuários ativos de internet na Índia recebiam conteúdo em idiomas indianos, e um em cada cinco usava comandos de voz para acessar a rede.
Agente de pesquisa Hyra 2.0 da Tencent Hunyuan cria autonomamente ferramentas para trabalho com proteínas, provas matemáticas e chips
Leia mais
pandaily.com

Agente de pesquisa Hyra 2.0 da Tencent Hunyuan cria autonomamente ferramentas para trabalho com proteínas, provas matemáticas e chips

A Tencent Hunyuan lançou o Hyra 2.0, a segunda versão do seu agente de pesquisa autônomo, que foi apresentado em 2 de novembro. Diferentemente do Hyra 1.0, que se concentrava na resolução de tarefas individuais, como resolver o problema da potência soma versus diferença usando o modelo Hy3, a nova versão foi desenvolvida para criar ferramentas de pesquisa reutilizáveis. Os resultados do trabalho e o código correspondente estão disponíveis no repositório do GitHub sob a licença Apache 2.0.

O Hyra 2.0 funciona como um sistema de três níveis, composto por agentes gerais, de missão e operacionais. Esses agentes são coordenados através de um quadro de pesquisa comum e uma fila de tarefas persistente. Um agente operacional especializado realiza a verificação dos resultados, os agentes mantêm memória multinível, e a base de conhecimento geral resume as lições aprendidas em habilidades aplicáveis.

Ferramentas criadas pelo sistema

A Tencent apresentou uma série de ferramentas desenvolvidas por este sistema. Entre elas, há o HyInv — um modelo de reversão de dobramento de proteína com 1,96 milhão de parâmetros. Este modelo opera 57 vezes mais rápido que o ProteinMPNN, demonstrando melhor correspondência estrutural e sendo capaz de projetar 128 sequências em apenas 50 milissegundos.

Também foi apresentada a linguagem de modelos para proteínas HyPLM-Flash, com 650 milhões de parâmetros e treinada em 726 bilhões de tokens. Ela se mostrou a mais rápida entre 12 modelos comparados e alcançou o terceiro lugar em média em 35 tarefas, processando cerca de 130.000 resíduos por segundo em um único processador H20.

A família de campos de força HyFF, que inclui cinco variantes com parâmetros de 2,3 milhões a 1,2 bilhão em 83 elementos, está na frente de Pareto de precisão e velocidade em comparação com outros 16 modelos. A Tencent afirma que seu modelo Largo apresenta o menor erro de energia — 0,364 meV por átomo, e este complexo conseguiu simular um sistema de aquaporina de 60.000 átomos durante 100 nanossegundos.

Conquistas em matemática e computação quântica

Na área de matemática, o componente HyProver alcançou dois resultados. Ele resolveu a hipótese de Petty sobre conjuntos equiláteros em espaço de cinco dimensões, elevando a dimensão máxima resolvida de quatro. Quanto à hipótese de Yau sobre a ação do círculo, a descrição no GitHub apresenta um contraexemplo para a forma ilimitada — uma variedade fechada de sete dimensões que não é simplesmente conexa; enquanto a versão simplesmente conexa permanece um problema aberto.

No campo da correção de erros quânticos, o HyQEC descobriu o código [[488,123,22]], que, segundo a Tencent, supera o líder anterior na métrica qLDPC em aproximadamente 48%.

Robótica e chips

Além disso, o Hyra projetou um mecanismo de braço robótico simulado que foi 28,6% mais rápido que o design de referência. No processador aberto XiangShan RISC-V, o agente aumentou o índice SPECint2006 em 5,79% por gigahertz, aumentando a área em apenas 0,3% e detectando dez erros. A Tencent relata que o Hyra agora está sendo usado para treinar os próximos modelos da série Hy.

É importante notar que todos os resultados apresentados pertencem à Tencent e ainda não passaram por avaliação independente.

Popular