Moore Threads agendou MDC 2026 para 29 e 30 de dezembro em Pequim, apresentando as esperadas placas S6000 e GPUs Lushan
Leia mais
Pandaily
pandaily.com

Moore Threads agendou MDC 2026 para 29 e 30 de dezembro em Pequim, apresentando as esperadas placas S6000 e GPUs Lushan

A Moore Threads anunciou a realização da sua Conferência de Desenvolvedores MUSA 2026 (MDC 2026) em Pequim, que ocorrerá nos dias 29 e 30 de dezembro. A empresa comunicou isso em 11 de novembro, anunciando que mais de dez novos produtos, tecnologias e soluções seriam apresentados no evento.

O fundador, presidente e CEO Zhang Jianzhong fará uma palestra principal sobre os planos da empresa para computação de função completa baseada nos chamados GPUs de função completa, bem como sobre o roteiro da arquitetura.

Novidades Esperadas

Embora a Moore Threads ainda não tenha confirmado a lista de lançamentos, relatórios citados pela Sina Tech e Jiemian indicam que, até o final do ano, haverá no mercado a placa de computação de IA S6000 e a série de GPUs gráficas 'Lushan', construídas na arquitetura de próxima geração 'Huagang'. A placa S6000 é a sucessora da série S5000.

Mídias chinesas descrevem a S6000 como um elemento chave nos planos da empresa para criar clusters de 100.000 placas aceleradoras, mas as especificações da S6000 ainda não foram publicadas pela empresa. Além disso, a empresa demonstrou os supernós C128 e C256, e mais detalhes são esperados na conferência.

Características das GPUs Lushan

Quanto ao Lushan, os relatórios repetem dados que a Moore Threads apresentou pela primeira vez ao introduzir a arquitetura Huagang em dezembro passado: 16 vezes maior desempenho de processamento geométrico, 64 vezes maior desempenho de computação de IA e 50 vezes maior desempenho de rastreamento de raios, além de melhor preenchimento de texturas, acesso à memória atômica e maior capacidade de memória. O nível base desses multiplicadores não foi reafirmado nos relatórios recentes.

O Lushan combina renderização generativa de IA, uma arquitetura de renderização chamada UNITE e um novo motor de rastreamento de raios de hardware, e é destinado a jogos AAA de alto desempenho e trabalho gráfico profissional.

Escopo do Evento

De acordo com o Shanghai Securities News e o site da indústria ijiwei, o evento deste ano foi maior. Ele incluirá 26 fóruns temáticos em 11 áreas, incluindo 'fábricas' para treinamento de modelos, produção de tokens e agentes, inteligência de borda, supernós e infraestrutura de IA. A área de exposição aumentou de 1.000 para 3.000 metros quadrados, e espera-se a participação de mais de 4.000 desenvolvedores, em comparação com mais de 2.000 no evento anterior. O site da conferência está disponível em mdc.mthreads.com.

Informações sobre preços, prazos de entrega e testes independentes para ambas as linhas de produtos permanecem não divulgadas. As romanizações de 'Lushan' e 'Huagang' são nomes chineses; o estilo oficial em inglês da Moore Threads para eles, bem como o nome completo do produto S6000, não puderam ser confirmados.
Histórias semelhantes

Moore Threads adiciona suporte ao Kimi K3.1 Pro na GPU MTT S5000
Leia mais
pandaily.com

Moore Threads adiciona suporte ao Kimi K3.1 Pro na GPU MTT S5000

A Moore Threads anunciou a conclusão da adaptação de seu stack de software MUSA e do cartão MTT S5000 para treinamento e inferência de inteligência artificial para o modelo Kimi K3.1 Pro da Moonshot AI. De acordo com um comunicado publicado pela IT Home em 6 de novembro, este trabalho garante a conexão de carregamento do modelo, execução do serviço, bem como inferência básica de texto e gráficos.

O anúncio descreve o deploy funcional, e não uma análise comparativa de desempenho. A Moore Threads informou que migrou os caminhos chave de inferência do modelo e garantiu a execução estável no MTT S5000, mas o relatório não continha dados sobre taxa de transferência, latência, consumo de energia ou número de cartões utilizados. A empresa caracteriza isso como uma adaptação 'day-zero', enquanto a Moonshot lançou os pesos completos do modelo em 4 de novembro.

No nível do framework, a equipe utilizou o SGLang-MUSA para construir a base na implementação existente do modelo. A migração também exigiu a incorporação das bibliotecas de operadores MATE, Triton-MUSA, TileLang-MUSA e do compilador MTCC. O MUSA é responsável pela execução do framework, compilação de operadores, operação do ambiente de execução no dispositivo e comunicação entre múltiplos cartões, permitindo que os desenvolvedores reutilizem interfaces existentes ao adaptar novos caminhos computacionais.

Uma parte significativa do trabalho específica do modelo envolveu o processamento de memória e atenção. Para a atenção esparsa DSA, o stack adapta a seleção de índices, o layout do cache chave-valor, bem como as fases de pré-enchimento e decodificação. A Moore Threads observou que os operadores de atenção esparsa MATE trabalham em conjunto com o gerenciamento de estado Kimi Delta Attention, conexões residuais intercamadas e atenção visual para formar a cadeia de execução.

Outro desafio de implantação foram os pesos de especialista MXFP4 do modelo. Em vez de criar uma cópia offline completa no formato FP8 antes do serviço, a equipe converte os pesos online e reutiliza o espaço de trabalho FP8 entre camadas para os cálculos dos especialistas. Isso é apresentado como uma forma de colocar um modelo muito grande em operação sem a necessidade de preparação prévia de um conjunto completo de pesos convertidos.

O modelo Kimi K3.1 Pro suporta uma janela de contexto de cerca de um milhão de tokens e é destinado a tarefas de codificação, compreensão visual e operações de agentes de longa duração. A nova adaptação fornece mais uma opção de hardware para implantar seus pesos abertos, embora os detalhes da configuração de produção e da capacidade de serviço medida permaneçam não divulgados.

Vesperata de Diamantina confirma datas para 2027, com apresentações ao ar livre no centro histórico
Leia mais
viagemeturismo.abril.com.br

Vesperata de Diamantina confirma datas para 2027, com apresentações ao ar livre no centro histórico

A tradicional Vesperata de Diamantina estabeleceu as datas para o calendário de 2027. Durante o próximo ano, entre os meses de abril e outubro, o centro histórico da cidade mineira será palco de vinte espetáculos realizados ao ar livre.

Esta manifestação cultural, enraizada em tradições de séculos, consolidou-se como um evento essencial no calendário de Diamantina e contribuiu significativamente para que a cidade fosse incluída na lista do Patrimônio Mundial da Unesco. A popularidade do evento em 2026 foi tão grande que a organização precisou disponibilizar datas adicionais.

As vinte datas já confirmadas para a Vesperata 2027 estão agendadas para os meses de abril a outubro, sempre ocorrendo aos sábados, embora não todos os fins de semana recebam o evento. As apresentações ocorrerão nos seguintes dias:

  • 3, 17 e 24 de abril;
  • 8, 15 e 22 de maio;
  • 5, 12 e 19 de junho;
  • 3, 10 e 17 de julho;
  • 7, 14 e 21 de agosto;
  • 4 e 18 de setembro;
  • 2, 9 e 16 de outubro.

A Vesperata tem suas raízes em antigas serenatas que eram executadas entre as residências coloniais de Diamantina. Inicialmente uma expressão artística espontânea, ela foi resgatada como atração turística no final dos anos 1990, período em que a cidade promovia esforços para obter o status de Patrimônio Mundial da Unesco, conquista alcançada em 1997. Adicionalmente, em 2016, esta celebração recebeu o título de Patrimônio Imaterial de Minas Gerais.

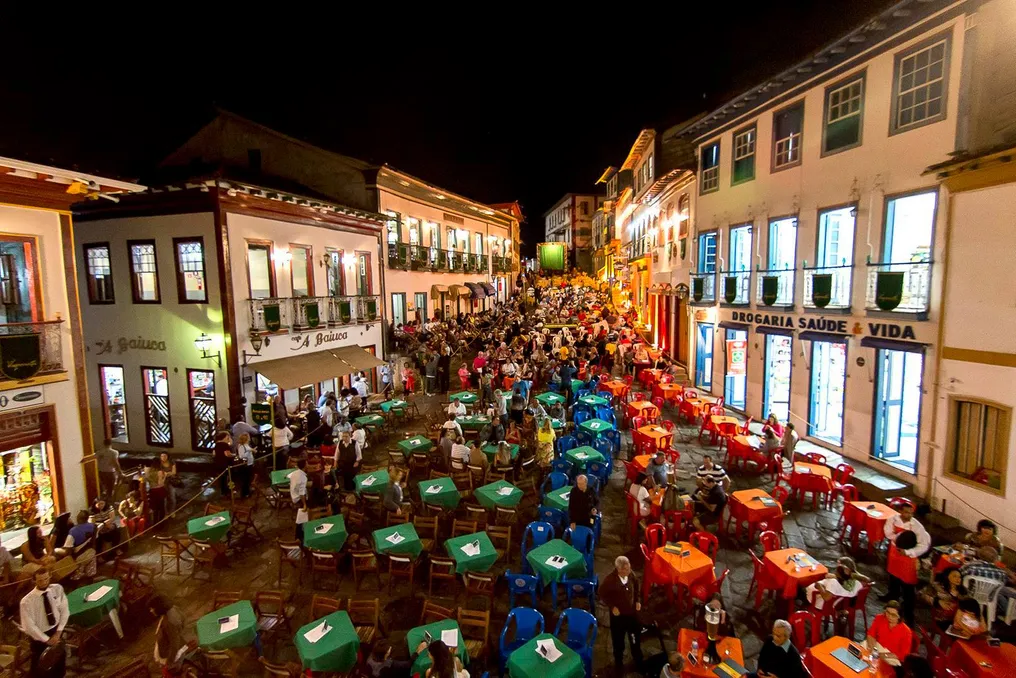
Os shows acontecem na Rua da Quitanda, onde os músicos se posicionam nas varandas das casas coloniais. Os espectadores podem assistir às apresentações gratuitamente, permanecendo em pé ou em outras áreas públicas da via. Contudo, o acesso às mesas oferecidas por bares e restaurantes localizados na rua requer a compra de ingressos separadamente.

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B
Leia mais
pandaily.com

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B

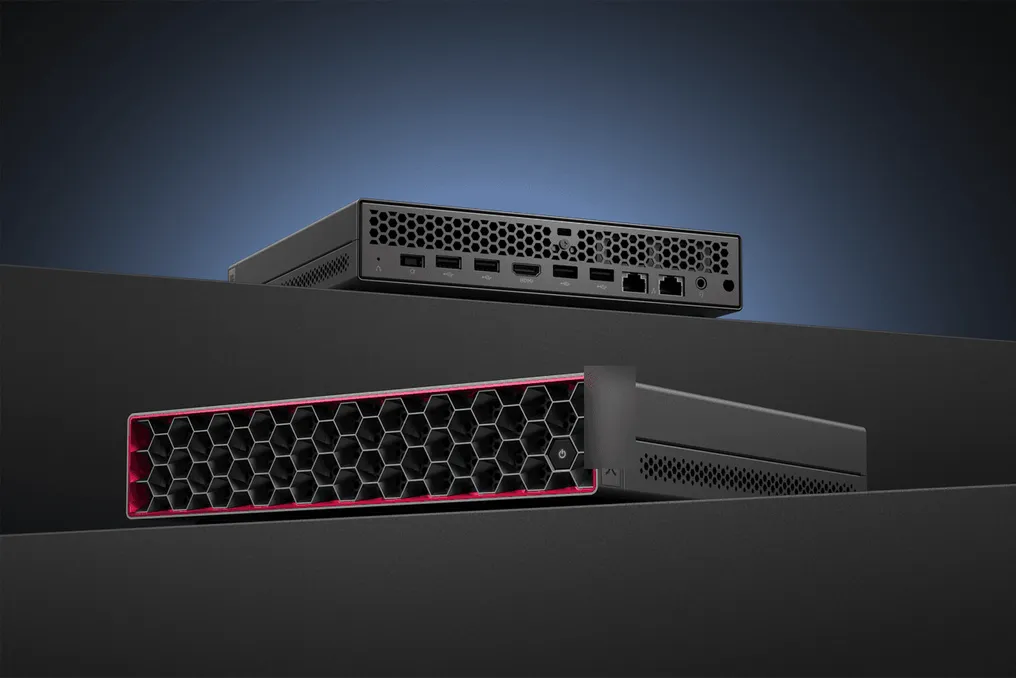
A Lenovo lançou o primeiro sistema host de IA da linha Kaitian, destinado ao mercado chinês de inovação em TI (Xinchuang). Este computador de mesa de 1,6 litros combina o processador Zhaoxin com a NPU de IA da Houmo, permitindo a execução local de modelos com cerca de 35 bilhões de parâmetros.

O dispositivo é equipado com um processador Zhaoxin KX-7000 de oito núcleos e a NPU Houmo Liqing LQ50. Na configuração padrão, o sistema oferece uma capacidade de computação de 160 TOPS no formato INT8, e com a opção NPU, essa capacidade pode atingir 320 TOPS. A NPU possui 24 GB de memória dedicada com largura de banda de 153,6 GB/s. O host opera sob o Kylin OS e vem pré-instalado com o agente Tianxi AI Pro da Lenovo.

A empresa realizou testes do dispositivo usando modelos abertos, incluindo as séries Qwen3.5 e Qwen3.6-35B-A3B. Ao usar os 24 GB da NPU e quantização W4A8, o modelo Qwen3.6-35B-A3B gerou texto a uma velocidade de aproximadamente 28,99 tokens por segundo durante a inferência local. O sistema suporta entrada de dados de até 200.000 tokens para processamento de documentos longos e tarefas multi-turn. A plataforma Houmo fornece aos desenvolvedores ferramentas para perfilagem, compilação, gerenciamento de tempo de execução e quantização de modelos.

A Lenovo posiciona este host como um funcionário digital permanente, projetado para operação 24 horas por dia. Isso permite que os agentes executem tarefas agendadas, como pesquisa de conhecimento local, elaboração de documentos e sumarização de informações, enquanto o processamento das saídas ocorre diretamente no dispositivo, e não através de tokens na nuvem, mantendo os dados localmente. No evento, os testadores do Tianxi AI Pro deram uma instrução para verificar o aplicativo de operadora móvel, e o dispositivo realizou uma chamada de teste, mediu o atraso do código SMS de verificação e forneceu um relatório.

Em relação à dissipação de calor, o processador e a NPU possuem canais de ar separados atrás do painel frontal hexagonal com ventiladores de alta pressão. A Lenovo relata que em marcha lenta, a temperatura da carcaça é de cerca de 33 graus Celsius em uma sala com temperatura de 25 graus, e sob carga total, atinge 41 graus. Em uma sala com temperatura de 35 graus, sob carga total, a temperatura atinge cerca de 46 graus. O nível de ruído é de 19,4 dB em modo de espera e cerca de 29,5 dB durante a inferência total da NPU. O dispositivo pesa cerca de 1,5 kg e é equipado com duas portas independentes de 2,5GbE.

Vale notar que o host Kaitian difere do Lenovo AI Host P7, que foi apresentado em outubro com chips Houmo M50 e CIX P1.

Popular