Huawei apresenta como o chip Kirin 9050 executa um modelo de 30 bilhões de parâmetros no dispositivo
Leia mais
TechNode
technode.com

Huawei apresenta como o chip Kirin 9050 executa um modelo de 30 bilhões de parâmetros no dispositivo

A Huawei revelou na quarta-feira detalhes sobre como a série de chips Kirin 9050 é capaz de executar inteligência artificial usando um modelo de 30 bilhões de parâmetros localmente, sem necessidade de conexão com a internet.

O novo processador neural Da Vinci deste chip permite executar o modelo diretamente no telefone graças ao uso de quantização de baixa precisão e coordenação eficiente de memória e recursos computacionais.

Um modelo do tipo 'mistura de especialistas' ativa aproximadamente 2 bilhões de parâmetros simultaneamente. Anteriormente, a Huawei divulgou esse número durante sua conferência de chips em outubro, e esta semana a empresa descreveu como o mesmo processador suporta funcionalidades como leitura de tela por IA e virar páginas com rastreamento ocular.

Histórias semelhantes

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B
Leia mais
pandaily.com

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B

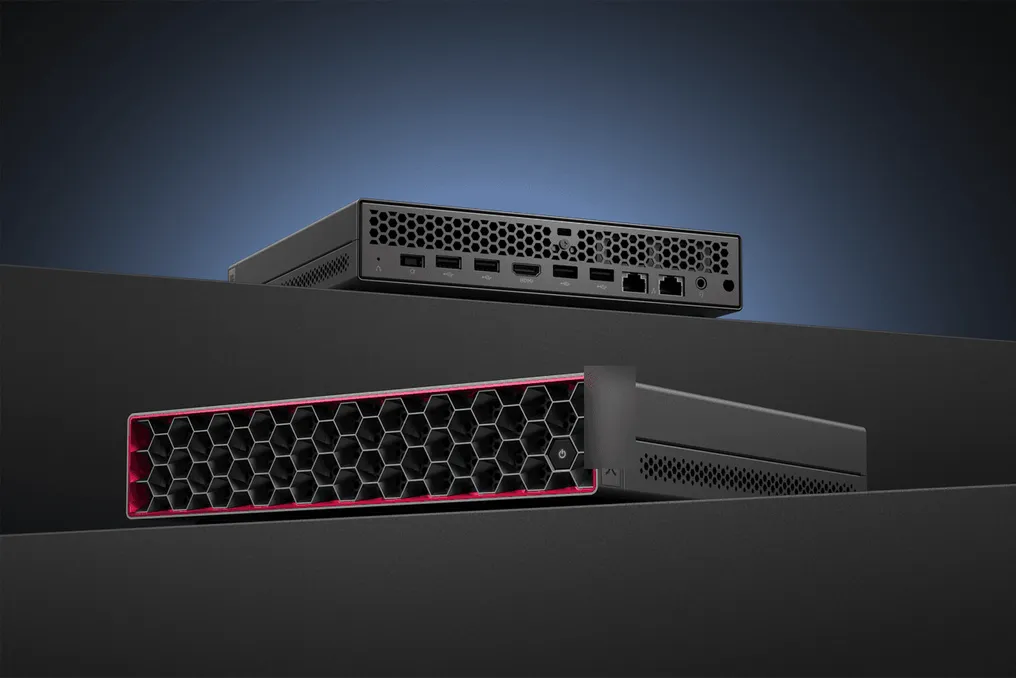
A Lenovo lançou o primeiro sistema host de IA da linha Kaitian, destinado ao mercado chinês de inovação em TI (Xinchuang). Este computador de mesa de 1,6 litros combina o processador Zhaoxin com a NPU de IA da Houmo, permitindo a execução local de modelos com cerca de 35 bilhões de parâmetros.

O dispositivo é equipado com um processador Zhaoxin KX-7000 de oito núcleos e a NPU Houmo Liqing LQ50. Na configuração padrão, o sistema oferece uma capacidade de computação de 160 TOPS no formato INT8, e com a opção NPU, essa capacidade pode atingir 320 TOPS. A NPU possui 24 GB de memória dedicada com largura de banda de 153,6 GB/s. O host opera sob o Kylin OS e vem pré-instalado com o agente Tianxi AI Pro da Lenovo.

A empresa realizou testes do dispositivo usando modelos abertos, incluindo as séries Qwen3.5 e Qwen3.6-35B-A3B. Ao usar os 24 GB da NPU e quantização W4A8, o modelo Qwen3.6-35B-A3B gerou texto a uma velocidade de aproximadamente 28,99 tokens por segundo durante a inferência local. O sistema suporta entrada de dados de até 200.000 tokens para processamento de documentos longos e tarefas multi-turn. A plataforma Houmo fornece aos desenvolvedores ferramentas para perfilagem, compilação, gerenciamento de tempo de execução e quantização de modelos.

A Lenovo posiciona este host como um funcionário digital permanente, projetado para operação 24 horas por dia. Isso permite que os agentes executem tarefas agendadas, como pesquisa de conhecimento local, elaboração de documentos e sumarização de informações, enquanto o processamento das saídas ocorre diretamente no dispositivo, e não através de tokens na nuvem, mantendo os dados localmente. No evento, os testadores do Tianxi AI Pro deram uma instrução para verificar o aplicativo de operadora móvel, e o dispositivo realizou uma chamada de teste, mediu o atraso do código SMS de verificação e forneceu um relatório.

Em relação à dissipação de calor, o processador e a NPU possuem canais de ar separados atrás do painel frontal hexagonal com ventiladores de alta pressão. A Lenovo relata que em marcha lenta, a temperatura da carcaça é de cerca de 33 graus Celsius em uma sala com temperatura de 25 graus, e sob carga total, atinge 41 graus. Em uma sala com temperatura de 35 graus, sob carga total, a temperatura atinge cerca de 46 graus. O nível de ruído é de 19,4 dB em modo de espera e cerca de 29,5 dB durante a inferência total da NPU. O dispositivo pesa cerca de 1,5 kg e é equipado com duas portas independentes de 2,5GbE.

Vale notar que o host Kaitian difere do Lenovo AI Host P7, que foi apresentado em outubro com chips Houmo M50 e CIX P1.

Equipe da Universidade de Pequim porta software DFT ABACUS para processador Huawei Kunpeng 920, alcançando aceleração de até 10,7 vezes
Leia mais
pandaily.com

Equipe da Universidade de Pequim porta software DFT ABACUS para processador Huawei Kunpeng 920, alcançando aceleração de até 10,7 vezes

Um grupo de pesquisa liderado por Chen Mohan da Universidade de Pequim adaptou o ABACUS — um pacote de código aberto para teoria do funcional da densidade (DFT) desenvolvido na China — para toda a linha de processadores Huawei Kunpeng 920. Além disso, a equipe otimizou 19 classes diferentes de operadores principais. A Huawei Computing relatou isso em uma publicação de 31 de outubro, conforme noticiado pelo IT Home. O código foi carregado no repositório do projeto no GitHub.

A Teoria do Funcional da Densidade (DFT) é um método fundamental de primeiro princípio para estudar as propriedades de materiais como metais e semicondutores. O ABACUS foi desenvolvido em colaboração com várias instituições e possui mais de mil usuários em mais de cem organizações.

De acordo com os dados da equipe, ao configurar ambos os lados com 28 núcleos e executar 28 processos com um thread por processo, a compilação Kunpeng 920, que utiliza o conjunto de instruções SVE, mostrou uma velocidade de 1,3 a 3,9 vezes superior à de uma CPU x86 padrão ao trabalhar com um conjunto padrão de 10 sistemas materiais contendo de 8 a 216 átomos, incluindo GaAs, MoS2, BaTiO3, ferro e silício. Ao usar o bloco de computação matricial do chip, a aceleração atingiu até 10,7 vezes ao operar em todos os núcleos de um nó. Em casos de DFT estocástica, a equipe registrou um aumento de velocidade de 2,8 a 3,1 vezes para SVE e de 6,1 a 20,1 vezes para a compilação usando o bloco matricial.

A primeira etapa foi a portabilidade, pois diferentes modelos do Kunpeng 920 suportam instruções vetoriais NEON, SVE ou SVE512, bem como um bloco matricial dedicado, que permanecem inutilizados ao usar opções de compilador genéricas. A equipe criou cadeias de ferramentas separadas: para compilações NEON e SVE, foi usado gcc com OpenMPI e OpenBLAS, e para os demais, clang com HMPI e KBLAS da Huawei, além de ter sido adicionada a opção USE_KML para integração da Biblioteca Matemática Kunpeng. Todas as versões compiladas passaram por testes de integração do ABACUS, cobrindo DFT por ondas planas e LCAO Kohn-Sham, DFT estocástica e DeePKS, com resultados consistentes com as implementações principais.

Em seguida, a equipe reescreveu operadores pequenos e frequentemente chamados. A substituição do procedimento recursivo do polinômio geral de Laguerre por um recursivo iterativo permitiu reduzir a complexidade para O(n) e tornou-o aproximadamente oito vezes mais rápido em um teste de milhão. A mudança da busca de interpolação para busca binária reduziu o número médio de comparações em uma tabela de 400 entradas de cerca de 200 para nove. Outras alterações incluíram recursões trigonométricas, elevação de invariantes de ciclo, ajuste de precisão mista e layout de memória, sendo que os resultados numéricos de cada operador foram verificados novamente.

Usando a otimização automática de código no DevKit da Huawei, a equipe também aumentou a velocidade de processamento do caso de carbono de alta densidade de 8 átomos em 2,28 vezes e do caso de silício de 512 átomos em 2,66 vezes no modelo Kunpeng 920 mais novo. A Huawei observa que a experiência de otimização obtida pode ser aplicada a outros softwares científicos.
Huawei indica pela primeira vez o Kirin 9000S como processador no modelo Mate 60 Pro
Leia mais
pandaily.com

Huawei indica pela primeira vez o Kirin 9000S como processador no modelo Mate 60 Pro

A Huawei nomeou oficialmente pela primeira vez o chip Kirin 9000S como processador para o smartphone Mate 60 Pro em um de seus documentos internos de especificações, informou o portal IT Home em 30 de outubro. Essa informação surgiu em uma publicação na conta oficial da Huawei no WeChat, que divulgava ofertas da série Mate 90 e apresentava as principais características dos modelos Mate 30, 40, 50 e 60 Pro ao lado do novo Mate 90 Pro.

Na tabela comparativa de desempenho, a Huawei indicou que o Mate 90 Pro é equipado com Kirin 9035, enquanto o Mate 60 Pro utiliza o Kirin 9000S. Além disso, o Mate 50 Pro usa o primeiro geração Snapdragon 8+ 4G, o Mate 40 Pro usa o Kirin 9000, e o Mate 30 Pro 5G usa o Kirin 990 5G. O modelo Mate 60 Pro possui 12 GB de RAM e oferece opções de armazenamento de 256 GB, 512 GB ou 1 TB, enquanto o Mate 90 Pro pode chegar a 16 GB e 1 TB.

Apesar de o Mate 60 Pro ter sido lançado em 2023, o fabricante não havia especificado o modelo do chip em páginas oficiais do produto ou em folhas de dados técnicos. Anteriormente, aplicativos de terceiros para testes de desempenho identificaram o processador como Kirin 9000S, destacando sua arquitetura octa-core com 12 threads e suporte a hyperthreading.

Em um evento realizado em 28 de outubro, He Gang, diretor de dispositivos de consumo da Huawei, declarou que a série Mate 60 marcou o retorno dos chips Kirin em 2023. No slide apresentado por He Gang, foi exibido o modelo Kirin 9000S, mas o chip não foi associado à série Mate 60. O anúncio oficial sobre o nome do chip do telefone foi feito pela Huawei em setembro de 2025, durante a apresentação do Kirin 9020 junto com o dispositivo dobrável Mate XTs.

O mesmo diagrama demonstra a evolução de outras características ao longo de cinco gerações. Os tamanhos das telas variam de 6,53 polegadas no Mate 30 Pro 5G a 6,82 polegadas no Mate 60 Pro e 6,75 polegadas no Mate 90 Pro. A taxa de atualização aumentou de 60 Hz para 120 Hz. A capacidade da bateria cresceu de 4.500 mAh no Mate 30 Pro 5G para 5.000 mAh no Mate 60 Pro e 6.600 mAh no Mate 90 Pro, sendo que o último modelo suporta carregamento com fio de 100 W e sem fio de 50 W.

Popular