MiniMax lança modelo H3-Image com pesos abertos para geração e edição de imagens de 16 MP
Leia mais
Pandaily
pandaily.com

MiniMax lança modelo H3-Image com pesos abertos para geração e edição de imagens de 16 MP

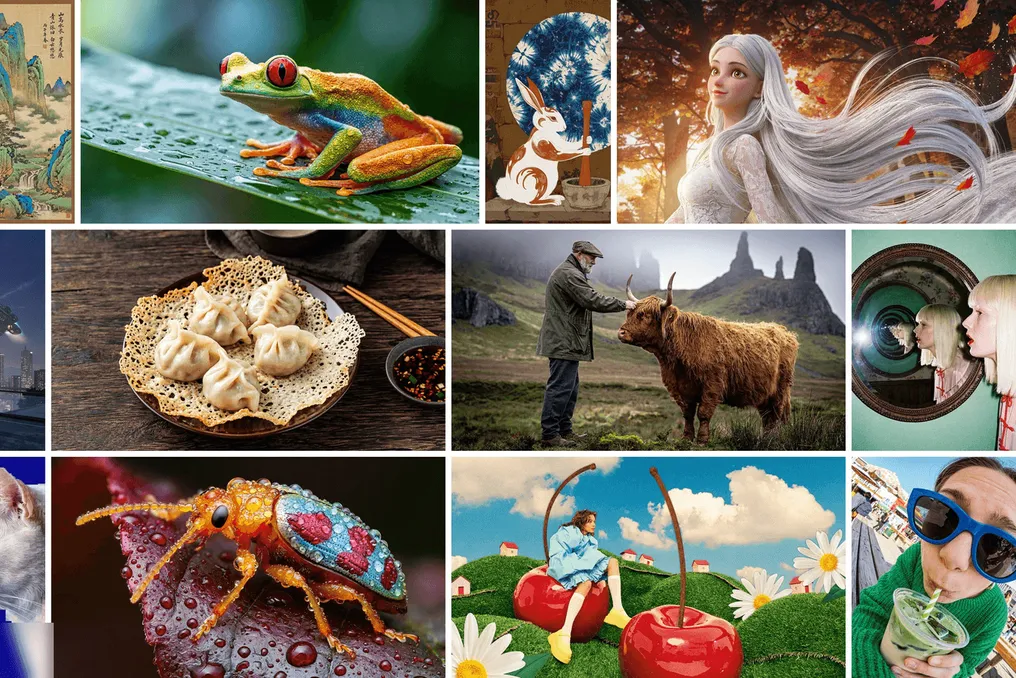
A empresa MiniMax apresentou o modelo MiniMax-H3-Image com pesos abertos. Este modelo é destinado a tarefas de conversão de texto em imagem e edição de imagens, e faz parte da família H3 da empresa.

O lançamento ocorreu no final da noite de 10 de novembro, e os pesos estão disponíveis na plataforma Hugging Face. De acordo com a MiniMax, este modelo é capaz de gerar imagens com resolução de cerca de 16 megapixels, tamanho de 4096 por 4096 com proporção de aspecto 1:1, em menos de 10 segundos. A empresa afirma que isso é aproximadamente cinco vezes mais rápido do que a média do mercado para essa resolução.

Características e capacidades do modelo

De acordo com o cartão do modelo, um único arquivo de controle pode realizar tanto a conversão de texto em imagem quanto a edição de uma ou várias imagens de referência, aceitando até 16 referências. O transformador de difusão possui 33,1 bilhões de parâmetros, utiliza a arquitetura H3, mas sem camadas de áudio, e foi destilado para seis etapas de amostragem sem o uso de classificador sem guia livre. O codificador de texto do modelo é um componente separado — o codificador de texto MiniMax-H3.

A MiniMax indica que as dimensões de saída podem atingir 6272 por 2688 sem o uso de upscaler. O arquivo no formato BF16 pesa 68,65 GB, e o modelo de extensão de prompt adicional chamado MiniMax-H3-Image-PE tem tamanho de 17,9 GB.

A empresa afirma que o seguimento de instruções pelo modelo é o mais forte entre os modelos de código aberto para imagens, e ele evita a aparência característica de 'inteligência artificial'. Estas declarações são alegações próprias da empresa, e não havia comparações independentes no material original.

O cartão do modelo recomenda o uso de SGLang, vLLM-Omni, diffusers e ComfyUI para implantação local, e também lista aceleradores NVIDIA e AMD. O modelo também está disponível via API e aplicativos MiniMax, e durante a primeira semana, a empresa oferece um desconto de 50% nas chamadas de API para imagens de 16 megapixels ou mais.

Condições de licenciamento

A licença aplicada ao modelo chama-se MiniMax-H3-Image Community License Agreement e não é uma licença padrão de código aberto. Este acordo é válido em todo o mundo, exceto na União Europeia, Reino Unido, Coreia do Sul e Estados Unidos, e estabelece que o uso fora deste território não é sancionado pelo contrato. Além disso, exige permissão escrita separada da MiniMax para usuários cujo rendimento anual exceda 1 milhão de dólares americanos, ou para aqueles que fornecem serviços de hospedagem a terceiros. Produtos comerciais também devem exibir a inscrição 'MiniMax-H3-Image' em sua interface.

Este lançamento se seguiu ao lançamento anterior de pesos abertos da MiniMax para vídeo e áudio, baseado no modelo H3.
Histórias semelhantes

Moonshot AI lança pesos do modelo Kimi K3.1 Pro para implantação independente
Leia mais
technode.com

Moonshot AI lança pesos do modelo Kimi K3.1 Pro para implantação independente

A Moonshot AI publicou os pesos de seu modelo multimodal principal, Kimi K3.1 Pro, na plataforma Hugging Face, permitindo que os usuários implantem o modelo por conta própria.

O modelo é construído em uma arquitetura de mistura de especialistas (mixture-of-experts) e possui um total de 2,8 trilhões de parâmetros, sendo que cerca de 104 bilhões de parâmetros são ativados a cada inferência. Além disso, ele suporta uma janela de contexto de aproximadamente um milhão de tokens.

A versão K3.1 Pro representa um avanço do modelo Kimi K3, ao qual foram adicionados métodos avançados de aprendizado por reforço para tarefas relacionadas a codificação, criação de objetos tridimensionais, pesquisa financeira e execução de tarefas longas de agente.

O lançamento dos pesos ocorreu após o modelo se tornar acessível através de aplicativos e da API do serviço Kimi. Também foi anunciado que a Huawei forneceu suporte de inferência através dos sistemas Atlas A3 e Ascend 950, utilizando vLLM Ascend e SGLang.

Tencent lança o modelo Hy4 com capacidades de visão computacional e controle
Leia mais
technode.com

Tencent lança o modelo Hy4 com capacidades de visão computacional e controle

A Tencent apresentou seu modelo de inteligência artificial principal, o Hy4, que ganhou capacidades de compreensão visual e a habilidade de interagir com o computador. O lançamento do modelo ocorreu em 4 de novembro.

O Hy4 é capaz de analisar gráficos e documentos, realizar raciocínios com base em múltiplas imagens, bem como controlar ferramentas de linha de comando e interfaces gráficas. O processo de treinamento abrange aplicações como Blender e software CAD, além de tarefas que exigem o trabalho em vários programas simultaneamente.

O modelo Hy4 possui 770 bilhões de parâmetros e está disponível nos produtos da própria Tencent, bem como através de plataformas de terceiros, incluindo OpenRouter. Em breve, a empresa planeja publicar os pesos do modelo e um cartão de sistema especial.

A precificação padrão da API permaneceu a mesma em comparação com a pré-visualização do Hy4: o custo é de US$ 0,834 por milhão de tokens de entrada e US$ 2,501 por milhão de tokens de saída. Além disso, há um desconto de 50% no Tencent Cloud TokenHub até 31 de dezembro.

A Tencent integrou o Hy4 nos produtos WorkBuddy e CodeBuddy, oferecendo um limite de uso gratuito limitado de 4 a 15 de novembro. Também está planejada a criação de uma versão mais econômica do modelo Hy4 Flash. A empresa observou que o desenvolvimento se concentrou em tarefas de escritório, análise financeira e criação de jogos, com as equipes de desenvolvimento ajudando a treinar e avaliar o modelo com base em fluxos de trabalho reais.

DiffuSpace lança o modelo Clover-35B-A3B — um modelo de linguagem difusional para agentes e codificação
Leia mais
pandaily.com

DiffuSpace lança o modelo Clover-35B-A3B — um modelo de linguagem difusional para agentes e codificação

A equipe da DiffuSpace, que anteriormente desenvolveu o modelo de linguagem difusional Dream 7B, lançou e disponibilizou publicamente o modelo Clover-35B-A3B-Preview. Este modelo é projetado para executar tarefas tradicionalmente resolvidas por grandes modelos de linguagem convencionais, como escrita de código, interação com ferramentas, navegação na web e criação de interfaces front-end.

A maioria dos modelos de linguagem existentes opera de forma autorregressiva, ou seja, prevê tokens sequencialmente, onde cada novo token depende dos anteriores. Os modelos de linguagem difusivos utilizam uma abordagem diferente: eles atualizam múltiplos pontos simultaneamente e refinam o resultado ao longo de vários rodadas, restaurando texto oculto ou ruidoso em uma resposta coerente. Este método promete geração mais rápida, mas historicamente os modelos difusivos demonstraram falta de confiabilidade na execução de tarefas de agentes, frequentemente levando a chamadas incorretas de ferramentas e repetição de passos malsucedidos.

O Clover utiliza o método de difusão em blocos. O fluxo de saída é dividido em blocos que são gerados sequencialmente, enquanto as posições dentro de cada bloco são limpas de ruído em paralelo. A equipe relatou que, para isso, reestruturaram a base Gated DeltaNet para supressão de ruído paralela no nível do bloco e adicionaram calibração de tamanho de bloco treinável. O modelo apresenta uma arquitetura de tipo 'mistura de especialistas' com um total de 35 bilhões de parâmetros e aproximadamente 3 bilhões de parâmetros ativos por token, além de suportar modo de raciocínio.

De acordo com os dados publicados pela equipe, o Clover obteve um resultado de 73.6 no SWE-bench Verified e 51.7 no Terminal-Bench 2.1. Em relação ao uso de ferramentas, o modelo alcançou 65.3 no benchmark geral tau-cubed e 67.9 no BFCL-v4. A equipe afirma que esses resultados superam os modelos autorregressivos de tamanho semelhante, incluindo o Qwen3.6-35B-A3B. Deve-se notar que todos esses números são auto-relatados e ainda não passaram por verificação independente.

A principal vantagem é a velocidade. A DiffuSpace declara uma velocidade de 515 tokens por segundo na execução de tarefas de agente em um único chip NVIDIA H200, em comparação com 365 tokens por segundo ao usar a configuração de decodificação especulativa DFlash2, e uma velocidade geral de 680 tokens por segundo em um único GB300. Em um cenário de teste de agente web que cobriu 49 tarefas, o tempo médio de execução do Clover foi de 1,52 segundos.

Os pesos do modelo estão disponíveis nas plataformas Hugging Face, GitHub e ModelScope sob a licença Apache 2.0. A DiffuSpace também oferece acesso de teste através de seu site e anuncia o desenvolvimento de ferramentas para agentes e um cliente de desktop para codificação. Como o Clover é designado como versão preliminar, sua confiabilidade em cenários reais de fluxos de trabalho de agentes de longa duração exigirá testes externos. No entanto, este é um dos maiores modelos de linguagem difusivo abertos focados diretamente em tarefas de codificação e uso de agentes.

Popular