Alibaba Cloud adiciona suporte ao Kimi K3.1 Pro na plataforma Lingjun Zhenwu M890 SuperPoD
Leia mais
Pandaily
pandaily.com

Alibaba Cloud adiciona suporte ao Kimi K3.1 Pro na plataforma Lingjun Zhenwu M890 SuperPoD

A Alibaba Cloud anunciou que seu sistema Lingjun Zhenwu M890 SuperPoD concluiu a adaptação do modelo Kimi K3.1 Pro da Moonshot AI no modo day-zero. Uma verificação completa da pilha nos frameworks de inferência vLLM e SGLang também foi realizada. Isso foi divulgado em 5 de novembro, segundo a IT Home, citando o provedor de nuvem.

A empresa também abriu testes convidados para uma nova região SuperPoD em Zhongwei, Ningxia, expandindo a lista de locais onde grandes modelos de código aberto podem ser hospedados nos aceleradores próprios da empresa.

Características do Modelo e Adaptação Conjunta

O modelo Kimi K3.1 Pro é um modelo esparso do tipo mixture-of-experts com 2,8 trilhões de parâmetros e uma janela de contexto de cerca de um milhão de tokens. Ele utiliza atenção híbrida Kimi Delta Attention e atenção esparsa DSA, além de capacidade preditiva multi-token. Essas características criam exigências significativas de largura de banda de memória e interconexões de alta velocidade para escalonamento.

Alibaba Cloud, T-Head e a equipe Kimi adaptaram conjuntamente este modelo na pilha de software SAIL da T-Head. O trabalho nos operadores FlashMLA, DeepGEMM MoE, MegaMoE e MoonEP permitiu que os clientes implantassem a inferência tanto em instâncias SuperPoD bare-metal quanto através do serviço de motor inteligente REIN. Além disso, o modelo está disponível através da API da plataforma Qwen AI da Alibaba.

Suporte em Frameworks e Novos Recursos

Relatórios independentes sobre o suporte day-zero dos projetos SGLang e vLLM descrevem o suporte ao Zhenwu PPU para Kimi K3.1 Pro nas configurações M890 e 810E. Este lançamento é marcado como o primeiro suporte a um grande modelo de código aberto dentro do backend de hardware na árvore de desenvolvimento Zhenwu. A documentação da Alibaba Cloud publica receitas de prefill-decode para instâncias Zhenwu M890 SuperPoD, incluindo configurações de paralelismo tensorial e de especialista para múltiplos nós.

O convite para o SuperPoD em Zhongwei inclui a placa de rede inteligente Panmai 920 da T-Head sobre as configurações de alto desempenho anteriormente existentes. A Alibaba afirma que este cartão utiliza PCIe 5.0 e Ethernet PAM4 a 112G, atingindo uma largura de banda de pico de 400 Gbps e 400 milhões de pacotes por segundo. Ele suporta RDMA multipath e controle programável de congestionamento, além de integrar um switch PCIe no próprio cartão, permitindo que GPUs e SSDs se conectem com menor dependência de um switch externo — um design que, segundo a empresa, pode reduzir os custos do sistema em cerca de 30%.

As instâncias SuperPoD day-zero para grandes modelos estão disponíveis nos data centers de Ulan Bator e Zhongwei. A Alibaba Cloud observa que as instâncias Lingjun Zhenwu M890 SuperPoD já atendem mais de 100 grandes clientes nos campos de grandes modelos, direção autônoma e IA incorporada. A empresa também reiterou que espera que a instância SuperPoD de próxima geração Zhenwu V900 forneça aproximadamente três vezes mais desempenho em comparação com a geração atual. Este anúncio coincide com o suporte separado ao Kimi K3.1 Pro no modo day-zero da Huawei Ascend, relatado na mesma semana, fornecendo dois caminhos domésticos de lançamento para o modelo nas pilhas SuperPoD.
Histórias semelhantes

Huawei Ascend adiciona suporte ao Kimi K3.1 Pro para Atlas A3 e Ascend 950 SuperPoDs
Leia mais
pandaily.com

Huawei Ascend adiciona suporte ao Kimi K3.1 Pro para Atlas A3 e Ascend 950 SuperPoDs

A equipe de sistemas de computação da Huawei Ascend anunciou a conclusão da adaptação para inferência do modelo Kimi K3.1 Pro, que possui 2,8 trilhões de parâmetros. Os pesos completos deste modelo foram lançados pela Moonshot AI em 4 de novembro, de acordo com a conta oficial da Huawei Computing, conforme relatado pelo IT Home e ifeng Tech.

Usando vLLM Ascend e SGLang, os desenvolvedores agora podem implantar este modelo nos servidores Atlas 800 A3, no cluster Atlas 900 A3 SuperPoD e na série Ascend 950 SuperPoD desde seu lançamento.

O Kimi K3.1 Pro é o primeiro modelo da série K3.1 da Moonshot AI. É um modelo do tipo mixture-of-experts com processamento visual nativo e uma janela de contexto de cerca de um milhão de tokens, ativando aproximadamente 104 bilhões de parâmetros em cada etapa de inferência. O modelo mantém a atenção linear híbrida K3, baseada nas camadas Kimi Delta Attention (KDA), e adiciona camadas de atenção esparsa DSA em vez de algumas camadas de atenção completa para reduzir os custos de modelagem de contexto longo.

Grande parte do trabalho de adaptação estava relacionada especificamente a essa arquitetura. A Huawei declarou que sua equipe de inferência se baseou na adaptação anterior do Kimi K3, analisando previamente o novo modelo e trabalhando paralelamente na integração do modelo, desenvolvimento de operadores e validação de serviços. Graças ao suporte já existente para KDA e MoE, a equipe adicionou um novo caminho de atenção esparsa e inferência multimodal, mantendo as funções de serviço existentes nos frameworks de inferência.

De acordo com informações da Huawei, a otimização abrangeu operadores principais para seleção de histórico, cálculos de atenção esparsa, pré-processamento e cálculos residuais, que foram combinados com cache distribuído e funcionalidades em nível de framework para suportar inferência de contexto longo e manutenção de produção. A empresa estabeleceu como meta que usuários e desenvolvedores pudessem começar a testar aplicativos e implantações no primeiro dia de lançamento do modelo.

A documentação do vLLM Ascend indica que o Kimi K3.1 Pro é suportado em modo experimental na versão vLLM Ascend 0.30.0. Suas configurações de referência utilizam a divisão de prefixo e decodificação em oito nós, com quatro nós de prefixo e quatro nós de decodificação, incluindo a configuração de contexto longo de um milhão de tokens. Os servidores Atlas 800I A3 operam com o checkpoint quantizado W4A8, enquanto os produtos 950DT usam a variante W4A8 MXFP; a liderança observa que os produtos Atlas A2 e 950PR ainda não são suportados.

O tamanho do modelo torna o suporte de hardware uma questão prática. O IT Home observa que os pesos no formato BF16 ocupam cerca de 5,6 TB e ainda exigem cerca de 1,4 TB após a quantização INT4, o que exclui o uso de uma única GPU de consumidor. A Huawei posicionou seus sistemas A3 e 950 SuperPoD para esta classe de inferência MoE com parâmetros trilionários, e o lançamento do Kimi K3.1 Pro foi o último modelo aberto que ela suportou no dia do lançamento.

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B
Leia mais
pandaily.com

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B

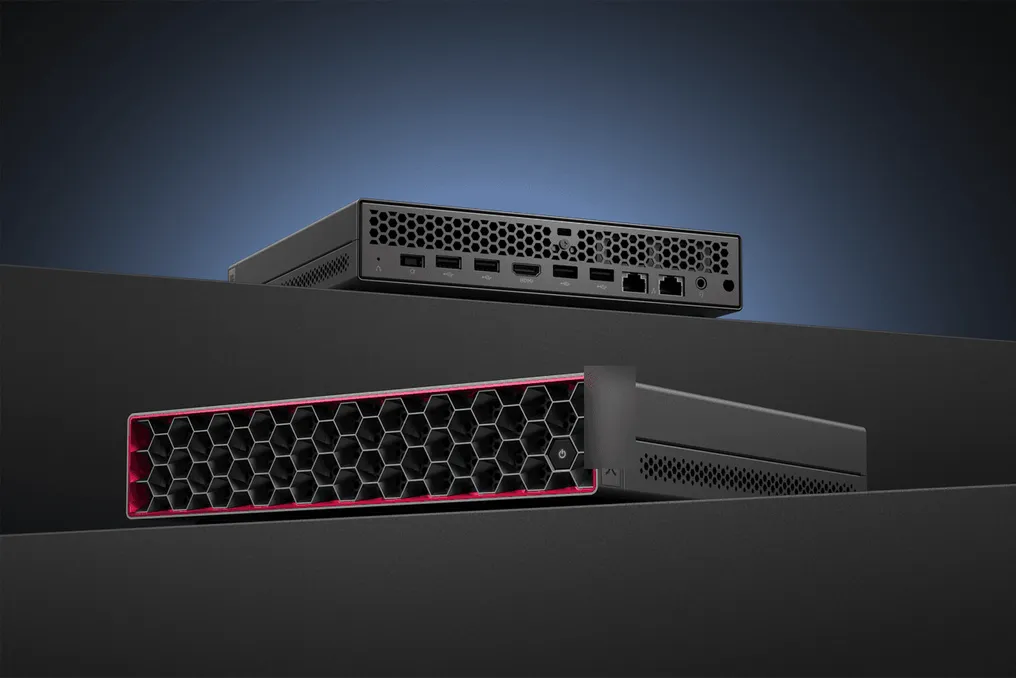
A Lenovo lançou o primeiro sistema host de IA da linha Kaitian, destinado ao mercado chinês de inovação em TI (Xinchuang). Este computador de mesa de 1,6 litros combina o processador Zhaoxin com a NPU de IA da Houmo, permitindo a execução local de modelos com cerca de 35 bilhões de parâmetros.

O dispositivo é equipado com um processador Zhaoxin KX-7000 de oito núcleos e a NPU Houmo Liqing LQ50. Na configuração padrão, o sistema oferece uma capacidade de computação de 160 TOPS no formato INT8, e com a opção NPU, essa capacidade pode atingir 320 TOPS. A NPU possui 24 GB de memória dedicada com largura de banda de 153,6 GB/s. O host opera sob o Kylin OS e vem pré-instalado com o agente Tianxi AI Pro da Lenovo.

A empresa realizou testes do dispositivo usando modelos abertos, incluindo as séries Qwen3.5 e Qwen3.6-35B-A3B. Ao usar os 24 GB da NPU e quantização W4A8, o modelo Qwen3.6-35B-A3B gerou texto a uma velocidade de aproximadamente 28,99 tokens por segundo durante a inferência local. O sistema suporta entrada de dados de até 200.000 tokens para processamento de documentos longos e tarefas multi-turn. A plataforma Houmo fornece aos desenvolvedores ferramentas para perfilagem, compilação, gerenciamento de tempo de execução e quantização de modelos.

A Lenovo posiciona este host como um funcionário digital permanente, projetado para operação 24 horas por dia. Isso permite que os agentes executem tarefas agendadas, como pesquisa de conhecimento local, elaboração de documentos e sumarização de informações, enquanto o processamento das saídas ocorre diretamente no dispositivo, e não através de tokens na nuvem, mantendo os dados localmente. No evento, os testadores do Tianxi AI Pro deram uma instrução para verificar o aplicativo de operadora móvel, e o dispositivo realizou uma chamada de teste, mediu o atraso do código SMS de verificação e forneceu um relatório.

Em relação à dissipação de calor, o processador e a NPU possuem canais de ar separados atrás do painel frontal hexagonal com ventiladores de alta pressão. A Lenovo relata que em marcha lenta, a temperatura da carcaça é de cerca de 33 graus Celsius em uma sala com temperatura de 25 graus, e sob carga total, atinge 41 graus. Em uma sala com temperatura de 35 graus, sob carga total, a temperatura atinge cerca de 46 graus. O nível de ruído é de 19,4 dB em modo de espera e cerca de 29,5 dB durante a inferência total da NPU. O dispositivo pesa cerca de 1,5 kg e é equipado com duas portas independentes de 2,5GbE.

Vale notar que o host Kaitian difere do Lenovo AI Host P7, que foi apresentado em outubro com chips Houmo M50 e CIX P1.

Moonshot AI apresenta solução para desenvolvimento de jogos com agentes K3.1 em Unity, Unreal e Blender
Leia mais
pandaily.com

Moonshot AI apresenta solução para desenvolvimento de jogos com agentes K3.1 em Unity, Unreal e Blender

A Moonshot AI lançou uma solução abrangente para criação de jogos e trabalhos criativos, baseada na série de modelos Kimi K3.1, produtos Kimi Code e Kimi Work, além de plugins para ferramentas profissionais, incluindo Unity, Unreal Engine e Blender.

De acordo com o comunicado da empresa, este pacote visa ajudar os estúdios a testar conceitos de jogos mais rapidamente, impulsionar a produção de engenharia e arte, e integrar feedback dos jogadores obtido durante o lançamento e operação de volta à próxima fase de desenvolvimento.

Na descrição, o modelo Kimi é capaz de analisar documentos de design, capturas de tela, código-fonte e ativos 3D, planejando então o trabalho necessário. O produto Kimi Code lida com a implementação de alterações dentro da base de código existente, enquanto o Kimi Work assume tarefas de produção multifásicas que abrangem vários arquivos.

Graças aos plugins e chamadas de ferramentas, o Kimi pode trabalhar diretamente com projetos existentes, retornando ao usuário arquivos editáveis juntamente com um relatório das ações executadas. Nos ambientes Unity e Unreal Engine, após obter as permissões necessárias e os arquivos do projeto, o sistema primeiro mapeia a estrutura do código, a hierarquia das cenas e as dependências dos módulos, em seguida, insere alterações através dos plugins do editor e, por fim, verifica o resultado através de passos de reprodução, logs e dados de tempo de execução. Para os engenheiros, são mantidos relatórios de diferenças no código e registros de verificação.

Para operar no Unity, os modelos Kimi utilizam o agente Tuanjie Codely Agent, que é um agente de jogo da Unity China e está integrado ao Tuanjie Engine. O Kimi interpreta as intenções do desenvolvedor, escreve código e analisa os resultados de testes e gravações de tela, enquanto o agente Codely executa operações dentro do motor por meio de scripts do editor e tempo de execução. Durante uma demonstração, o Kimi demonstrou ser capaz de operar por 20 horas sem intervenção humana, recriando um jogo existente e criando um projeto nativo que pode ser desenvolvido posteriormente.

Na página de lançamento, há várias compilações de demonstração criadas com o Kimi K3.1 Pro. No Blender, foi construído um vale interior da selva e renderizado um voo de 17,5 segundos em resolução 1920x1080 a 60 quadros por segundo, bem como o interior de uma catedral no navegador, contendo cerca de 3,3 milhões de triângulos e 8368 componentes animados. No Unreal Engine 5.8, foi criada uma cena de palácio celestial com uma colunata de 36 arcos em um raio de 1750 metros e um dragão modelado proceduralmente, totalizando 36 milhões de triângulos, renderizado usando Nanite e Lumen. O Kimi também afirma que designers sem experiência em programação podem criar protótipos jogáveis no Godot em um ou dois dias.

Além das tarefas de produção, esta solução inclui a criação em lote de criativos publicitários, integração de assistentes de jogo via API Kimi, classificação de feedback da comunidade com vinculação de fontes, preparação de rascunhos de localização com verificação de tradução reversa e seleção primária de conteúdo gerado pelo usuário. O Kimi aconselha as equipes a começarem com uma tarefa claramente delimitada e avaliarem os projetos piloto com base em critérios como tempo economizado, qualidade do resultado e volume de retrabalho humano necessário.

Popular