Huawei Ascend adiciona suporte ao Kimi K3.1 Pro para Atlas A3 e Ascend 950 SuperPoDs
Leia mais
Pandaily
pandaily.com

Huawei Ascend adiciona suporte ao Kimi K3.1 Pro para Atlas A3 e Ascend 950 SuperPoDs

A equipe de sistemas de computação da Huawei Ascend anunciou a conclusão da adaptação para inferência do modelo Kimi K3.1 Pro, que possui 2,8 trilhões de parâmetros. Os pesos completos deste modelo foram lançados pela Moonshot AI em 4 de novembro, de acordo com a conta oficial da Huawei Computing, conforme relatado pelo IT Home e ifeng Tech.

Usando vLLM Ascend e SGLang, os desenvolvedores agora podem implantar este modelo nos servidores Atlas 800 A3, no cluster Atlas 900 A3 SuperPoD e na série Ascend 950 SuperPoD desde seu lançamento.

O Kimi K3.1 Pro é o primeiro modelo da série K3.1 da Moonshot AI. É um modelo do tipo mixture-of-experts com processamento visual nativo e uma janela de contexto de cerca de um milhão de tokens, ativando aproximadamente 104 bilhões de parâmetros em cada etapa de inferência. O modelo mantém a atenção linear híbrida K3, baseada nas camadas Kimi Delta Attention (KDA), e adiciona camadas de atenção esparsa DSA em vez de algumas camadas de atenção completa para reduzir os custos de modelagem de contexto longo.

Grande parte do trabalho de adaptação estava relacionada especificamente a essa arquitetura. A Huawei declarou que sua equipe de inferência se baseou na adaptação anterior do Kimi K3, analisando previamente o novo modelo e trabalhando paralelamente na integração do modelo, desenvolvimento de operadores e validação de serviços. Graças ao suporte já existente para KDA e MoE, a equipe adicionou um novo caminho de atenção esparsa e inferência multimodal, mantendo as funções de serviço existentes nos frameworks de inferência.

De acordo com informações da Huawei, a otimização abrangeu operadores principais para seleção de histórico, cálculos de atenção esparsa, pré-processamento e cálculos residuais, que foram combinados com cache distribuído e funcionalidades em nível de framework para suportar inferência de contexto longo e manutenção de produção. A empresa estabeleceu como meta que usuários e desenvolvedores pudessem começar a testar aplicativos e implantações no primeiro dia de lançamento do modelo.

A documentação do vLLM Ascend indica que o Kimi K3.1 Pro é suportado em modo experimental na versão vLLM Ascend 0.30.0. Suas configurações de referência utilizam a divisão de prefixo e decodificação em oito nós, com quatro nós de prefixo e quatro nós de decodificação, incluindo a configuração de contexto longo de um milhão de tokens. Os servidores Atlas 800I A3 operam com o checkpoint quantizado W4A8, enquanto os produtos 950DT usam a variante W4A8 MXFP; a liderança observa que os produtos Atlas A2 e 950PR ainda não são suportados.

O tamanho do modelo torna o suporte de hardware uma questão prática. O IT Home observa que os pesos no formato BF16 ocupam cerca de 5,6 TB e ainda exigem cerca de 1,4 TB após a quantização INT4, o que exclui o uso de uma única GPU de consumidor. A Huawei posicionou seus sistemas A3 e 950 SuperPoD para esta classe de inferência MoE com parâmetros trilionários, e o lançamento do Kimi K3.1 Pro foi o último modelo aberto que ela suportou no dia do lançamento.
Histórias semelhantes

Empresa HongYun lança HyperLM V2.5 com suporte para Huawei Ascend 950DT e Atlas 850E SuperPoD
Leia mais
pandaily.com

Empresa HongYun lança HyperLM V2.5 com suporte para Huawei Ascend 950DT e Atlas 850E SuperPoD

A empresa de IA HongYun, sediada em Pequim, apresentou o HyperLM V2.5 — uma nova versão de sua plataforma para treinamento combinado e inferência de grandes modelos. Isso foi relatado pelas publicações IT Home e ifeng Tech em 3 de novembro. A empresa afirma ser a primeira a realizar uma adaptação profunda ao chip Huawei Ascend 950DT, sendo totalmente compatível com o sistema Atlas 850E SuperPoD com resfriamento a ar e tendo passado pela certificação técnica da Huawei para Ascend Native.

A HongYun acredita que a definição de suporte é frequentemente muito vaga, quando um modelo é considerado suportado apenas após a instalação e geração de tokens. O objetivo da empresa é ajudar clientes governamentais e corporativos que utilizam implantações privadas a obter o máximo desempenho dos novos aceleradores.

A empresa descreve o Ascend 950DT como um chip de ponta para tarefas que exigem alta taxa de transferência, como interações prolongadas em chats, processamento de documentos longos e raciocínio contínuo de agentes. Além disso, observa-se que o sistema Atlas 850E com resfriamento a ar pode ser integrado em data centers existentes sem a necessidade de modernizar a infraestrutura.

O HyperLM V2.5 se adapta em vários níveis. No nível de interconexão, a plataforma suporta a tecnologia UnifiedBus 2.0 da Huawei, que fornece uma largura de banda de interconexão do sistema de 13,4 TB/s, prevenindo gargalos na transmissão de tráfego entre placas, o que é importante para contextos longos ou divisão das fases de pré-preenchimento e decodificação. No nível do operador, o sistema é otimizado para inferência mxFP4, permitindo o uso de 14,2 PFLOPS por nó.

A plataforma suporta os modelos de código aberto mais recentes, incluindo Qwen, GLM e DeepSeek, e seu agendador foi reconstruído levando em consideração o perfil de memória e largura de banda do 950DT.

O lançamento do HyperLM V2.5 inclui cinco novos recursos. A divisão de pré-preenchimento e decodificação permite isolar duas fases em pools de recursos independentes para que não entrem em concorrência durante picos de carga. O cache KV multinível reutiliza prompts do sistema, contextos frequentemente encontrados e modelos de sessão fixos para reduzir o volume de cálculos repetidos. A virtualização vNPU segmenta os chips Ascend 950DT, 910C e 910B, fornecendo cotas granulares e isolamento para cálculos AI Core e memória HBM, além de suportar migração a quente e reagendamento automático em caso de falha de hardware.

Também foi adicionado um modelo de gateway unificado, compatível com o protocolo OpenAI, que gerencia roteamento, limitação de taxa, versões beta e testes A/B. O monitoramento abrangente de toda a pilha rastreia carga, uso de memória, largura de banda, latência e QPS, fornecendo alertas e localização automática de falhas.

Para setores regulamentados, como governo, energia, transporte e finanças, a plataforma prevê a separação de funções de administrador, segurança e auditor, controle multinível de classificação e logs operacionais completos, bem como contabilidade de capacidade computacional, auditoria de chamadas de modelos e estatísticas de uso por projeto.

A HongYun foi incubada pelo Instituto Ocidental de Tecnologia Computacional da Academia Chinesa de Ciências, e sua equipe principal é formada por funcionários do Instituto de Tecnologia Computacional e Sugon. Em 2020, a empresa aderiu ao programa de parceria Ascend da Huawei. A empresa planeja continuar o desenvolvimento com base no hardware Ascend e Hygon DCU, focando em agendamento heterogêneo, aceleração de inferência, cache e aplicações de agentes.

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B
Leia mais
pandaily.com

Lenovo lança host de IA Kaitian com processador Zhaoxin KX-7000 e NPU Houmo LQ50 para execução local de modelos de 35B

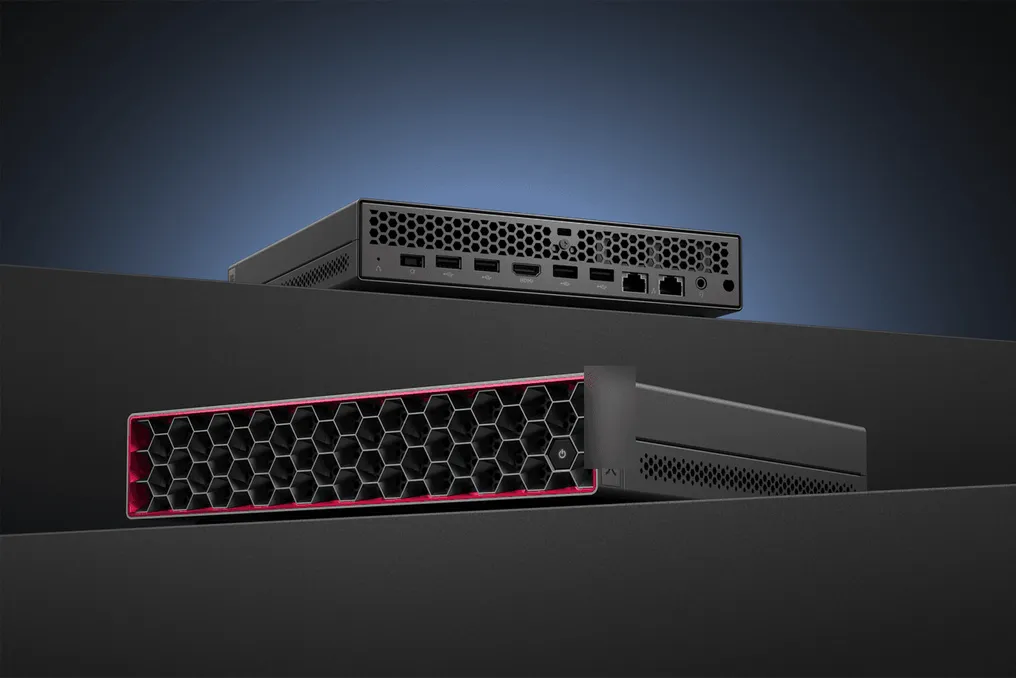
A Lenovo lançou o primeiro sistema host de IA da linha Kaitian, destinado ao mercado chinês de inovação em TI (Xinchuang). Este computador de mesa de 1,6 litros combina o processador Zhaoxin com a NPU de IA da Houmo, permitindo a execução local de modelos com cerca de 35 bilhões de parâmetros.

O dispositivo é equipado com um processador Zhaoxin KX-7000 de oito núcleos e a NPU Houmo Liqing LQ50. Na configuração padrão, o sistema oferece uma capacidade de computação de 160 TOPS no formato INT8, e com a opção NPU, essa capacidade pode atingir 320 TOPS. A NPU possui 24 GB de memória dedicada com largura de banda de 153,6 GB/s. O host opera sob o Kylin OS e vem pré-instalado com o agente Tianxi AI Pro da Lenovo.

A empresa realizou testes do dispositivo usando modelos abertos, incluindo as séries Qwen3.5 e Qwen3.6-35B-A3B. Ao usar os 24 GB da NPU e quantização W4A8, o modelo Qwen3.6-35B-A3B gerou texto a uma velocidade de aproximadamente 28,99 tokens por segundo durante a inferência local. O sistema suporta entrada de dados de até 200.000 tokens para processamento de documentos longos e tarefas multi-turn. A plataforma Houmo fornece aos desenvolvedores ferramentas para perfilagem, compilação, gerenciamento de tempo de execução e quantização de modelos.

A Lenovo posiciona este host como um funcionário digital permanente, projetado para operação 24 horas por dia. Isso permite que os agentes executem tarefas agendadas, como pesquisa de conhecimento local, elaboração de documentos e sumarização de informações, enquanto o processamento das saídas ocorre diretamente no dispositivo, e não através de tokens na nuvem, mantendo os dados localmente. No evento, os testadores do Tianxi AI Pro deram uma instrução para verificar o aplicativo de operadora móvel, e o dispositivo realizou uma chamada de teste, mediu o atraso do código SMS de verificação e forneceu um relatório.

Em relação à dissipação de calor, o processador e a NPU possuem canais de ar separados atrás do painel frontal hexagonal com ventiladores de alta pressão. A Lenovo relata que em marcha lenta, a temperatura da carcaça é de cerca de 33 graus Celsius em uma sala com temperatura de 25 graus, e sob carga total, atinge 41 graus. Em uma sala com temperatura de 35 graus, sob carga total, a temperatura atinge cerca de 46 graus. O nível de ruído é de 19,4 dB em modo de espera e cerca de 29,5 dB durante a inferência total da NPU. O dispositivo pesa cerca de 1,5 kg e é equipado com duas portas independentes de 2,5GbE.

Vale notar que o host Kaitian difere do Lenovo AI Host P7, que foi apresentado em outubro com chips Houmo M50 e CIX P1.

Primeiro cluster SuperPoD em Ascend 950DT com 1024 NPUs lançado em Wuhan em apenas um mês
Leia mais
pandaily.com

Primeiro cluster SuperPoD em Ascend 950DT com 1024 NPUs lançado em Wuhan em apenas um mês

O primeiro cluster computacional construído com SuperPoD e 1024 placas Ascend 950DT da Huawei foi ativado na cidade de Wuhan. O lançamento ocorreu em 28 de outubro na conferência de inteligência artificial da Huawei para a província de Hubei, que fazia parte do Huawei Roadshow 2026 chinês.

Os investimentos neste cluster foram fornecidos pelo Grupo Provincial de Investimentos em Ciência e Tecnologia de Hubei, que é o investidor estatal da província. De acordo com este grupo, a implementação do projeto levou apenas um mês desde o início dos trabalhos até a entrada em operação, o que é um prazo relativamente curto para um sistema desta escala.

A implantação consiste em um SuperPoD unificado com resfriamento líquido. Um nó está equipado com 1024 aceleradores de placa Ascend NPU. Os gabinetes de computação e de interconexão estão totalmente equipados com sistemas de resfriamento líquido. O sistema é capaz de fornecer um desempenho de 1 EFLOPS no formato FP8 e possui 256 TB de memória globalmente unificada. A largura de banda entre as placas atinge o nível de terabytes por segundo, e a latência de comunicação ponta a ponta é de microssegundos.

A arquitetura de design é baseada no UnifiedBus, a arquitetura interna de conexão da Huawei para SuperPoD. Esta tecnologia permite que cada placa no cluster acesse diretamente outras placas, fazendo com que os 1024 NPUs funcionem mais como um único grande acelerador do que como vários servidores individuais conectados através de uma rede padrão. A Huawei posiciona esta instalação para treinamento de modelos com trilhões de parâmetros e para execução de inferências de agentes de IA.

A principal vantagem da abordagem SuperPoD é o acesso direto. Ao treinar grandes modelos, uma parte significativa do tempo é gasta na movimentação de dados entre chips. Manter a memória unificada em todo o pod e dentro dele, com uma arquitetura de interconexão, reduz o volume de tráfego que deve passar por canais mais lentos.

O cluster destina-se a satisfazer as necessidades locais. Ele visa fornecer aos desenvolvedores de modelos e empresas em Hubei uma fonte acessível de poder computacional para treinar grandes modelos, bem como para criar, configurar e operar agentes de IA setoriais. Fontes locais observam que isso preenche uma lacuna no fornecimento de computação de alto desempenho na província.

O lançamento em Wuhan também marca a implementação prática antecipada da geração Ascend 950. Anteriormente este ano, a Huawei demonstrou um SuperPoD físico baseado em Ascend 950 e relatou que mais de 750 conjuntos da geração anterior Ascend 384 SuperPoD já haviam sido implantados comercialmente. O cluster 950DT em Wuhan demonstra a transição da nova construção SuperPoD de equipamento de demonstração para centros regionais de computação de IA.

A Huawei não divulgou dados sobre o consumo de energia do cluster ou métricas detalhadas de utilização; os valores numéricos acima foram apresentados no evento de lançamento.

Popular