GPUWorks lança plataforma de inferência com suporte a Ascend, PPU, Hygon e NVIDIA em um único cluster
Leia mais
Pandaily
pandaily.com

GPUWorks lança plataforma de inferência com suporte a Ascend, PPU, Hygon e NVIDIA em um único cluster

A GPUWorks, uma plataforma corporativa leve para inferência de inteligência artificial, foi lançada com código aberto sob a licença Apache-2.0 em 4 de novembro. A informação foi publicada pelo IT Home. O código está disponível no GitHub na organização FlitAI, permitindo que empresas e desenvolvedores o utilizem, modifiquem ou contribuam com templates de inferência e adaptação de chips.

Esta plataforma unifica aceleradores de diferentes fabricantes e fontes em um pool gerenciado único. Ela realiza o mapeamento de modelos para hardware, avalia os requisitos de memória da GPU e implanta modelos a partir de templates, fornecendo acesso a eles via API compatível com a OpenAI. Entre os chips suportados estão NVIDIA e AMD, além de Huawei Ascend, T-Head PPU e Hygon DCU.

Servidores bare-metal, máquinas virtuais e contêineres em nuvem podem operar em um único cluster, independentemente de estarem em data centers próprios da empresa ou em nuvens privadas ou públicas.

Características e desempenho da plataforma

Os desenvolvedores destacam a natureza compacta da solução: o instalador pesa pouco mais de 40 MB, é instalado com um único comando em cerca de 60 segundos e não requer o uso do Kubernetes. Usuários de rede interna podem baixar o instalador, arquivos de modelo e imagens de tempo de execução offline. O catálogo inclui mais de mil configurações de inicialização para quase 400 modelos, sendo que para cada combinação de modelo e chip, são empacotados a imagem, o motor de inferência, a versão dos pesos e as flags de inicialização.

Um assistente integrado baseado em IA ajuda a diagnosticar falhas, e o planejador explica cada decisão de alocação tomada. De acordo com testes internos da equipe, um servidor GPUWorks conseguiu gerenciar 1003 servidores GPU e iniciar mais de 500 réplicas de inferência em quatro minutos. Nesse processo, atingiu uma saída de 69.000 tokens por segundo, utilizando apenas nove núcleos de CPU e 1,6 GB de memória. O tempo de inicialização do DeepSeek-V4.1-Flash implantado foi de apenas 3,6 segundos.

A função de inicialização permite que vários modelos grandes utilizem alternadamente os mesmos GPUs. O modo de suspensão de primeiro nível mantém os pesos do modelo na memória do host, eliminando a necessidade de reiniciar o motor ou recarregar os pesos do armazenamento. Em um teste com oito placas NVIDIA H20, onde três modelos grandes foram distribuídos pelas oito placas, a inicialização a frio a partir do armazenamento NFS levava de 16 a 17,5 minutos, enquanto a recuperação do serviço após o despertar da memória levou cerca de quatro segundos, representando uma melhoria de aproximadamente 200 vezes. Os administradores têm a opção de configurar políticas de prioridade, liberação em inatividade ou rotação programada.

Para cargas de trabalho mais volumosas, a plataforma suporta paralelismo multi-nó, múltiplas réplicas e separação de pré-processamento e decodificação, permitindo configurar a comunicação de rede RDMA ou canais Ascend HCCS. Também são fornecidos testes de carga integrados para verificar largura de banda e latência antes da escalabilidade. O sistema rastreia o uso de tokens e acertos de cache por cada chave de API, modelo e implantação, bem como horas de placa por milhão de tokens de saída e GPUs não utilizadas. Durante a manutenção de um nó, a plataforma adiciona réplicas antes de desativar as antigas e restaura automaticamente os serviços em outro nó adequado caso a máquina falhe.

Histórias semelhantes

Cluster Wuxi da Moore Threads com 2112 GPUs atinge 92,9% de utilização após início da operação comercial
Leia mais
pandaily.com

Cluster Wuxi da Moore Threads com 2112 GPUs atinge 92,9% de utilização após início da operação comercial

A operação comercial do cluster computacional doméstico, construído com processadores gráficos MTT S5000 da Moore Threads, começou em Wuxi, Jiangsu. De acordo com um relatório da Zhidx de 2 de novembro, este centro iniciou sua primeira fase em junho, passou para modo de teste em julho e começou a prestação de serviços comerciais em outubro.

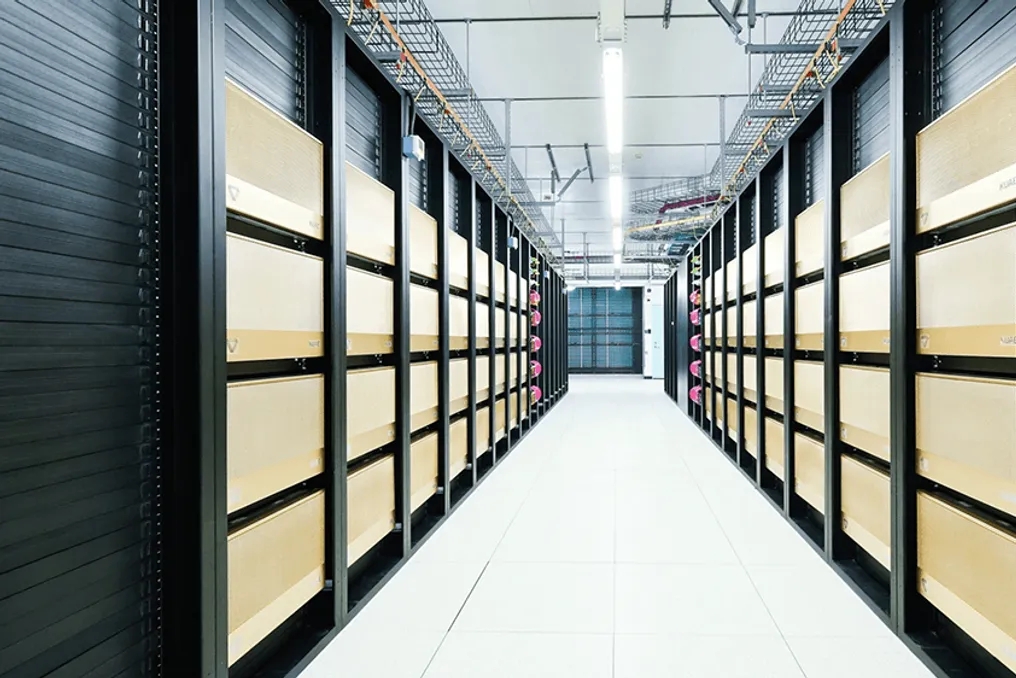
A fase atual do cluster inclui 264 servidores equipados com 2112 placas S5000. Dados fornecidos pela Zhidx mostram que a utilização do cluster atingiu 92,9%. Durante o período de testes, 55 clientes foram envolvidos e 33 modelos foram implementados. Mais de 62% das cargas de trabalho são dedicadas ao treinamento de modelos, enquanto o treinamento misto e a inferência somam 14,7%, e a inferência pura soma 23,1%.

O cluster é estruturado em quatro módulos, cada um contendo cerca de 500 placas, e foi fornecido pronto para uso. Ele atingiu carga total em três meses após o lançamento. O sistema suporta mais de 30 famílias de modelos, incluindo Qwen, GLM, DeepSeek, Kimi e MiniMax.

Em testes de inferência usando um pool S5000 e o modelo DeepSeek V4 Flash com 7 mil tokens de entrada e 2 mil tokens de saída, foi registrada uma taxa de transferência de uma máquina de 994,97 tokens por segundo e uma inferência eficiente de 1241 tokens por segundo. O sistema lidou com 48 solicitações simultâneas dentro do nível de serviço alvo, estabelecido no relatório em 92% da configuração H800 em teste semelhante. É importante notar que esses indicadores foram apresentados pelos operadores do cluster e não passaram por verificação independente.

O cluster também oferece uma opção de implantação mista, que combina as placas S5000 com outros aceleradores através da desagregação de pré-carregamento e decodificação. Em uma das configurações mencionadas no relatório, três placas S5000 combinadas com duas placas H20 forneceram uma taxa de transferência comparável a nove placas H20, o que é aproximadamente 1,87 vezes superior ao nível base, reduzindo simultaneamente o tempo até o primeiro token em cerca de metade.

O fabricante de veículos autônomos Neolix planeja realizar o treinamento para seus modelos de direção autônoma neste local, com a demanda se aproximando do nível de 10.000 placas, o que é aproximadamente cinco vezes maior do que o número atual de placas no cluster. Anteriormente, a Moore Threads declarou que seu cluster baseado em S5000 com 10.000 placas fornece uma capacidade de computação de 10 EFLOPS com 90% de tempo de treinamento eficiente e 95% de eficiência de escalonamento linear. A expansão em Wuxi será realizada em fases, e o relatório menciona que a Moore Threads também colabora com a JD Cloud na criação de um cluster de 100.000 placas.

O local em Jiangsu faz parte de um número crescente de centros de computação regionais na China construídos com aceleradores domésticos, à medida que os operadores passam de instalações de demonstração para clusters que atendem desenvolvedores de modelos e empresas de robótica em grande escala.

Moore Threads lança Megatron-MUSA-Titan para treinar modelos MoE com um trilhão de parâmetros em GPUs próprias
Leia mais
pandaily.com

Moore Threads lança Megatron-MUSA-Titan para treinar modelos MoE com um trilhão de parâmetros em GPUs próprias

A empresa Moore Threads tornou o projeto Megatron-MUSA-Titan público, apresentando uma infraestrutura para treinamento de grandes modelos que ela desenvolveu para uso em suas próprias unidades de processamento gráfico. Este projeto é destinado ao trabalho com modelos do tipo 'mistura de especialistas' (mixture-of-experts) com um trilhão de parâmetros em clusters compostos por mais de 10.000 GPUs da Moore Threads, abrangendo tanto o pré-treinamento quanto o treinamento por reforço.

O código do projeto está disponível no GitHub. A empresa afirma que este sistema foi usado continuamente para pré-treinar MoE com um trilhão de parâmetros em clusters de 10.000 GPUs, onde sessões de treinamento prolongadas garantiram alta utilização de FLOPs do modelo e estabilidade do processo.

O repositório apresenta um exemplo de configuração para um modelo MoE no estilo Kimi-K2 com 1 trilhão de parâmetros. O princípio central do design foi manter a proximidade com soluções existentes. O Megatron-MUSA-Titan é construído sobre o framework Megatron-LM da NVIDIA. Graças à integração do PyTorch via torch_musa e à compatibilidade MUSA C com CUDA C, os desenvolvedores que possuem o ambiente MUSA podem clonar os repositórios oficiais Megatron-LM, slime e miles e iniciar o treinamento nas GPUs Moore Threads sem a necessidade de modificar o código-fonte.

O projeto indica que algoritmos gerais e correções de erros devem ser direcionados aos projetos superiores, enquanto a Moore Threads se concentra em dois tipos de alterações: otimizações em larga escala adaptadas ao hardware e clusters da Moore Threads, e soluções alternativas para problemas específicos do MUSA.

Os recursos de pré-treinamento incluem treinamento em bloco no formato FP8, que depende do MT-TransformerEngine da Moore Threads. A roteamento e agregação de tokens MoE são acelerados com o DeepEP, que opera sobre o Async Copy Engine da empresa, permitindo também a comunicação dos especialistas em paralelo com os cálculos. Outras opções incluem o descarregamento de ativações usando paralelismo de pipeline virtual e o agendamento de uma passagem direta e uma passagem reversa, além da comunicação paralela de pipeline combinada com cálculos, graças ao Mooncake RDMA.

A ferramenta de análise de rastreamento distribuído lê os rastreamentos PyTorch de cada GPU para detectar gargalos, como bolhas de pipeline e nós de baixo desempenho. O projeto afirma ser capaz de analisar uma execução de MoE com 1 trilhão de parâmetros em 10.000 GPUs em apenas algumas horas.

Para o treinamento por reforço, o stack suporta os frameworks slime e miles; o Megatron cuida do treinamento, e a compilação MUSA-SGLang gera as passagens, permitindo que um único sistema base atenda tanto ao pré-treinamento quanto ao RL. A otimização para inferência autônoma não faz parte do escopo deste projeto.

Para desenvolvedores que consideram aceleradores domésticos, a questão prática é qual parte do código de treinamento existente permanecerá funcional. A resposta da Moore Threads é que o código do ecossistema Megatron não requer modificações.

Iluvatar CoreX demonstra o funcionamento do GPU Tiangai 300, alegando desempenho superior ao H200 em 1,05x
Leia mais
pandaily.com

Iluvatar CoreX demonstra o funcionamento do GPU Tiangai 300, alegando desempenho superior ao H200 em 1,05x

A empresa Iluvatar CoreX, durante seu dia de mídia realizado em 28 de outubro em Xangai, apresentou pela primeira vez o processador gráfico de propósito geral Tiangai 300 em funcionamento em hardware real. Até então, os materiais públicos da empresa sobre o chip focaram exclusivamente na arquitetura e no roteiro, e não em sistemas operacionais.

A principal declaração é uma comparação de desempenho. A Iluvatar CoreX afirma que o Tiangai 300 se tornou o primeiro GPU de propósito geral doméstico com desempenho medido que atinge o nível do NVIDIA H200. Além disso, testes de terceiros, após conversão de dados, mostraram que a largura de banda total de um único cartão é 1,05 vezes maior do que a do H200. É importante notar que a empresa não divulgou a metodologia de teste, os modelos utilizados ou as condições de carga de trabalho, portanto, este resultado ainda não pode ser verificado independentemente.

Este chip é destinado à implementação no supernó IXL144, apresentado anteriormente pela empresa na Feira Internacional Industrial da China. Um telhado IXL144 combina 144 GPUs, 18 CPUs e cerca de 10,1 TB de memória GPU, o que a Iluvatar CoreX chama de supernó GPU mais denso do setor. Segundo suas próprias estimativas, essa configuração reduz o custo em um milhão de tokens eficientes em 40% em comparação com soluções internacionais principais.

No dia aberto, também foram apresentadas informações sobre implantação heterogênea. A Iluvatar CoreX informou que implementou o primeiro esquema doméstico de desagregação AFD entre GPU e XPU, o que permitiu reduzir a latência de inferência em 60%. A desagregação AFD geralmente implica a divisão das etapas de cálculo do modelo, como camadas de atenção e propagação direta, entre diferentes tipos de processadores, para que cada um execute o trabalho no qual é mais eficiente.

Quanto aos dispositivos periféricos, a empresa declarou que seu chip Tongyang TY1200 supera o NVIDIA Thor T5000 em testes realizados, novamente sem publicar detalhes. O TY1200, que foi anunciado anteriormente com 300 TOPS de computação densa para PCs de IA e inteligência incorporada, também foi nomeado como o primeiro produto periférico doméstico capaz de realizar simulação física com aceleração de GPU baseada em MuJoCo-Warp — uma função crítica para o treinamento de robôs em simulação.

Em geral, essas demonstrações levam a linha de produtos de próxima geração da Iluvatar CoreX do campo das especificações em papel para sistemas operacionais. O próximo ponto a ser observado serão os benchmarks independentes com cargas de trabalho divulgadas.

Popular