Moonshot AI apresenta solução para desenvolvimento de jogos com agentes K3.1 em Unity, Unreal e Blender
Leia mais
Pandaily
pandaily.com

Moonshot AI apresenta solução para desenvolvimento de jogos com agentes K3.1 em Unity, Unreal e Blender

A Moonshot AI lançou uma solução abrangente para criação de jogos e trabalhos criativos, baseada na série de modelos Kimi K3.1, produtos Kimi Code e Kimi Work, além de plugins para ferramentas profissionais, incluindo Unity, Unreal Engine e Blender.

De acordo com o comunicado da empresa, este pacote visa ajudar os estúdios a testar conceitos de jogos mais rapidamente, impulsionar a produção de engenharia e arte, e integrar feedback dos jogadores obtido durante o lançamento e operação de volta à próxima fase de desenvolvimento.

Na descrição, o modelo Kimi é capaz de analisar documentos de design, capturas de tela, código-fonte e ativos 3D, planejando então o trabalho necessário. O produto Kimi Code lida com a implementação de alterações dentro da base de código existente, enquanto o Kimi Work assume tarefas de produção multifásicas que abrangem vários arquivos.

Graças aos plugins e chamadas de ferramentas, o Kimi pode trabalhar diretamente com projetos existentes, retornando ao usuário arquivos editáveis juntamente com um relatório das ações executadas. Nos ambientes Unity e Unreal Engine, após obter as permissões necessárias e os arquivos do projeto, o sistema primeiro mapeia a estrutura do código, a hierarquia das cenas e as dependências dos módulos, em seguida, insere alterações através dos plugins do editor e, por fim, verifica o resultado através de passos de reprodução, logs e dados de tempo de execução. Para os engenheiros, são mantidos relatórios de diferenças no código e registros de verificação.

Para operar no Unity, os modelos Kimi utilizam o agente Tuanjie Codely Agent, que é um agente de jogo da Unity China e está integrado ao Tuanjie Engine. O Kimi interpreta as intenções do desenvolvedor, escreve código e analisa os resultados de testes e gravações de tela, enquanto o agente Codely executa operações dentro do motor por meio de scripts do editor e tempo de execução. Durante uma demonstração, o Kimi demonstrou ser capaz de operar por 20 horas sem intervenção humana, recriando um jogo existente e criando um projeto nativo que pode ser desenvolvido posteriormente.

Na página de lançamento, há várias compilações de demonstração criadas com o Kimi K3.1 Pro. No Blender, foi construído um vale interior da selva e renderizado um voo de 17,5 segundos em resolução 1920x1080 a 60 quadros por segundo, bem como o interior de uma catedral no navegador, contendo cerca de 3,3 milhões de triângulos e 8368 componentes animados. No Unreal Engine 5.8, foi criada uma cena de palácio celestial com uma colunata de 36 arcos em um raio de 1750 metros e um dragão modelado proceduralmente, totalizando 36 milhões de triângulos, renderizado usando Nanite e Lumen. O Kimi também afirma que designers sem experiência em programação podem criar protótipos jogáveis no Godot em um ou dois dias.

Além das tarefas de produção, esta solução inclui a criação em lote de criativos publicitários, integração de assistentes de jogo via API Kimi, classificação de feedback da comunidade com vinculação de fontes, preparação de rascunhos de localização com verificação de tradução reversa e seleção primária de conteúdo gerado pelo usuário. O Kimi aconselha as equipes a começarem com uma tarefa claramente delimitada e avaliarem os projetos piloto com base em critérios como tempo economizado, qualidade do resultado e volume de retrabalho humano necessário.
Histórias semelhantes

Doubao Work oferece acesso aos modelos Kimi, GLM e DeepSeek para clientes corporativos
Leia mais
pandaily.com

Doubao Work oferece acesso aos modelos Kimi, GLM e DeepSeek para clientes corporativos

O Doubao Work, um aplicativo agente de inteligência artificial da ByteDance, anunciou em 29 de outubro a expansão de suas funcionalidades, fornecendo acesso a modelos de terceiros para clientes empresariais. O primeiro grupo de modelos integrados inclui Kimi K3.1 Pro da Moonshot AI, GLM-5.3 da Zhipu e DeepSeek-V4.1-Flash. Esses modelos agora aparecem na lista de modelos do aplicativo ao lado dos próprios modelos Doubao da ByteDance.

Esta atualização se aplica aos planos de equipe e empresa e é ativada por padrão. As empresas não precisam adquirir permissões separadas de cada desenvolvedor de modelo ou enviar pedidos separados. O consumo de recursos é deduzido dos créditos de IA que a organização já possui no Doubao Work.

Gerenciamento de Acesso a Modelos

Os administradores ganham a capacidade de controlar quais usuários podem usar determinado modelo. Eles podem conceder acesso a membros individuais, departamentos, grupos ou à empresa inteira. Além disso, os administradores podem ativar todos os modelos de um provedor simultaneamente ou configurar o uso de um modelo específico.

Este passo muda o posicionamento do Doubao Work. Anteriormente, o aplicativo servia principalmente como uma demonstração dos modelos Doubao da ByteDance dentro de um agente capaz de operar com arquivos, navegadores e aplicativos de desktop. Ao permitir que as empresas direcionem tarefas a modelos chineses concorrentes, o produto principal torna-se o próprio agente, e não o modelo subjacente. Isso também permite que as equipes escolham o modelo dependendo do tipo de tarefa, por exemplo, usar um modelo focado em codificação para trabalhos de engenharia e outro modelo para trabalhar com documentos longos.

Este movimento está alinhado com uma tendência mais ampla entre produtos de agentes de desktop chineses. Nesta semana, a Xiaomi adicionou os modelos DeepSeek, GLM, Kimi e Qwen ao seu MiMo Desktop, e vários outros ferramentas-agentes deram passos semelhantes. Para compradores de nível corporativo, uma conta unificada e um sistema de permissões unificado para vários desenvolvedores de modelos simplificam significativamente o processo de compra, que anteriormente exigia a comparação de soluções de diferentes fabricantes.

O Doubao Work continua a expandir seu conjunto de recursos. Nas últimas semanas, foram adicionadas funcionalidades para salvar ações de computador gravadas como habilidades reutilizáveis, importar histórico de chat, habilidades e memória de outras ferramentas de IA com um clique, bem como um campo infinito para criatividade. O aplicativo também suporta agentes paralelos e controle local da interface gráfica no Mac.

A ByteDance não especificou quais outros modelos de terceiros seguirão após o primeiro lote, descrevendo a composição atual como o primeiro grupo de modelos que se juntaram à plataforma.

Hoorakhsh Studios inicia a produção da série animada 'Shahnameh'
Leia mais
www.tehrantimes.com

Hoorakhsh Studios inicia a produção da série animada 'Shahnameh'

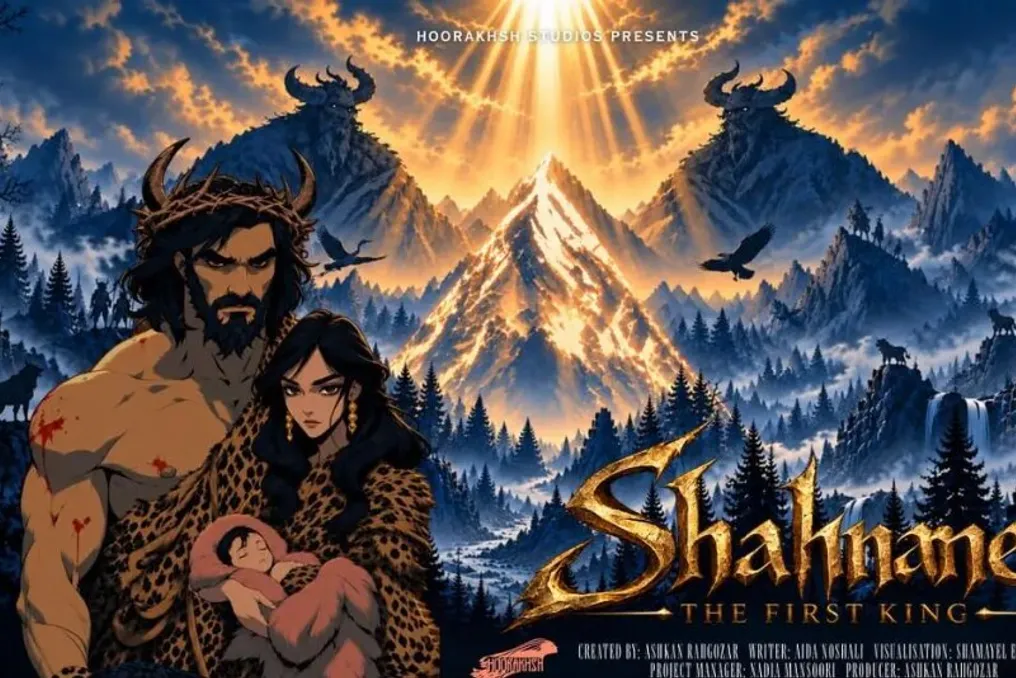
O estúdio Hoorakhsh Studios iniciou a produção da série animada 'Shahnameh', que é supervisionada e criada por Ashkan Raggozar. Métodos de animação 2D e inteligência artificial são utilizados na criação da série.

Após o lançamento do longa-metragem de animação 'A Última Ficção' e a escrita de sete romances gráficos baseados nos enredos de 'Shahnameh', Ashkan Raggozar voltou-se novamente para este épico de Ferdowsi, informou a agência ILNA.

Planeja-se que a série adapte todas as histórias de 'Shahnameh' de Ferdowsi do início ao fim, e seu lançamento e transmissão ocorrerão simultaneamente ao longo de aproximadamente dez anos.

A série animada 'Shahnameh' será produzida em persa e inglês, considerando os interesses das plataformas de streaming internacionais. Cada temporada terá de 8 a 12 episódios, e a duração de cada episódio é estimada em 15 a 20 minutos.

A primeira temporada, intitulada 'O Primeiro Rei', narra o reinado de Kayumars, uma figura lendária da história mitológica iraniana mencionada tanto no Avesta quanto em 'Shahnameh'. 'Shahnameh' é a primeira série animada independente de grande porte do estúdio Hoorakhsh Studio. O portfólio do estúdio inclui dois longas-metragens de animação, mais de 11 animações curtas, mais de 10 clipes musicais, a publicação de 11 romances gráficos e o desenvolvimento de cinco videogames.

'Shahnameh' (Livro dos Reis) é um vasto poema épico escrito pelo poeta persa Ferdowsi aproximadamente entre 977 e 1010 d.C. É o épico nacional do Grande Império Iraniano. Composto por cerca de 50.000 distiques (dísticos), 'Shahnameh' está entre as obras épicas mais longas do mundo e é o épico mais longo criado por um único autor. Descreve predominantemente o passado mítico, mas parcialmente histórico, do Irã, desde a criação do mundo até a conquista muçulmana no século VII.

Este épico nacional é celebrado no Irã, Afeganistão, Azerbaijão, Tajiquistão, bem como em regiões influenciadas pela cultura persa, como Armênia, Daguestão, Geórgia, Turquia, Turcomenistão e Uzbequistão. Ferdowsi dedicou 33 anos para completar 'Shahnameh' em sua totalidade. A obra tem um enorme significado para a cultura e língua persa, sendo considerada uma obra-prima literária e um trabalho definidor da identidade cultural étnico-nacional do Irã. Ferdowsi (940–1025) é reverenciado como uma das figuras mais influentes da literatura persa e um dos maiores nomes na história da literatura.

Infinigence AI desenvolveu um agente de personagem de três componentes, reduzindo o tempo de geração do primeiro token pela metade com saída dividida
Leia mais
pandaily.com

Infinigence AI desenvolveu um agente de personagem de três componentes, reduzindo o tempo de geração do primeiro token pela metade com saída dividida

A Infinigence AI, em colaboração com a Three-Body Universe, desenvolvedora da franquia de Liu Cixin 'Três Corpos', apresentou um agente de personagem no evento 'Dia Três Corpos' em Pequim, em 25 de outubro de 2026. O nome chinês deste agente corresponde ao conceito de Sophon dos romances e ele atua como administrador de mini-universos dos livros.

A apresentação foi realizada pelo CEO da Infinigence, Xia Lixue, e pelo CEO da Three-Body Universe, Zhao Jilong, de acordo com relatórios da QbitAI e Zhidx. Segundo o artigo da QbitAI, as informações foram fornecidas pela própria Infinigence.

Um aspecto interessante é o processo de criação e manutenção desse agente. Ele funciona na plataforma AgentWorks da Infinigence. O material de origem é carregado em bases de conhecimento agrupadas, que são automaticamente processadas, divididas em partes (chunked) e convertidas em embeddings. A personalidade do personagem é definida por meio de solicitações estruturadas multinível, e não por uma única instrução longa.

Um módulo de memória chamado Infini Memory permite que o agente retenha fatos entre sessões, prevenindo memórias contraditórias ou fragmentadas. As respostas passam por um ciclo envolvendo vários agentes: primeiro, uma resposta é gerada, depois ela é avaliada, e apenas as partes malsucedidas são refinadas. A geração de personalidade e a busca de conhecimento são executadas em paralelo para economizar tempo, e um agente revisor separado verifica cada resposta quanto a desvios do caráter e inconsistências com o cenário dos romances.

Para testes, a Infinigence criou um sistema de avaliação baseado em rastreamento, que compara automaticamente os resultados com o texto original, enquanto a equipe de conteúdo da Three-Body Universe verifica manualmente os dados obtidos.

Conquistas da infraestrutura da Infinigence em serviços

Na área de serviços, a infraestrutura da Infinigence desempenha um papel fundamental. Normalmente, a saída de grandes modelos é dividida em uma fase de pré-processamento (prefill), que lê a solicitação, e uma fase de decodificação (decode), que forma a resposta. A arquitetura heterogênea intercluster proprietária da Infinigence, chamada PDD, vai além, dividindo essa cadeia de duas etapas em uma estrutura desagregada de três etapas, que eles marcam como P-RLD-MD, distribuída por clusters separados.

Como o tráfego de agentes frequentemente reutiliza os mesmos prefixos de solicitação, o lado da decodificação aplica o cache de prefixos RadixCache. Isso garante que o contexto geral, como a personalidade, não seja transmitido nem recalculado a cada chamada. A empresa afirma que isso reduz o volume de dados KV transferidos entre clusters em dez vezes, permitindo o uso de Ethernet comum, diminuindo o tempo até o primeiro token em 51,5% e reduzindo o custo por token em 37,5%.

Para um personagem de chat com personalidade fixa e longa e um grande número de usuários constantes, a economia nos prefixos comuns constitui a maior parte dos custos.

Popular