Cluster Wuxi da Moore Threads com 2112 GPUs atinge 92,9% de utilização após início da operação comercial
Leia mais
Pandaily
pandaily.com

Cluster Wuxi da Moore Threads com 2112 GPUs atinge 92,9% de utilização após início da operação comercial

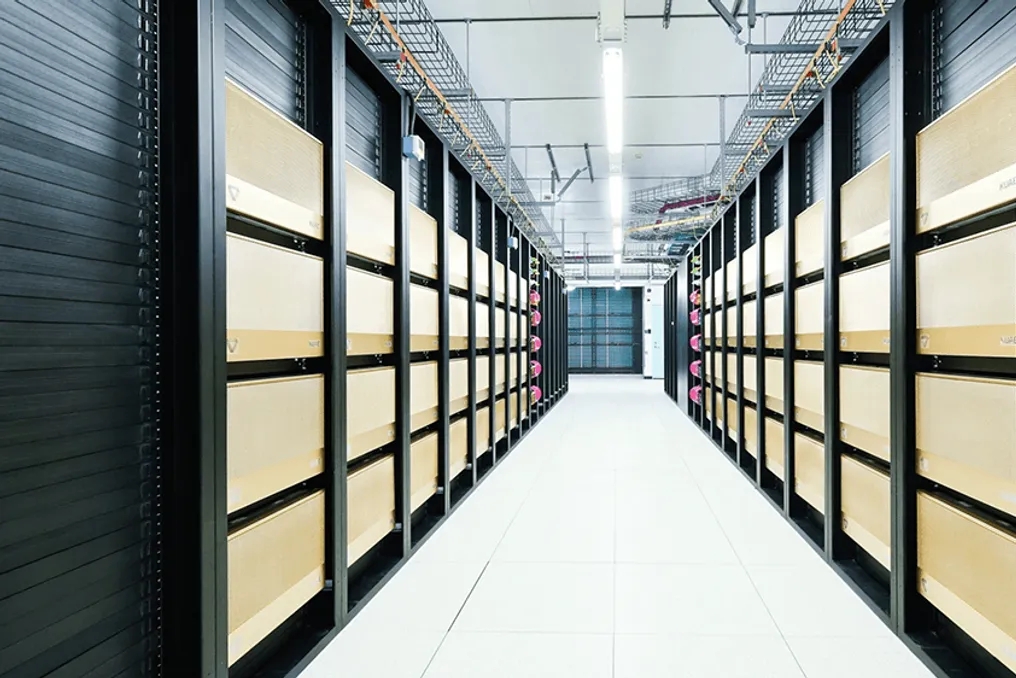
A operação comercial do cluster computacional doméstico, construído com processadores gráficos MTT S5000 da Moore Threads, começou em Wuxi, Jiangsu. De acordo com um relatório da Zhidx de 2 de novembro, este centro iniciou sua primeira fase em junho, passou para modo de teste em julho e começou a prestação de serviços comerciais em outubro.

A fase atual do cluster inclui 264 servidores equipados com 2112 placas S5000. Dados fornecidos pela Zhidx mostram que a utilização do cluster atingiu 92,9%. Durante o período de testes, 55 clientes foram envolvidos e 33 modelos foram implementados. Mais de 62% das cargas de trabalho são dedicadas ao treinamento de modelos, enquanto o treinamento misto e a inferência somam 14,7%, e a inferência pura soma 23,1%.

O cluster é estruturado em quatro módulos, cada um contendo cerca de 500 placas, e foi fornecido pronto para uso. Ele atingiu carga total em três meses após o lançamento. O sistema suporta mais de 30 famílias de modelos, incluindo Qwen, GLM, DeepSeek, Kimi e MiniMax.

Em testes de inferência usando um pool S5000 e o modelo DeepSeek V4 Flash com 7 mil tokens de entrada e 2 mil tokens de saída, foi registrada uma taxa de transferência de uma máquina de 994,97 tokens por segundo e uma inferência eficiente de 1241 tokens por segundo. O sistema lidou com 48 solicitações simultâneas dentro do nível de serviço alvo, estabelecido no relatório em 92% da configuração H800 em teste semelhante. É importante notar que esses indicadores foram apresentados pelos operadores do cluster e não passaram por verificação independente.

O cluster também oferece uma opção de implantação mista, que combina as placas S5000 com outros aceleradores através da desagregação de pré-carregamento e decodificação. Em uma das configurações mencionadas no relatório, três placas S5000 combinadas com duas placas H20 forneceram uma taxa de transferência comparável a nove placas H20, o que é aproximadamente 1,87 vezes superior ao nível base, reduzindo simultaneamente o tempo até o primeiro token em cerca de metade.

O fabricante de veículos autônomos Neolix planeja realizar o treinamento para seus modelos de direção autônoma neste local, com a demanda se aproximando do nível de 10.000 placas, o que é aproximadamente cinco vezes maior do que o número atual de placas no cluster. Anteriormente, a Moore Threads declarou que seu cluster baseado em S5000 com 10.000 placas fornece uma capacidade de computação de 10 EFLOPS com 90% de tempo de treinamento eficiente e 95% de eficiência de escalonamento linear. A expansão em Wuxi será realizada em fases, e o relatório menciona que a Moore Threads também colabora com a JD Cloud na criação de um cluster de 100.000 placas.

O local em Jiangsu faz parte de um número crescente de centros de computação regionais na China construídos com aceleradores domésticos, à medida que os operadores passam de instalações de demonstração para clusters que atendem desenvolvedores de modelos e empresas de robótica em grande escala.

Histórias semelhantes

Primeiro cluster SuperPoD em Ascend 950DT com 1024 NPUs lançado em Wuhan em apenas um mês
Leia mais
pandaily.com

Primeiro cluster SuperPoD em Ascend 950DT com 1024 NPUs lançado em Wuhan em apenas um mês

O primeiro cluster computacional construído com SuperPoD e 1024 placas Ascend 950DT da Huawei foi ativado na cidade de Wuhan. O lançamento ocorreu em 28 de outubro na conferência de inteligência artificial da Huawei para a província de Hubei, que fazia parte do Huawei Roadshow 2026 chinês.

Os investimentos neste cluster foram fornecidos pelo Grupo Provincial de Investimentos em Ciência e Tecnologia de Hubei, que é o investidor estatal da província. De acordo com este grupo, a implementação do projeto levou apenas um mês desde o início dos trabalhos até a entrada em operação, o que é um prazo relativamente curto para um sistema desta escala.

A implantação consiste em um SuperPoD unificado com resfriamento líquido. Um nó está equipado com 1024 aceleradores de placa Ascend NPU. Os gabinetes de computação e de interconexão estão totalmente equipados com sistemas de resfriamento líquido. O sistema é capaz de fornecer um desempenho de 1 EFLOPS no formato FP8 e possui 256 TB de memória globalmente unificada. A largura de banda entre as placas atinge o nível de terabytes por segundo, e a latência de comunicação ponta a ponta é de microssegundos.

A arquitetura de design é baseada no UnifiedBus, a arquitetura interna de conexão da Huawei para SuperPoD. Esta tecnologia permite que cada placa no cluster acesse diretamente outras placas, fazendo com que os 1024 NPUs funcionem mais como um único grande acelerador do que como vários servidores individuais conectados através de uma rede padrão. A Huawei posiciona esta instalação para treinamento de modelos com trilhões de parâmetros e para execução de inferências de agentes de IA.

A principal vantagem da abordagem SuperPoD é o acesso direto. Ao treinar grandes modelos, uma parte significativa do tempo é gasta na movimentação de dados entre chips. Manter a memória unificada em todo o pod e dentro dele, com uma arquitetura de interconexão, reduz o volume de tráfego que deve passar por canais mais lentos.

O cluster destina-se a satisfazer as necessidades locais. Ele visa fornecer aos desenvolvedores de modelos e empresas em Hubei uma fonte acessível de poder computacional para treinar grandes modelos, bem como para criar, configurar e operar agentes de IA setoriais. Fontes locais observam que isso preenche uma lacuna no fornecimento de computação de alto desempenho na província.

O lançamento em Wuhan também marca a implementação prática antecipada da geração Ascend 950. Anteriormente este ano, a Huawei demonstrou um SuperPoD físico baseado em Ascend 950 e relatou que mais de 750 conjuntos da geração anterior Ascend 384 SuperPoD já haviam sido implantados comercialmente. O cluster 950DT em Wuhan demonstra a transição da nova construção SuperPoD de equipamento de demonstração para centros regionais de computação de IA.

A Huawei não divulgou dados sobre o consumo de energia do cluster ou métricas detalhadas de utilização; os valores numéricos acima foram apresentados no evento de lançamento.

Moore Threads lança Megatron-MUSA-Titan para treinar modelos MoE com um trilhão de parâmetros em GPUs próprias
Leia mais
pandaily.com

Moore Threads lança Megatron-MUSA-Titan para treinar modelos MoE com um trilhão de parâmetros em GPUs próprias

A empresa Moore Threads tornou o projeto Megatron-MUSA-Titan público, apresentando uma infraestrutura para treinamento de grandes modelos que ela desenvolveu para uso em suas próprias unidades de processamento gráfico. Este projeto é destinado ao trabalho com modelos do tipo 'mistura de especialistas' (mixture-of-experts) com um trilhão de parâmetros em clusters compostos por mais de 10.000 GPUs da Moore Threads, abrangendo tanto o pré-treinamento quanto o treinamento por reforço.

O código do projeto está disponível no GitHub. A empresa afirma que este sistema foi usado continuamente para pré-treinar MoE com um trilhão de parâmetros em clusters de 10.000 GPUs, onde sessões de treinamento prolongadas garantiram alta utilização de FLOPs do modelo e estabilidade do processo.

O repositório apresenta um exemplo de configuração para um modelo MoE no estilo Kimi-K2 com 1 trilhão de parâmetros. O princípio central do design foi manter a proximidade com soluções existentes. O Megatron-MUSA-Titan é construído sobre o framework Megatron-LM da NVIDIA. Graças à integração do PyTorch via torch_musa e à compatibilidade MUSA C com CUDA C, os desenvolvedores que possuem o ambiente MUSA podem clonar os repositórios oficiais Megatron-LM, slime e miles e iniciar o treinamento nas GPUs Moore Threads sem a necessidade de modificar o código-fonte.

O projeto indica que algoritmos gerais e correções de erros devem ser direcionados aos projetos superiores, enquanto a Moore Threads se concentra em dois tipos de alterações: otimizações em larga escala adaptadas ao hardware e clusters da Moore Threads, e soluções alternativas para problemas específicos do MUSA.

Os recursos de pré-treinamento incluem treinamento em bloco no formato FP8, que depende do MT-TransformerEngine da Moore Threads. A roteamento e agregação de tokens MoE são acelerados com o DeepEP, que opera sobre o Async Copy Engine da empresa, permitindo também a comunicação dos especialistas em paralelo com os cálculos. Outras opções incluem o descarregamento de ativações usando paralelismo de pipeline virtual e o agendamento de uma passagem direta e uma passagem reversa, além da comunicação paralela de pipeline combinada com cálculos, graças ao Mooncake RDMA.

A ferramenta de análise de rastreamento distribuído lê os rastreamentos PyTorch de cada GPU para detectar gargalos, como bolhas de pipeline e nós de baixo desempenho. O projeto afirma ser capaz de analisar uma execução de MoE com 1 trilhão de parâmetros em 10.000 GPUs em apenas algumas horas.

Para o treinamento por reforço, o stack suporta os frameworks slime e miles; o Megatron cuida do treinamento, e a compilação MUSA-SGLang gera as passagens, permitindo que um único sistema base atenda tanto ao pré-treinamento quanto ao RL. A otimização para inferência autônoma não faz parte do escopo deste projeto.

Para desenvolvedores que consideram aceleradores domésticos, a questão prática é qual parte do código de treinamento existente permanecerá funcional. A resposta da Moore Threads é que o código do ecossistema Megatron não requer modificações.

SpacemiT apresenta processador de servidor V100 com arquitetura RISC-V, suporte a Kunlunxin M100 e Linux
Leia mais
pandaily.com

SpacemiT apresenta processador de servidor V100 com arquitetura RISC-V, suporte a Kunlunxin M100 e Linux

A SpacemiT não desenvolveu seu próprio processador de servidor V100. No Summit RISC-V na China, realizado em Shenzhen em 19 de outubro, a empresa apresentou, em conjunto com a equipe do processador de código aberto XiangShan, três servidores prontos construídos em torno deste chip. Esses sistemas são acompanhados pela validação de aceleradores e suporte a sistemas operacionais, visando a implementação de máquinas baseadas em RISC-V em data centers.

Os três dispositivos apresentados incluem o servidor de computação C2201, o servidor de IA G5201 e o servidor de armazenamento S5236. Eles são projetados para resolver tarefas de propósito geral, acelerar inteligência artificial e armazenamento de dados em larga escala. O servidor G5201 é equipado com oito placas aceleradoras de tamanho completo e comprimento total com largura dupla, além de suportar uma rede de cluster RDMA de alta velocidade. A SpacemiT confirma que o chip foi testado usando aceleradores domésticos, incluindo o M100 da Kunlunxin.

Além disso, a empresa oferece aos parceiros placas-mãe para servidores, firmware, gerenciamento BMC e designs de referência de hardware, permitindo a criação de máquinas com marca própria sem a necessidade de desenvolver a placa do zero.

Grande atenção foi dada ao software. A SpacemiT afirma que o V100 implementa cinco especificações de soluções de servidor RISC-V em silício, firmware e sistema operacional: RVA23, Server SoC, Server Platform, Boot and Runtime Services (BRS) e modelo de segurança. A empresa relata o sucesso em todos os testes BRS. Graças a isso, sistemas operacionais como openEuler, openRuyi, openKylin, Debian, Ubuntu, Fedora, Red Hat e Rocky Linux podem ser instalados, inicializados e executados diretamente.

Para ambientes de nuvem com múltiplos locatários, o V100 suporta as extensões RISC-V H, AIA e IOMMU, garantindo virtualização de CPU, memória, interrupções e E/S em nível de hardware. A SpacemiT observa que essas extensões de virtualização já possuem suporte nativo no Linux, portanto, não é necessário criar um kernel personalizado. O chip também inclui uma raiz de confiança de hardware, um ambiente nativo de execução confiável RISC-V e suporte a RERI RAS. A empresa promove o conceito de micro-VMs leves no V100 como uma forma de isolar cargas de trabalho de IA na nuvem com sobrecarga mínima, próxima à de contêineres.

O próprio chip utiliza uma configuração híbrida de 46 núcleos, incluindo seis núcleos XiangShan Kunminghu V2R2 e 40 núcleos SpacemiT X100, operando em frequência de até 2,4 GHz. Dois desses chips podem ser conectados coerentemente para alcançar um desempenho total de até 92 núcleos. Cada chip suporta oito canais DDR5 e 52 linhas PCIe 5.0. O XiangShan é supervisionado pelo Instituto de Tecnologia Computacional da Academia Chinesa de Ciências.

A SpacemiT posiciona o V100 como o primeiro chip universal totalmente compatível com as especificações de soluções de servidor RISC-V. O fundador e CEO Chen Zhijian declarou que este chip marca a transição da empresa do desenvolvimento de dispositivos para tecnologias de nuvem. Vale ressaltar que todas as características e conformidades declaradas provêm da SpacemiT.

Popular