SenseTime lança modelo de inteligência artificial com 9 bilhões de parâmetros que utiliza reutilização de camadas para processamento aprofundado
Leia mais
TechNode
technode.com

SenseTime lança modelo de inteligência artificial com 9 bilhões de parâmetros que utiliza reutilização de camadas para processamento aprofundado

A SenseTime apresentou o SenseNova Loop-9B-Preview, um modelo multimodal disponível publicamente. Este modelo utiliza um método de recálculo para aumentar a profundidade do processamento sem a necessidade de duplicar os pesos correspondentes do modelo. O anúncio deste lançamento ocorreu em 30 de outubro.

O modelo é capaz de aceitar dados textuais e gráficos como entrada, gerando texto para executar tarefas relacionadas à compreensão de documentos, escrita de código e uso de ferramentas externas.

Ele funciona através de uma passagem dupla de um bloco comum de 24 camadas de decodificação, o que permite criar um caminho computacional mais profundo a partir de um modelo base com cerca de nove bilhões de parâmetros.

A configuração documental de treinamento suporta sequências de até 262.144 tokens e combina exemplos que incluem texto, imagens, código e uso de ferramentas. A SenseTime publicou os pesos do modelo, instruções de inferência e um guia de treinamento, distribuindo o projeto sob a licença Apache 2.0.

Histórias semelhantes

Empresa MemTensor lança modelo aberto MemT 1.0 com memória para preservar longas histórias
Leia mais
pandaily.com

Empresa MemTensor lança modelo aberto MemT 1.0 com memória para preservar longas histórias

A empresa chinesa MemTensor apresentou e disponibilizou publicamente uma série de modelos que ela chama de modelos fundamentais orientados à memória, denominados MemT 1.0. Esta série inclui dois modelos: MemT-1.0-Flash, com um total de 288 bilhões de parâmetros, dos quais 17 bilhões são ativamente utilizados, e MemT-1.0-Nano, com 36 bilhões de parâmetros totais e 3 bilhões ativos.

Os pesos desses modelos estão disponíveis na plataforma Hugging Face, e o código correspondente está no GitHub junto com um relatório técnico.

Os modelos foram desenvolvidos para resolver um problema comum relacionado a diálogos longos. A maioria dos sistemas existentes armazena todo o histórico na janela de contexto, o que leva a lentidão e aumento do custo de inferência a cada nova jogada. Em vez disso, o MemT integra um módulo de memória treinável dentro do próprio modelo.

Após cada interação, o modelo grava novas informações em um estado de memória fixo e as recupera quando necessário, em vez de reler todo o registro anterior repetidamente.

A MemTensor informa que o treinamento dos modelos ocorreu em duas fases com base em 34 bilhões de tokens: primeiro, o modelo aprendeu a gravar informações na memória, e depois ele foi treinado para responder a perguntas usando essas informações salvas.

Resultados de desempenho e comparação

Todos os indicadores de desempenho apresentados são baseados na avaliação própria da empresa. A MemTensor afirma que a inferência ponta a ponta funciona aproximadamente 1,86 vezes mais rápido do que a abordagem de contexto completo com um histórico de 128 mil tokens, e cerca de 3,99 vezes mais rápido com 256 mil tokens.

O tempo de resposta do primeiro token é estimado em cerca de 104–112 milissegundos para o modelo com memória, em comparação com aproximadamente 445 milissegundos para o contexto completo em 256K. Além disso, a empresa observa que o volume do estado de memória por sessão com um histórico de 256K é de cerca de 40 MB, o que é significativamente menor do que os 5,06 GB necessários para o cache de contexto completo, representando uma redução de cerca de 130 vezes.

Em 11 benchmarks de memória, a MemTensor declara médias de 50,6 para Flash e 47,0 para Nano. Esses resultados colocam os modelos em primeiro e segundo lugar entre os métodos paramétricos de memória comparados e correspondem aproximadamente aos resultados das abordagens de extensão por recuperação (retrieval-augmented approaches) em média, mesmo sem recuperar o histórico durante a consulta.

A empresa também destaca que a adição de memória não prejudicou as capacidades gerais do modelo Flash em testes com muitos fatores de distração.

Os desenvolvedores devem prestar atenção às condições de licenciamento: o código do repositório está publicado sob a licença não comercial PolyForm, enquanto os pesos dos modelos têm licenças Apache e MIT, respectivamente.

A equipe planeja continuar o desenvolvimento em direção à melhoria da memória de longo prazo, ao aumento da capacidade de memória e à redução dos custos de atualização de memória, com o objetivo de longo prazo de criar agentes que continuem aprendendo com base em suas interações.
ACE Robotics lança modelo para percepção espacial de robôs
Leia mais
technode.com

ACE Robotics lança modelo para percepção espacial de robôs

A ACE Robotics, fundada pelo cofundador da SenseTime, Xiaogang Wang, apresentou seu modelo de inteligência artificial encarnada, o ACE-Brain-0.6, em 19 de outubro. Este modelo foi desenvolvido através do ajuste fino controlado do Qwen3.5-9B e destina-se ao reconhecimento de objetos, determinação de sua localização em imagens e estabelecimento de pontos de interação para robôs.

De acordo com a empresa, o treinamento do modelo foi realizado utilizando cerca de um milhão de amostras de ancoragem espacial. Durante as avaliações realizadas, o ACE-Brain-0.6 demonstrou superioridade sobre o GPT-6 Astra em seis dos oito benchmarks de ancoragem.

O modelo obteve uma média de 74,53 pontos em sete benchmarks públicos e alcançou um resultado de 94,13 no teste RobotGrounding, baseado em cenários de robôs reais. Esses indicadores são superiores aos de Astra, que obteve 73,68 e 91,10, respectivamente.

Empresa VAST lança modelo aberto EdenLive para renderizar frames de jogos simples em vídeo detalhado
Leia mais
pandaily.com

Empresa VAST lança modelo aberto EdenLive para renderizar frames de jogos simples em vídeo detalhado

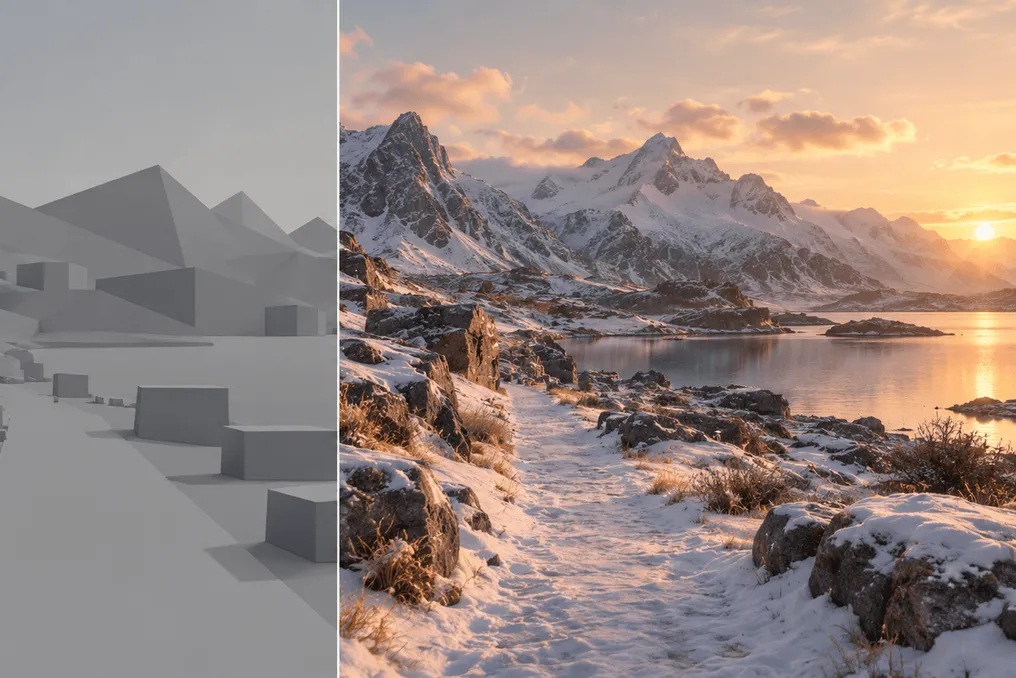
A VAST, uma empresa especializada em IA generativa em 3D e por trás da plataforma Tripo, tornou o modelo EdenLive público. Este modelo opera em tempo real e é capaz de pegar frames de jogos simplificados ou vídeos existentes, redesenhando-os continuamente em imagens detalhadas em um estilo escolhido, que pode variar de fotorrealista a anime.

O lançamento inclui pesos de modelos de 5B e 14B, código para inferência em tempo real, um relatório técnico e demonstrações de uso ponta a ponta. É importante notar que o EdenLive não simula o mundo por conta própria; em vez disso, um programa superior, como um motor de jogo ou código escrito por um agente de codificação, é responsável por aplicar as regras, rastrear o estado do mundo e gerar um vídeo de referência bruto.

Após receber este vídeo de referência, o EdenLive realiza o render, guiado pelo primeiro frame definido e pelo prompt de texto. A VAST afirma que essa separação permite manter a lógica do jogo explícita e testável, enquanto as capacidades limitadas do modelo em tempo real são focadas exclusivamente na aparência.

A abordagem foi apresentada pela primeira vez em junho no âmbito de uma pesquisa mundial mais ampla conhecida como Projeto Eden. De acordo com a VAST, o modelo de 5B é capaz de operar com uma taxa superior a 24 quadros por segundo em resolução 720p em uma única placa Nvidia RTX 5090. No arquivo README do GitHub, esse número é indicado aproximadamente como 24.7 FPS em resolução de 1280 por 704 pixels, utilizando aceleração do framework de inferência LightX2V.

O relatório técnico relata uma taxa de 29.8 FPS na mesma resolução em um único H100, bem como 26.8 FPS em resolução de 832 por 480 para o modelo de 14B rodando em oito H100. A VAST afirma que a latência total desde a entrada do usuário até o quadro correspondente é de centenas de milissegundos, e o sistema pode gerar conteúdo continuamente por vários minutos.

Ambos os modelos são baseados nos modelos de vídeo Wan2.2-TI2V-5B e Wan2.1-I2V-14B. O código de inferência e os principais pesos de difusão, VAE e decodificador são distribuídos sob a licença Apache 2.0, mas nem todos os componentes possuem essa licença. O codificador visual utiliza a licença DINOv3, e o modelo de imagem usado no espaço de trabalho de solicitação para jogo está sob a Licença Não Comercial FLUX, o que restringe o uso desse espaço de trabalho a fins não comerciais.

A VAST também apresentou o Game Prototype Turbo — um recurso que transforma um prompt de texto em um jogo jogável bruto, que pode então ser renderizado pelo EdenLive. As demonstrações da VAST incluem um plataforma onde o personagem congela lava para criar pontos de apoio, um jogo de luta multiplayer onde as barras de vida e o cronômetro de rodada são rastreados pelo sistema superior, e o render de vídeo que transforma uma pessoa filmada contra um fundo azul em um personagem de desenho animado. Além disso, o modelo demonstra a substituição de mãos humanas por robóticas em filmagens de primeira pessoa para criar dados de treinamento adicionais para IA incorporada.

A VAST observa que, atualmente, o EdenLive é mais adequado para interações de baixa frequência, como inspeção de cenas e quebra-cabeças de empurrar caixas. Jogabilidade rápida e intensa, manutenção da coerência de múltiplos personagens, controle fino de objetos pequenos e estabilidade visual em sessões longas ainda requerem melhorias.

Popular