Astronauta quase se afoga em capacete durante atividade espacial, evento que levou a revisões de segurança da NASA
Leia mais
Olhar Digital
olhardigital.com.br

Astronauta quase se afoga em capacete durante atividade espacial, evento que levou a revisões de segurança da NASA

Em junho deste ano, a NASA divulgou a composição da equipe selecionada para a missão Artemis 3. Prevista para ser lançada em 2027, esta iniciativa histórica visa testar tecnologias cruciais em órbita terrestre antes de realizar novos avanços em direção à Lua.

O comando desta operação será exercido por Randy Bresnik, um astronauta experiente que participou da missão STS-129, onde recebeu a notícia do nascimento de sua filha, além de ser ex-comandante das Expedições 52 e 53 na Estação Espacial Internacional (ISS).

O grupo também inclui Andre Douglas e Frank Rubio, conhecido por registrar o recorde americano de permanência contínua em órbita, totalizando 371 dias no espaço, atuando como especialistas de missão. O posto de piloto será ocupado por Luca Parmitano, representante da Agência Espacial Europeia (ESA), que esteve envolvido em um dos incidentes mais graves na ISS.

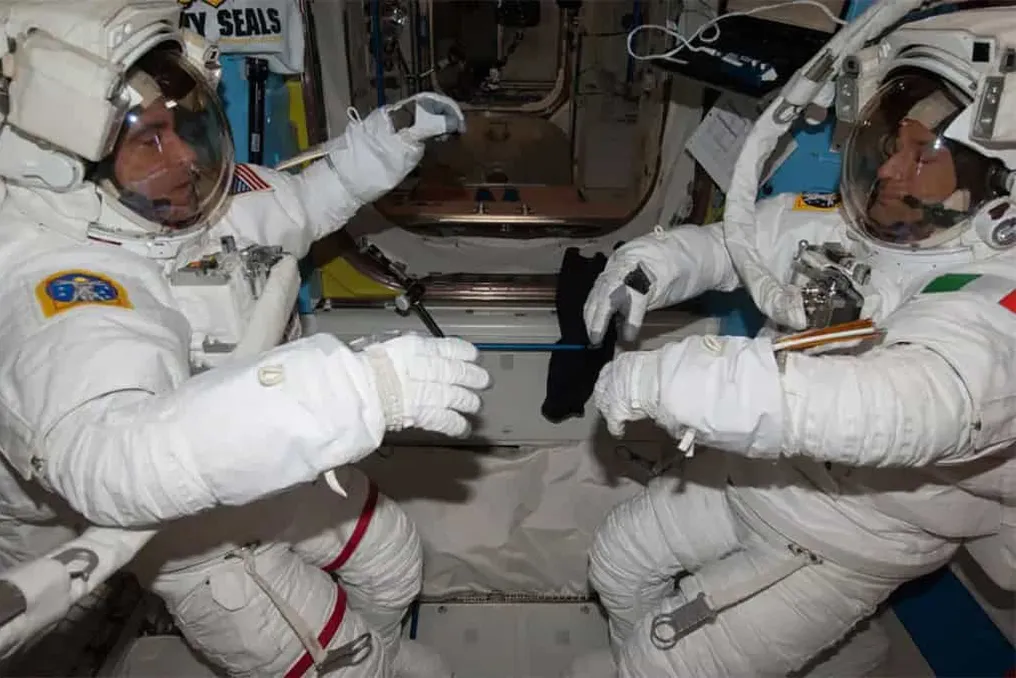
Em 16 de julho de 2013, Luca Parmitano enfrentou um risco de vida durante uma atividade extraveicular. De acordo com a NASA, uma falha mecânica séria provocou o vazamento de água do sistema de refrigeração para dentro do seu traje espacial. O astronauta relatou que, quando a água atingiu seu rosto, ele ficou quase cego, incapaz de ouvir ou respirar.

Na condição de microgravidade, o líquido flutua sem direção, cobrindo olhos, nariz e boca, o que representa um perigo real de afogamento orbital a quatrocentos quilômetros de altitude.

O problema crítico teve início uma semana antes, no dia 9, durante uma caminhada espacial anterior. Nessa ocasião, a equipe de apoio em terra chegou a concluir erroneamente que a presença de líquido era proveniente unicamente da bolsa de hidratação portátil utilizada pelos tripulantes.

A causa técnica verdadeira foi uma contaminação imperceptível que obstruiu um filtro interno vital do sistema de resfriamento. Este entupimento inesperado desviava o fluxo hídrico, fazendo com que o refrigerante vazasse diretamente para a linha de suprimento de ar do capacete.

Após investigações minuciosas, os analistas determinaram que a NASA não deveria ter liberado a segunda caminhada espacial sem resolver completamente a falha inicial. O relatório oficial do ocorrido estabeleceu quarenta e nove recomendações rígidas para prevenir a recorrência de erros similares.

Diferente dos planos originais, a missão Artemis 3 não contemplará mais o pouso final na superfície lunar. O objetivo principal do projeto é realizar testes rigorosos em baixa órbita terrestre de todos os subsistemas essenciais que serão utilizados na Artemis 4, agendada para 2028.

Este marco representará o retorno de pousos tripulados concentrados na área do Polo Sul da Lua. Para alcançar esse objetivo, o foguete Space Launch System (SLS) da NASA transportará a cápsula tripulada Orion partindo do Centro Espacial Kennedy, na Flórida.

Outro aspecto desafiador da Artemis 3 incluirá testes avançados de acoplamento com os módulos lunares tripulados desenvolvidos pela Blue Origin e SpaceX, os quais servirão para possibilitar futuras descidas ao solo lunar.

A NASA descreve esta grande jornada operacional como uma série de lançamentos. O plano abrange avaliações integradas de hardware, softwares de voo sofisticados, propulsão de alta performance e os canais de comunicação entre a nave Orion e os módulos de pouso.

Para assegurar a máxima segurança das tripulações futuras, a agência instituiu novos protocolos extremamente rigorosos. Os engenheiros passam a realizar verificações triplas em todos os componentes hidráulicos antes de qualquer liberação para o ambiente hostil do espaço sideral.

As melhorias tecnológicas também foram aplicadas aos trajes espaciais modernos, que agora possuem sensores inteligentes capazes de detectar vazamentos mínimos de líquidos em tempo real. Assim, qualquer anormalidade no sistema de refrigeração é detectada imediatamente pelos sistemas de bordo e pelos controladores em terra.

Com estas proteções aprimoradas, a exploração humana da Lua adquire uma camada adicional de confiabilidade técnica e operacional. A humanidade absorveu lições severas com o quase afogamento de Parmitano, transformando um erro potencialmente fatal em um legado duradouro de segurança.
Histórias semelhantes

Identificadores DeepSeek V5 encontrados no código do Harness; V4.1-Flash lidera entre modelos abertos no FrontierCode
Leia mais
pandaily.com

Identificadores DeepSeek V5 encontrados no código do Harness; V4.1-Flash lidera entre modelos abertos no FrontierCode

Desenvolvedores descobriram três novos identificadores de modelos no repositório oficial do Harness da DeepSeek no GitHub: deepseek-v5, deepseek-v5-open e deepseek-v5-next. Atualmente, a DeepSeek não anunciou o modelo V5, e esses registros são placeholders de teste no código, e não modelos disponíveis.

Ao verificar o repositório, foi constatado que esses identificadores estão em um arquivo de teste para o provedor de contas DeepSeek, especificamente no arquivo packages/llm/llm-deepseek-account/tests/provider.spec.ts, nas linhas 154–156, ao lado da entrada existente deepseek-v4-pro. O histórico do repositório mostra que eles foram adicionados em um commit de 24 de setembro, que moveu o diretório de modelos da conta DeepSeek para a lista oficial de modelos.

O cenário de teste verifica como o cliente filtra os modelos por requisito de versão: a entrada v5-open exige uma versão mínima do cliente 0.0.1, enquanto v5-next exige 99.0.0-alpha.1, e o teste espera que apenas os modelos flash e v5-open apareçam na lista. Isso indica a possibilidade de alternar para um novo modelo do lado do servidor do Harness, seja para todos os clientes ou apenas para aqueles que atualizaram, sem a necessidade de lançar uma nova versão. No entanto, isso não confirma a existência do modelo V5 nem seu cronograma de lançamento, e alguns desenvolvedores consideram esses nomes meros placeholders de teste. Até 28 de outubro, a DeepSeek não publicou nenhum anúncio, cartão de modelo ou identificador de API para a série V5.

A oferta atual de modelos inclui V4-Pro e V4.1-Flash; este último foi lançado em setembro com uma nova arquitetura, mantendo o nome V4.

Na mesma semana, um novo resultado de benchmarking foi apresentado para o modelo atual. A Artificial Analysis lançou o Intelligence Index v5, que é a maior atualização desde o lançamento do v4 em janeiro, com 60% do peso agora baseado em conjuntos de dados de teste fechados ou respostas ocultas. O codificação representa 25% do índice, e desses 15 pontos, FrontierCode 2.0 da Cognition corresponde a 132 tarefas reais de código aberto que avaliam se os repositórios acompanhantes aprovariam o pedido de fusão.

Na plataforma FrontierCode 2.0, o modelo DeepSeek V4.1-Flash-1017 alcançou 28% com esforço máximo, sendo o maior resultado entre os modelos com pesos lançados. Kimi K3.1 Pro obteve 25,5%, mas seus pesos completos ainda não estão disponíveis. Gemini 4 Argon atingiu 25,7%, e GPT-6 Luna — 25,2%.

O índice geral foi menos favorável. DeepSeek V4.1-Flash obteve 32 pontos, empatando com GLM-5.3, enquanto o líder, Claude Opus 5.5, recebeu 58 pontos. A Artificial Analysis observa que a lacuna entre o melhor modelo aberto com pesos lançados e o líder da tabela aumentou de 3 pontos sob v4.3 para 12 pontos sob v5.

Moore Threads lança Megatron-MUSA-Titan para treinar modelos MoE com um trilhão de parâmetros em GPUs próprias
Leia mais
pandaily.com

Moore Threads lança Megatron-MUSA-Titan para treinar modelos MoE com um trilhão de parâmetros em GPUs próprias

A empresa Moore Threads tornou o projeto Megatron-MUSA-Titan público, apresentando uma infraestrutura para treinamento de grandes modelos que ela desenvolveu para uso em suas próprias unidades de processamento gráfico. Este projeto é destinado ao trabalho com modelos do tipo 'mistura de especialistas' (mixture-of-experts) com um trilhão de parâmetros em clusters compostos por mais de 10.000 GPUs da Moore Threads, abrangendo tanto o pré-treinamento quanto o treinamento por reforço.

O código do projeto está disponível no GitHub. A empresa afirma que este sistema foi usado continuamente para pré-treinar MoE com um trilhão de parâmetros em clusters de 10.000 GPUs, onde sessões de treinamento prolongadas garantiram alta utilização de FLOPs do modelo e estabilidade do processo.

O repositório apresenta um exemplo de configuração para um modelo MoE no estilo Kimi-K2 com 1 trilhão de parâmetros. O princípio central do design foi manter a proximidade com soluções existentes. O Megatron-MUSA-Titan é construído sobre o framework Megatron-LM da NVIDIA. Graças à integração do PyTorch via torch_musa e à compatibilidade MUSA C com CUDA C, os desenvolvedores que possuem o ambiente MUSA podem clonar os repositórios oficiais Megatron-LM, slime e miles e iniciar o treinamento nas GPUs Moore Threads sem a necessidade de modificar o código-fonte.

O projeto indica que algoritmos gerais e correções de erros devem ser direcionados aos projetos superiores, enquanto a Moore Threads se concentra em dois tipos de alterações: otimizações em larga escala adaptadas ao hardware e clusters da Moore Threads, e soluções alternativas para problemas específicos do MUSA.

Os recursos de pré-treinamento incluem treinamento em bloco no formato FP8, que depende do MT-TransformerEngine da Moore Threads. A roteamento e agregação de tokens MoE são acelerados com o DeepEP, que opera sobre o Async Copy Engine da empresa, permitindo também a comunicação dos especialistas em paralelo com os cálculos. Outras opções incluem o descarregamento de ativações usando paralelismo de pipeline virtual e o agendamento de uma passagem direta e uma passagem reversa, além da comunicação paralela de pipeline combinada com cálculos, graças ao Mooncake RDMA.

A ferramenta de análise de rastreamento distribuído lê os rastreamentos PyTorch de cada GPU para detectar gargalos, como bolhas de pipeline e nós de baixo desempenho. O projeto afirma ser capaz de analisar uma execução de MoE com 1 trilhão de parâmetros em 10.000 GPUs em apenas algumas horas.

Para o treinamento por reforço, o stack suporta os frameworks slime e miles; o Megatron cuida do treinamento, e a compilação MUSA-SGLang gera as passagens, permitindo que um único sistema base atenda tanto ao pré-treinamento quanto ao RL. A otimização para inferência autônoma não faz parte do escopo deste projeto.

Para desenvolvedores que consideram aceleradores domésticos, a questão prática é qual parte do código de treinamento existente permanecerá funcional. A resposta da Moore Threads é que o código do ecossistema Megatron não requer modificações.

Iluvatar CoreX demonstra o funcionamento do GPU Tiangai 300, alegando desempenho superior ao H200 em 1,05x
Leia mais
pandaily.com

Iluvatar CoreX demonstra o funcionamento do GPU Tiangai 300, alegando desempenho superior ao H200 em 1,05x

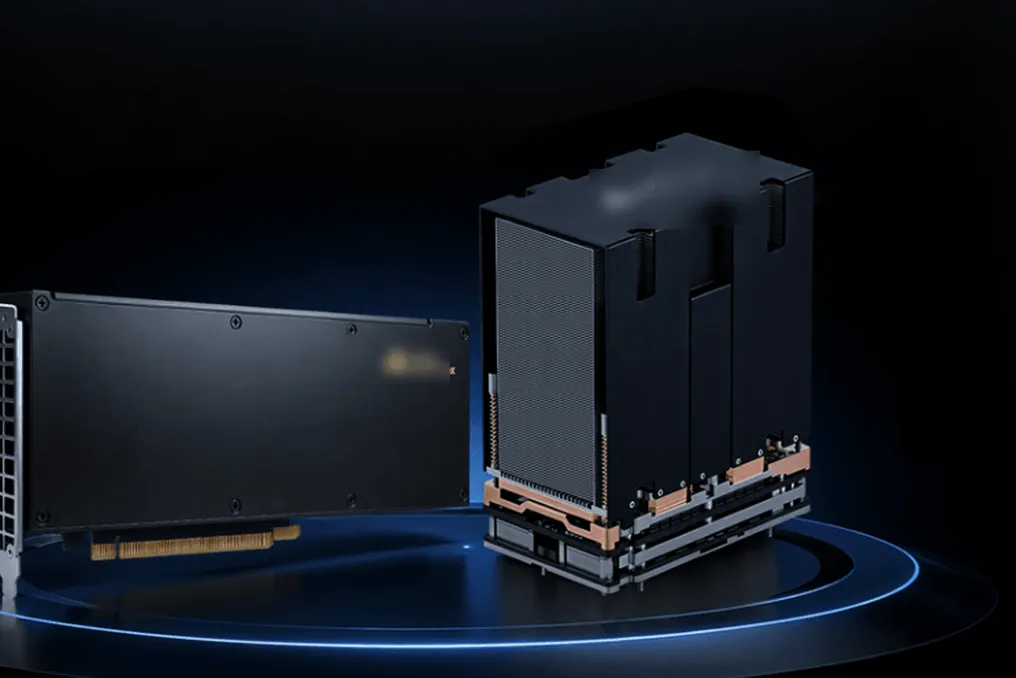
A empresa Iluvatar CoreX, durante seu dia de mídia realizado em 28 de outubro em Xangai, apresentou pela primeira vez o processador gráfico de propósito geral Tiangai 300 em funcionamento em hardware real. Até então, os materiais públicos da empresa sobre o chip focaram exclusivamente na arquitetura e no roteiro, e não em sistemas operacionais.

A principal declaração é uma comparação de desempenho. A Iluvatar CoreX afirma que o Tiangai 300 se tornou o primeiro GPU de propósito geral doméstico com desempenho medido que atinge o nível do NVIDIA H200. Além disso, testes de terceiros, após conversão de dados, mostraram que a largura de banda total de um único cartão é 1,05 vezes maior do que a do H200. É importante notar que a empresa não divulgou a metodologia de teste, os modelos utilizados ou as condições de carga de trabalho, portanto, este resultado ainda não pode ser verificado independentemente.

Este chip é destinado à implementação no supernó IXL144, apresentado anteriormente pela empresa na Feira Internacional Industrial da China. Um telhado IXL144 combina 144 GPUs, 18 CPUs e cerca de 10,1 TB de memória GPU, o que a Iluvatar CoreX chama de supernó GPU mais denso do setor. Segundo suas próprias estimativas, essa configuração reduz o custo em um milhão de tokens eficientes em 40% em comparação com soluções internacionais principais.

No dia aberto, também foram apresentadas informações sobre implantação heterogênea. A Iluvatar CoreX informou que implementou o primeiro esquema doméstico de desagregação AFD entre GPU e XPU, o que permitiu reduzir a latência de inferência em 60%. A desagregação AFD geralmente implica a divisão das etapas de cálculo do modelo, como camadas de atenção e propagação direta, entre diferentes tipos de processadores, para que cada um execute o trabalho no qual é mais eficiente.

Quanto aos dispositivos periféricos, a empresa declarou que seu chip Tongyang TY1200 supera o NVIDIA Thor T5000 em testes realizados, novamente sem publicar detalhes. O TY1200, que foi anunciado anteriormente com 300 TOPS de computação densa para PCs de IA e inteligência incorporada, também foi nomeado como o primeiro produto periférico doméstico capaz de realizar simulação física com aceleração de GPU baseada em MuJoCo-Warp — uma função crítica para o treinamento de robôs em simulação.

Em geral, essas demonstrações levam a linha de produtos de próxima geração da Iluvatar CoreX do campo das especificações em papel para sistemas operacionais. O próximo ponto a ser observado serão os benchmarks independentes com cargas de trabalho divulgadas.

Popular