A SenseTime disponibilizou publicamente seu conjunto de ferramentas de avaliação de IA incorporada SenseNova-RoboRSI e um modelo de 27 bilhões de parâmetros. Este lançamento sucedeu uma pesquisa na qual a SenseTime testou o grande modelo GPT-6-Astra em doze benchmarks simulados e oito robôs reais. Todos os resultados apresentados são baseados em testes próprios da SenseTime.
A SenseTime apresentou o SenseNova-RoboRSI como um framework para avaliar sistemas de IA incorporada, bem como um modelo de IA incorporada chamado SenseNova-RoboRSI-27B-Preview. No âmbito da pesquisa, o grande modelo GPT-6-Astra foi testado em 12 benchmarks robóticos simulados e 8 robôs físicos.
Resultados dos Testes do GPT-6-Astra
De acordo com dados da SenseTime, quando o GPT-6-Astra teve acesso às demonstrações de treinamento e os limites de passos foram aumentados para dez vezes o valor oficial, o modelo atingiu a saturação nos benchmarks LIBERO e SIMPLE, e também demonstrou 81,9% de sucesso no RoboDojo. Em um caso, nove tarefas do RoboDojo, que anteriormente nunca eram concluídas em cinco tentativas, foram concluídas com sucesso em todas as cinco tentativas após o modelo ter sido autorizado a continuar a interação.
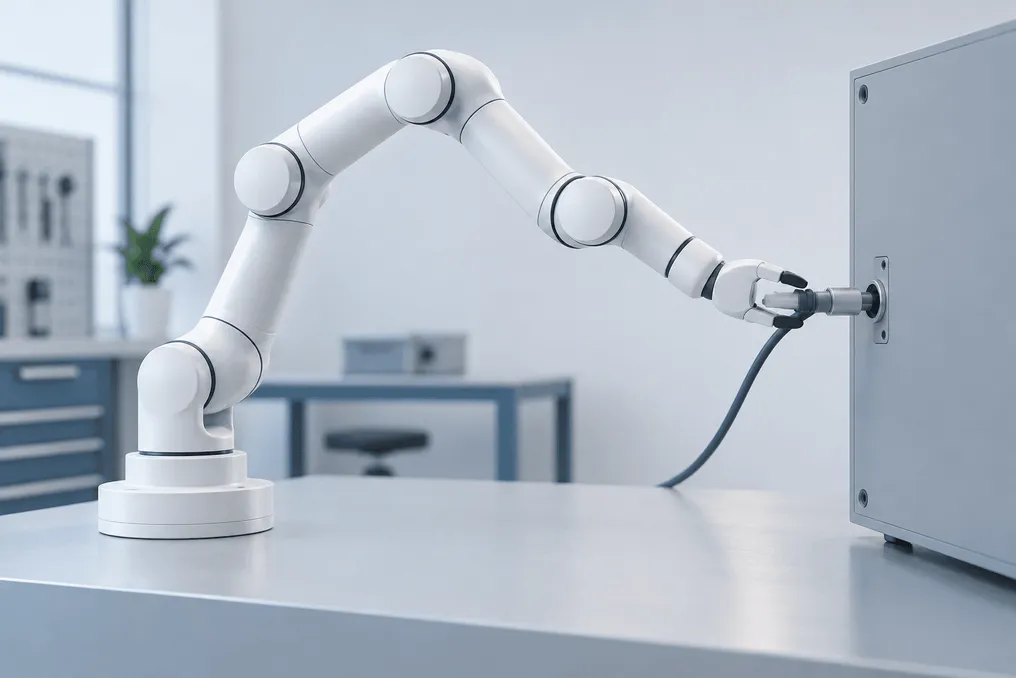
No entanto, isso teve um custo elevado. Em testes estendidos com orçamento maior, empilhar tigelas levou cerca de 131 minutos e custou aproximadamente US$ 19 em custos de inferência, enquanto colocar um cabo no suporte levou 263 minutos e custou cerca de US$ 55. A SenseTime também descobriu que o GPT-6-Astra apresenta maiores dificuldades ao executar tarefas de longo horizonte, tem problemas com a transferência de habilidades entre tarefas e também enfrenta dificuldades com objetos deformáveis e controle fino em robôs reais.
Em seguida, a empresa testou uma combinação de um modelo de raciocínio lento com um modelo de ação rápido. A melhor dessas combinações alcançou 54% de sucesso em 42 tarefas RoboDojo de ciclo fechado, verificando cada resultado, embora a SenseTime observe que o problema do custo permanece relevante.
O conjunto de ferramentas de código aberto empacota cada benchmark e suas dependências em uma imagem Docker separada e fornece uma API HTTP unificada para interagir com o ambiente e avaliação nativa. A SenseTime afirma que os pesquisadores podem realizar avaliações ponta a ponta usando um arquivo de configuração, sem a necessidade de configurar manualmente cada simulador.
Características do Modelo 27B
O modelo de 27 bilhões de parâmetros é projetado para incorporar experiência comprovada diretamente nos pesos do modelo, reduzindo a necessidade de ações experimentais e errôneas. A SenseTime relata que este modelo obteve 26,13 pontos no RoboDojo com uma taxa de sucesso de tarefas de 20,83%, superou a marca de 90 no LIBERO-Pro e aumentou sua porcentagem de sucesso no RoboCasa365 de 26,0% para 46,5%, ao mesmo tempo que reduziu o uso de tokens em 73%. A empresa afirma que ele executa tarefas de IA incorporada com um custo de um cinquagésimo em comparação com o GPT-6-Astra.
Além disso, a SenseTime insiste que futuros benchmarks de IA incorporada devem ser baseados nas necessidades reais humanas, exigir que os robôs aprendam através da interação e considerar o tempo de pensamento como tempo mundial, já que a chaleira continua a aquecer enquanto o modelo pondera a solução. Nenhum dos resultados apresentados foi verificado independentemente.