Ao discutir infraestrutura tecnológica, geralmente são mencionados semicondutores, centros de dados e modelos de inteligência artificial. No entanto, de acordo com os especialistas, o conjunto de dados subjacente a essas tecnologias desempenha um papel decisivo, algo que a Índia ainda precisa criar.
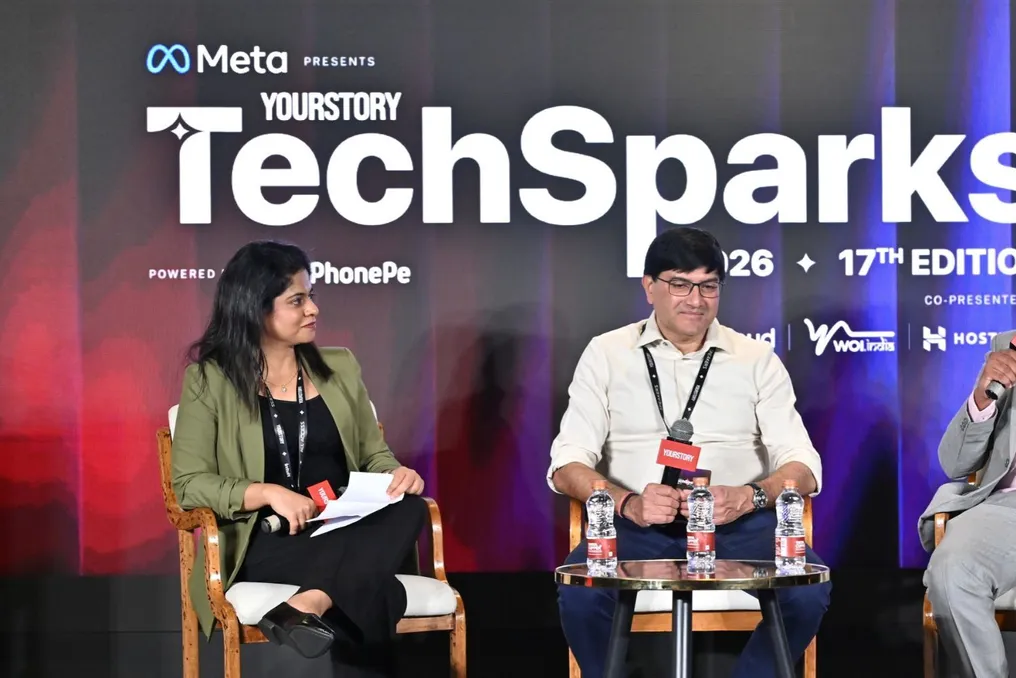
Durante um painel de discussão no evento TechSparks 2026, sobre o tema 'Infraestrutura invisível da nova ordem tecnológica', o moderador Chavi Mahajan, da YourStory, reuniu especialistas. Os palestrantes enfatizaram que a vantagem da Índia residirá na posse de dados confiáveis e ricos em contexto em áreas como IA linguística e biotecnologia.
Arvind Pani, fundador da startup CoreMantle, especializada em dados inteligentes de IA, afirmou que os dados são a parte da pilha tecnológica que não pode ser substituída. Ele observou: 'Você pode continuar substituindo poder computacional. Você pode continuar substituindo o aplicativo, mas os dados não podem ser substituídos.'
Ankit Bagaria, cofundador e CEO da Loopworm, uma empresa de biotecnologia de insetos, apontou que a lacuna é particularmente grande no setor biofarmacêutico, onde grande parte do trabalho ainda é feita por tentativa e erro. Segundo ele, dados aprimorados poderiam reduzir o tempo de lançamento de produtos no mercado.
Bagaria também enfatizou que a biotecnologia deve receber tanta atenção quanto a IA, computação quântica e chips, especialmente após a pandemia de COVID-19. Ele destacou que a Índia importa cerca de 73% de seus materiais chave, incluindo ingredientes farmacêuticos ativos e reagentes, da China. Além disso, embora o país produza uma parcela significativa das vacinas mundiais em volume, isso representa apenas cerca de 5% do mercado em valor.
Ele acrescentou que, por muito tempo, eles trabalharam no segmento de bioanálogos, enquanto as moléculas eram descobertas por outros. Bagaria argumentou que agora a Índia precisa passar para o desenvolvimento de medicamentos.
Pani concordou que a necessidade de contexto local se aplica também às línguas. A internet na Índia foi originalmente criada para usuários de língua inglesa, o que criou dois obstáculos para a maioria dos cidadãos: eles tinham que aprender tanto a tecnologia quanto um novo idioma. Ele observou que apenas cerca de 4-5% da população indiana se sente confortável usando apenas inglês.
Além disso, Pani indicou que mesmo o inglês não é um problema totalmente resolvido para a IA. Modelos treinados predominantemente em inglês americano frequentemente têm dificuldades com sotaques australianos ou regionais, e o inglês falado nos diferentes estados da Índia varia muito. Ele concluiu: 'São nuances que ninguém mais entenderá, mas a Índia entenderá.'
Ambos os palestrantes concordaram que um maior volume de dados nem sempre significa melhor. Pani explicou que modelos de IA construídos com um menor número de dados enriquecidos e contextuais superam aqueles treinados em grandes volumes de dados brutos. Ele notou que muitos conjuntos de dados de idiomas indianos são gravados em estúdios a partir de roteiros, portanto, os modelos treinados neles funcionam bem em condições controladas, mas falham na comunicação real.
Bagaria confirmou esse pensamento, afirmando que, em relação aos dados biológicos, aplica-se o princípio de 'lixo na entrada, lixo na saída'.
A Loopworm gastou cerca de 12 a 13 meses limpando dados existentes e criando uma ferramenta digital que exibe o funcionamento interno do bicho-da-seda. Este trabalho exigiu adaptação a cepas de bicho-da-seda indianas e patógenos que o afetam. A Loopworm usa bichos-da-seda para produzir ração sustentável para animais e proteínas recombinantes de alto valor.
Bagaria explicou a escolha do bicho-da-seda porque a seda é composta por mais de 98% de proteína, tornando o inseto um dos transformadores de folhas vegetais em proteína mais eficientes na natureza. O bicho-da-seda foi domesticado há cerca de 4000 anos, seu genoma foi sequenciado em 2007, e cerca de 175 instituições na Índia ensinam sericicultura e biotecnologias relacionadas.
Ele acrescentou que essa abordagem baseada em dados já permitiu reduzir uma série de experimentos de 10 meses e 2,5 milhões de rúpias para dois meses e meio e aproximadamente 4,5 milhões de rúpias. 'Estou confiante de que daqui a 10 anos todos diremos que a IA teve o maior impacto na biotecnologia.'
Pani observou que os dados proprietários estão se tornando uma barreira competitiva. Ele citou a empresa jurídica Harvey, que alterou tanto seus modelos quanto sua capacidade de computação, mantendo seus dados orientados a domínios como principal vantagem.
Sobre o que precisa mudar, Pani declarou que a Índia deve desenvolver tecnologias para suas próprias necessidades. Ele lembrou que sua empresa anterior implementou suporte a idiomas indianos no Android em 2011 em parceria com a Qualcomm, antes do que o Google fizesse. 'Se continuarmos pensando que outra pessoa resolverá nosso problema, estaremos sempre atrasados.'
Bagaria saudou iniciativas governamentais, como a política BioE3 e o Fundo de Pesquisa, Desenvolvimento e Inovação. No entanto, ele pediu um aumento no financiamento público e fundamental para gerar dados básicos, como sequenciamento aprofundado e caracterização de organismos indianos, pois os investidores tradicionais dificilmente financiarão a ciência fundamental.