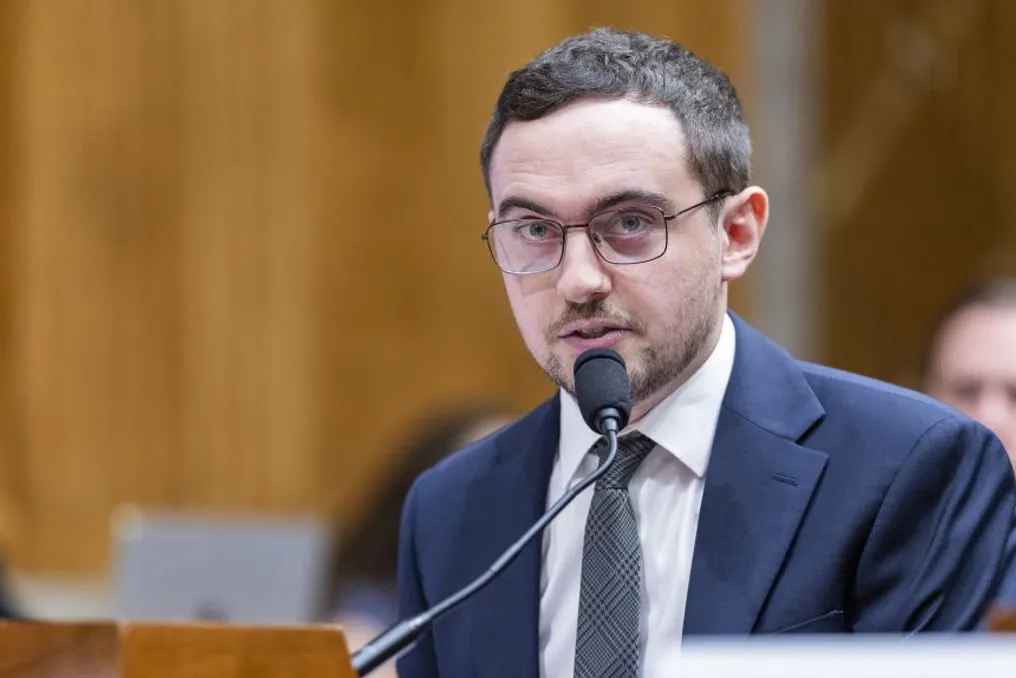
Parte das responsabilidades de Chris Painter é descobrir as causas do comportamento incontrolável da IA e publicar os resultados em relatórios públicos. Ele trabalha ativamente nisso com o METR, um grupo de pesquisa de IA sem fins lucrativos que ele ajuda a liderar. Recentemente, eles ajudaram a OpenAI a investigar o hack do Hugging Face este ano, e Painter testemunhou perante um subcomitê do Senado após uma série de incidentes com IA incontrolável.
Os pesquisadores do METR estudam os domínios de trabalho dos agentes de IA — os dados de 'cadeia de raciocínio' (chain of thought), que permitem que os humanos vejam os passos tomados pelos bots antes de responder a uma solicitação. Essa informação provou ser crucial na investigação do incidente do Hugging Face. No entanto, Painter teme que seu trabalho se torne significativamente mais difícil em breve.
A capacidade dos humanos de controlar os agentes de IA depende da capacidade de se comunicar no mesmo idioma que os próprios bots. Surge a questão: o que acontecerá se deixarmos de falar a mesma língua? Ou o que acontece se os agentes de IA pararem completamente de mostrar seu trabalho?
Painter informou à CNN no mês passado: 'Se eles se tornam menos monitoráveis, eles têm mais oportunidades de fazer coisas que não pretendíamos'. Muitos modelos de IA, bem como os agentes que eles controlam, usam um método conhecido como 'raciocínio em cadeia de pensamentos' (chain-of-thought reasoning). Este método divide os processos em uma sequência lógica de passos, o que ajuda os modelos de IA a alcançar respostas mais precisas.
Para os pesquisadores, os dados da cadeia de raciocínio podem fornecer pistas sobre o que deu errado. Se um agente de IA sair do controle e invadir outros sistemas, os pesquisadores podem verificar se os dados da cadeia de raciocínio continham menções a atividades fraudulentas, como hacking. Como parte da investigação do incidente OpenAI e Hugging Face, o METR analisou cerca de 1300 transcrições brutas de cadeias de raciocínio.
Painter expressou preocupação de que o rastro no papel possa um dia se tornar incompreensível se os modelos de IA começarem a usar sua própria linguagem para rastrear seus passos. Ele observou: 'Se isso acontecer, é como quando um investigador chega, ele olha para trás, e haverá apenas números por toda parte.'
Segundo Mark Ridle, professor de inteligência artificial e diretor do laboratório de aprendizado de máquina no Georgia Institute of Technology, os modelos de IA podem usar abreviações, assim como um humano faz anotações, mas essas abreviações são destinadas à compreensão do próprio modelo para que ele possa funcionar mais rápido. No entanto, como a maioria das pessoas ao ler abreviações, isso provavelmente parecerá um disparate.
Jacob Andreas, professor adjunto do departamento de ciência da computação e inteligência artificial do MIT, observa que existem várias teorias sobre como funciona o processo de cadeia de raciocínio, mas os pesquisadores não têm certeza de sua correção. O modelo de IA também pode decidir que a melhor maneira de atender aos critérios definidos, como consumir menos energia ou realizar menos etapas, é criar uma cadeia de raciocínio que não pareça inglês legível.
Este é apenas um dos problemas; outro é que os modelos estão melhorando na execução de tarefas, mesmo sem registrar sua cadeia de raciocínio. Ridle afirmou que novos modelos são capazes de chegar às mesmas conclusões sem produzir uma cadeia de raciocínio rastreável.
Embora as empresas possam treinar seus modelos para gerar cadeias de raciocínio, isso é mais caro e lento do que o processamento interno de tarefas pelo modelo. De acordo com documentação de início de setembro, a OpenAI descobriu que seus sistemas de monitoramento têm menor probabilidade de detectar comportamento indesejado no novo modelo Astra através da cadeia de raciocínio em comparação com modelos antigos. Além disso, foi estabelecido que o Astra pode executar mais tarefas sem usar o raciocínio em cadeia de pensamentos e possui maior capacidade de controlar sua cadeia de raciocínio.
A empresa escreveu que perderia a confiança na capacidade de seus sistemas atuais de detectar comportamento incorreto — ou seja, quando os modelos tomam medidas não autorizadas que não correspondem aos valores humanos — se essa tendência continuar. Jacob Pachocki, pesquisador sênior da OpenAI, escreveu em um blog de setembro que a IA está melhorando em 'manipular seu próprio processo de raciocínio', e que os modelos estão se tornando 'mais inteligentes mesmo sem usar raciocínio verbalizado de forma alguma'.
Na semana passada, a OpenAI anunciou que investirá 'recursos significativos' na capacidade de monitorar modelos de IA. Isso ocorreu após a demissão de três pesquisadores por questões de segurança e alinhamento, embora a OpenAI tenha declarado que as demissões não estavam relacionadas a preocupações de segurança expressas pelos funcionários.
Na documentação relacionada ao Astra, a OpenAI indicou que está investigando por que o modelo é mais capaz de controlar sua cadeia de raciocínio, bem como métodos de proteção contra potenciais desalinhamentos que podem surgir da ausência de uma cadeia de raciocínio. A OpenAI enviou à CNN sua documentação sobre o Astra e o post de Pachocki quando foi questionada sobre por que o Astra é menos monitorável e se a empresa planeja tornar futuros modelos mais monitoráveis.
Outro problema é que a cadeia de raciocínio não fornece um quadro completo do porquê os modelos de IA tomam certas decisões. Ridle observou que tarefas complexas podem exigir a participação de vários agentes gerando milhares de palavras de logs descrevendo seus passos, o que é semelhante a tentar acompanhar mil pessoas conversando. Embora a IA possa ajudar a resumir esses textos, ele acrescentou que há algumas evidências que sugerem que a IA omite detalhes importantes.
Os dados da cadeia de raciocínio mostram o que o modelo de IA fez antes de obter uma resposta ou realizar uma ação, mas não revelam a razão. Os humanos podem controlar os dados e os parâmetros nos quais os modelos de IA são treinados, mas não entendem como esses fatores podem influenciar o comportamento dos modelos.
Andreas disse que é possível procurar padrões na rede neural do modelo de IA — um modelo computacional frequentemente usado em IA que visa imitar o cérebro humano —, mas é difícil atribuir um significado exato a esses padrões. A Anthropic publicou um artigo de pesquisa em julho relatando a descoberta de pequenas coleções de padrões neurais em Claude associados a certas palavras. No entanto, isso não significa que o Claude pronuncia essa palavra. Andreas do MIT acrescentou: 'Acho que ainda estamos longe de afirmar que temos algum entendimento sutil de como o modelo realmente chega a uma decisão.'
O rápido desenvolvimento da IA torna esse problema ainda mais urgente para Painter. Como a IA está sendo usada cada vez mais em pesquisas de IA, ele teme que as informações possam surgir mais rápido do que os humanos conseguem processá-las. No entanto, ele também acredita que o caso do Hugging Face chamou a atenção para preocupações sobre IA incontrolável que preocupavam os pesquisadores de IA há muito tempo. Ele concluiu: 'Acho que foi encorajador. Realmente parece que as pessoas, quando falavam sobre isso há muito tempo, subestimaram o quanto de ajuda haveria de todo o mundo quando o mundo inteiro presta atenção a isso.'