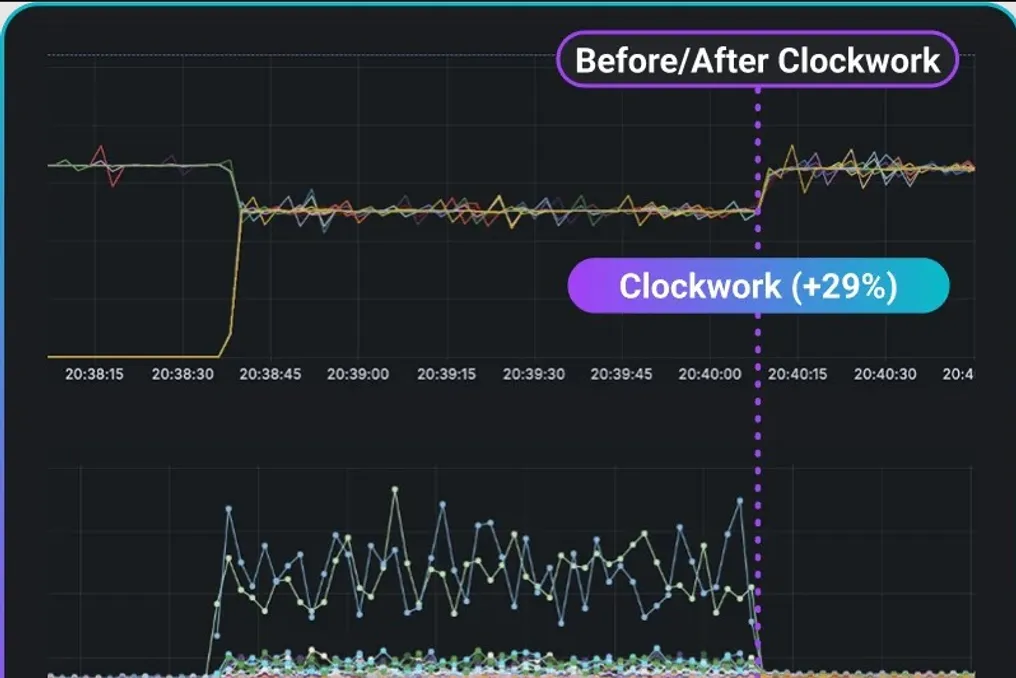
A Clockwork.io levantou US$ 31 milhões em capital novo para combater problemas operacionais decorrentes de falhas na infraestrutura que podem levar à perda de enormes volumes de recursos computacionais de GPU.
Mesmo uma falha insignificante na infraestrutura pode interromper o funcionamento de milhares de processadores gráficos interconectados. Durante reinicializações lentas do sistema, grandes somas de dinheiro são efetivamente perdidas. A empresa busca implementar software avançado para aumentar a tolerância a falhas, que detecta uma tarefa de treinamento antes que ocorra a falha real do hardware.
A escalabilidade da inteligência artificial é um processo extremamente caro e complexo. Quando as empresas treinam modelos gigantescos em milhares de chips interligados, a sincronização perfeita é absolutamente essencial. Se apenas um servidor travar, toda a carga distribuída para.
Historicamente, a única maneira de resolver esse problema era a reinicialização cega do ponto de verificação, mas esse processo ineficiente força o descarte de horas valiosas de computação. Por exemplo, a Meta relatou que, durante o treinamento de seu modelo Llama 3, eles enfrentaram falhas imprevistas aproximadamente a cada três horas. Continuar pagando pela inatividade do silício durante a reinicialização é simplesmente insustentável no ambiente tecnológico altamente competitivo moderno.
A solução é parar de tentar prevenir falhas de hardware e começar a treinar o software para ignorar os danos. É aqui que reside a genialidade da Clockwork. Suas principais ferramentas, TorchPass e LinkPass, funcionam como um buffer inteligente invisível entre o hardware frágil e os fluxos de trabalho críticos.
Se a conexão de rede cair subitamente, o LinkPass redireciona o tráfego instantaneamente. Se a GPU começar a falhar durante os cálculos, o TorchPass transfere suavemente o trabalho atual para um chip funcional. Além disso, a empresa lançou recentemente um recurso pioneiro no setor que permite tirar snapshots de uma tarefa multi-nó em execução sem a necessidade de modificações no código dos desenvolvedores.
A legitimidade da solução é comprovada por sua adoção pelos maiores players do mercado. Essa abordagem já foi testada em condições reais. Por exemplo, o LinkedIn utiliza essa camada de tolerância a falhas em seus vastos sistemas, prevenindo ativamente dezenas de milhares de horas de tempo ocioso de GPU mensalmente. Falhas que antes causavam grandes crises operacionais agora são tratadas como manutenção de rotina.
Provedores de soluções em nuvem, como Together AI e WhiteFiber, também estão adotando ativamente essa tecnologia. Eles investem na Clockwork.io porque fornecer capacidade de computação confiável e ininterrupta aos clientes é a base de seu modelo de negócios.
Graças a este significativo influxo de fundos, liderado conjuntamente por grandes investidores como Premji Invest e Wing Venture Capital, o financiamento total da empresa atingiu US$ 73 milhões. A Clockwork.io planeja usar esse capital para mudar fundamentalmente as regras de tolerância a falhas da infraestrutura.
Com o crescimento exponencial dos modelos, a probabilidade de falha de hardware se aproxima da inevitabilidade matemática. Proteger essas cargas de trabalho colossais não é apenas uma opção desejável, mas um mecanismo de sobrevivência crítico. Manter os chips caros ativos em vez de em repouso no ciclo de reinicialização é a principal vantagem para a próxima geração de desenvolvimento de inteligência artificial.