Por muito tempo, no campo da inteligência artificial corporativa, existia a crença de que quanto mais informação um modelo pudesse processar, melhor seria seu resultado. À medida que as janelas de contexto se expandiram de milhares para milhões de tokens, grandes volumes de dados passaram a ser associados ao progresso. Em resposta a isso, as organizações começaram a fornecer aos assistentes de IA vastos repositórios de documentos e históricos de conversas.
Na empresa Elastic, essa mudança tornou-se evidente à medida que os clientes passavam de projetos piloto para operação completa. No entanto, o problema não era a capacidade da IA de processar mais dados, mas sim o quão corretamente ela analisava os dados específicos necessários.
A tendência conhecida como tokenômica surgiu no início de 2026 no Vale do Silício e consistia em maximizar o consumo de tokens de IA como indicador de desempenho. Algumas empresas criavam classificações internas de funcionários com base na quantidade de tokens utilizados, e um alto consumo tornava-se um símbolo de status, independentemente da qualidade do resultado final. Essa tendência foi fortemente criticada por avaliar a entrada de dados, e não os resultados alcançados. Como observa Ravindra Ramanani, chefe de engenharia de campo na Índia, Elastic, é 'equivalente a avaliar desenvolvedores pelo número de linhas de código na era da IA'.
Um erro semelhante manifesta-se no nível da arquitetura, quando as equipes incluem documentos e históricos de conversas desnecessários nas consultas, acreditando que informações adicionais melhorarão a saída. Os modelos não possuem a capacidade de filtrar material supérfluo, como analistas qualificados, o que leva ao aumento do ruído, à lentidão da resposta e à necessidade de uma verificação manual significativa dos resultados.
A lacuna tornou-se evidente quando as organizações migraram para sistemas de produção, onde um agente operando com contexto incompleto acarreta não apenas custos adicionais, mas também erros graves. Ramanani enfatiza: 'O diálogo, assim, mudou da questão 'quanto podemos dar ao modelo' para a questão 'o que o modelo realmente deve saber''. É esta questão que está na base da engenharia de contexto.
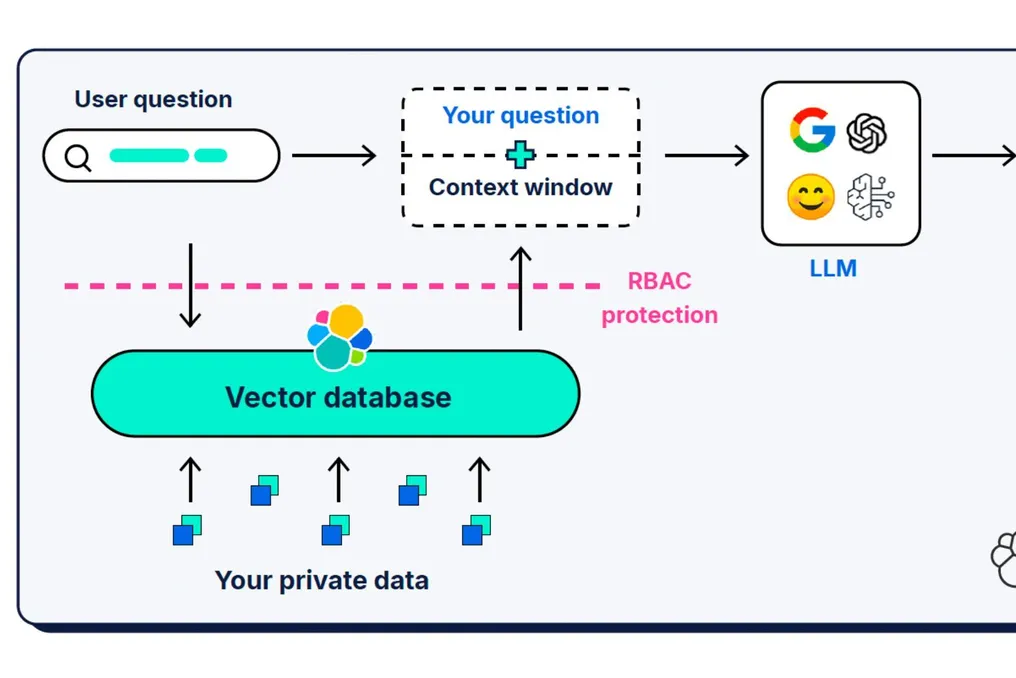
Engenharia de contexto é a disciplina que define qual informação o modelo vê em cada etapa de seu raciocínio: quais instruções definem os limites da tarefa, quais ferramentas estão disponíveis, o que é extraído dos sistemas corporativos, o que é transmitido de etapas anteriores e o que é intencionalmente excluído. No ambiente corporativo, a parte mais complexa é o processo de extração de informações, pois o modelo deve se basear em conhecimentos internos confiáveis sem ser sobrecarregado por eles.
Uma analogia simples ajuda a entender a essência: a tokenômica é semelhante a entregar a alguém todo um arquivo com o pedido de encontrar uma página específica. A engenharia de contexto é fornecer a ele três páginas que ele realmente precisa, já marcadas. Ambos os cenários contêm a mesma informação, mas apenas um permite tomar decisões mais fundamentadas.
A importância da relevância vai além de uma função de busca simples. É um mecanismo que torna a IA autônoma segura para tomada de decisões. Quando um agente raciocina com base em dados incompletos, o risco não é apenas o poder computacional gasto. Em um cenário de conformidade bancária ou em um centro de segurança operacional, uma ação autônoma incorreta pode se propagar antes que um humano consiga intervir. As informações corretas devem ser menores em volume, ter um nível de sinal mais alto e ser controladas em termos de permissões, para que o agente tenha acesso apenas ao que está autorizado.
A combinação de relevância e governança garante a confiabilidade de um agente de produção, ao contrário de um projeto piloto caro. A engenharia de contexto eficaz baseia-se em três níveis: proximidade dos dados, que significa colocar a camada de raciocínio perto da fonte da verdade, em vez de rotear dados confidenciais através de canais externos; precisão da extração, que garante a apresentação apenas das informações que são um sinal verdadeiro para a decisão em questão, sendo que a busca híbrida da Elastic, que combina busca vetorial, por chave e estruturada com reclassificação semântica, garante relevância, e não apenas conectividade; e fixação da execução, que implica carregar as capacidades do agente sob demanda, em vez de equipar cada agente com um conjunto completo de ferramentas em cada etapa, o que reduz tanto os custos de token quanto o risco de ação autônoma não intencional.
A Elastic integra a extração de dados, a criação de ferramentas, a fixação conversacional e a observabilidade dos agentes em uma única plataforma. Essa plataforma permite implantações totalmente locais ou em ambientes isolados, e métodos como Better Binary Quantisation podem reduzir o volume de memória para dados de extração vetorial em até 32 vezes, mantendo a precisão.
Este também é um assunto de negócios antes de ser de engenharia: as equipes de negócios precisam definir como é o sucesso antes que as equipes técnicas comecem a implementá-lo, caso contrário, as organizações receberão pipelines elegantes que alimentam os agentes com dados incorretos.
O impacto disso é mais visível em situações que exigem a tomada de decisões importantes: analistas de segurança recebem apenas sinais relacionados a uma ameaça específica, e não um feed geral; equipes de finanças e seguros (FSI) fixam o trabalho dos agentes no contexto regulatório da transação, onde existem prazos rigorosos do CERT-In (12 horas) e diretrizes do RBI; e desenvolvedores de centros globais de competência (GCC) recebem respostas baseadas nos próprios sistemas da organização. Esses exemplos são particularmente relevantes na Índia, onde as empresas operam em diversos ambientes de dados, abrangendo sistemas bancários legados e aplicações modernas em nuvem, frequentemente com registros em hindi e idiomas regionais. Dada as obrigações da Lei DPDP e os requisitos de localização de dados, implantar toda a pilha de IA localmente ou em um ambiente isolado é uma exigência de aquisição para muitas organizações, e não uma preferência.
O erro mais comum é supor que conectar um modelo aos dados corporativos é equivalente a fixá-lo no contexto corporativo, pois o acesso não garante a extração relevante; o segundo equívoco mais frequente é ignorar a observabilidade do agente, o que priva a organização da capacidade de explicar as decisões do agente aos reguladores.
A escolha do modelo terá muito menos importância do que a qualidade do contexto no qual o modelo baseia seu raciocínio. Um modelo menor bem fixado supera consistentemente um modelo maior que opera com contexto fragmentado. A vantagem competitiva muda da aquisição de modelos acessíveis a praticamente todos por um preço comparável para o nível de inteligência que determina o que qualquer modelo pode realmente saber e fazer.
Além disso, as empresas precisam repensar as métricas de sucesso da IA. O uso de tokens e o tamanho do modelo dizem pouco sobre o valor de negócios. Indicadores mais significativos são orientados a resultados: porcentagem de conclusão de tarefas em comparação com a frequência de intervenção humana, precisão das decisões no ambiente de trabalho em comparação com testes, tempo de resposta em fluxos de trabalho críticos e capacidade de auditoria de acordo com os regulamentos, ou seja, um registro explicativo de quais dados o agente consultou e por quê.
A Gartner prevê que, até o final de 2026, 40% dos aplicativos corporativos usarão agentes especializados, e sistemas sem uma base de dados única e confiável herdarão os riscos de agentes individuais, agravando-os.
As organizações que extraem o maior valor de longo prazo da IA não são aquelas que o implementaram primeiro ou escolheram o modelo mais complexo. São aquelas que investiram em garantir a disponibilidade, precisão e confiabilidade de seus conhecimentos corporativos, para que qualquer sistema de raciocínio possa agir com base neles com confiança. O modelo não é uma barreira de proteção. A base de dados é o que ele é.