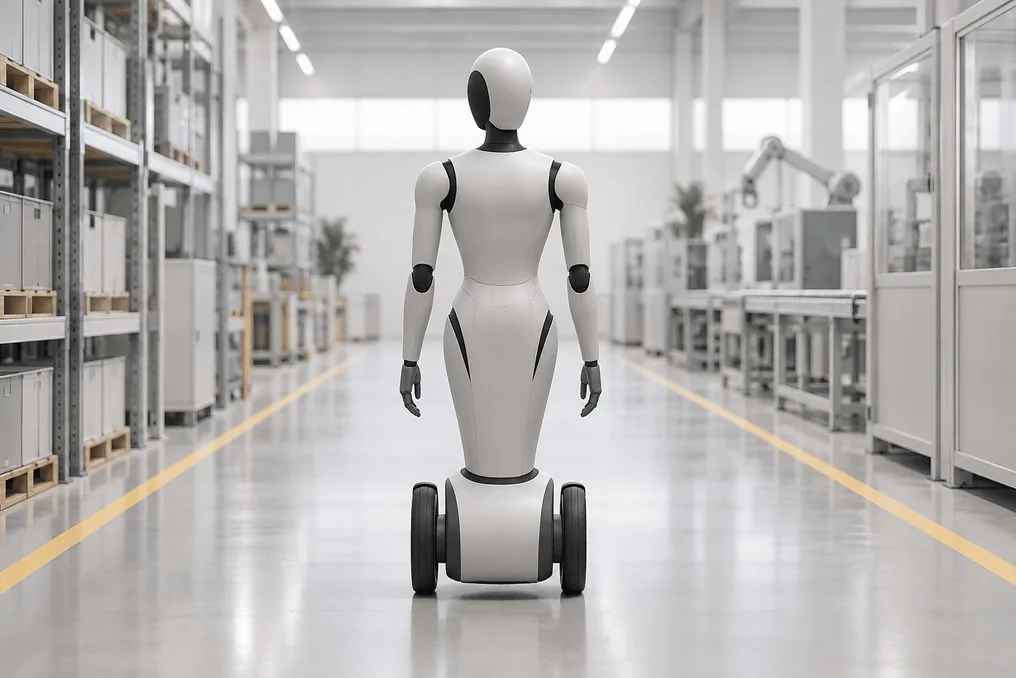
Spirit AI implementou robôs Moz1 nas produções da CATL e JD; fundador prevê avanço em robótica até meados de 2027
Leia mais
Pandaily
pandaily.com

Spirit AI implementou robôs Moz1 nas produções da CATL e JD; fundador prevê avanço em robótica até meados de 2027

A Spirit AI anunciou que dezenas de seus robôs humanoides com rodas, modelo Moz1, já estão operando nas linhas de produção do fabricante de baterias CATL e do varejista JD.com. Gao Yang, cofundador e pesquisador-chefe, declarou à Reuters que espera um 'momento semelhante ao GPT-3' para os robôs cerebrais até meados de 2027. Dentro dessa concepção, o robô será capaz de receber instruções em linguagem natural e tentar executar a sequência física correspondente de ações.

Especificamente, na base da CATL em Zhongzhou, o humanoide Moz da Spirit executa tarefas de finalização de linha e inserção de conectores DCR na linha de pacotes de baterias de potência. Esta linha é uma etapa flexível com vários SKUs e pequenos lotes, que anteriormente exigia trabalho manual com conectores de alta tensão, o que está associado ao risco de faíscas e qualidade irregular.

O robô, que opera com base em um modelo ponta a ponta de visão, linguagem e ação, é capaz de se adaptar a mudanças na postura das peças de entrada, ajustar a força em mangueiras flexíveis, manter uma taxa de sucesso de inserção superior a 99% em ciclos comparáveis aos trabalhadores capazes, aumentar a produtividade diária em três vezes durante o funcionamento contínuo com múltiplos modelos, e também alternar para inspeção de patrulha entre as tarefas principais, notando anomalias nas mangueiras.

Gao, que também é professor adjunto de robótica na Universidade Tsinghua, afirma que o elo mais fraco atualmente é a inteligência de software, e não truques de hardware como sprints ou saltos mortais. Ele prevê que uma janela para aplicação industrial se abrirá no próximo ou nos próximos dois anos, e papéis de serviço comercial com tarefas mais simples podem surgir em cerca de dois anos. No entanto, ele acredita que a criação de robôs domésticos úteis permanecerá significativamente mais difícil, exigindo, segundo sua avaliação, pelo menos oito anos.

A Spirit enfatiza a importância da teleoperação em condições reais e dos dados de sensores vestíveis coletados de cerca de 1000 contratados, em comparação com simulações para objetos deformáveis, como cabos. A empresa relata um sucesso de 90% em tarefas simples em ambientes domésticos estruturados, mas habilidades motoras tão sutis quanto desrosquear a tampa de uma garrafa ainda representam desafios para os modelos.

As medidas de segurança mencionadas incluem controle de força corporal com frenagem de emergência automática em caso de força excessiva de interação. Gao observou que os riscos associados a agentes incontroláveis são menos imediatos enquanto os modelos físicos permanecem imaturos, mas o trabalho de coordenação se tornará mais significativo assim que os modelos básicos atingirem um nível mais autônomo. Essas informações diferem das publicações anteriores dos modelos abertos da Spirit, pois se concentram na implementação da linha Moz1 e no cronograma de Gao em relação aos robôs cerebrais até meados de 2027.
Histórias semelhantes

Ant Group lança o Ling-3.0-flash-VL multimodal com ciclo de feedback de dados visuais
Leia mais
pandaily.com

Ant Group lança o Ling-3.0-flash-VL multimodal com ciclo de feedback de dados visuais

A Ant Group apresentou e disponibilizou ao público o modelo Ling-3.0-flash-VL, que é o primeiro modelo nativo multimodal na linha Ling. O lançamento ocorreu através da organização inclusionAI nas plataformas Hugging Face e ModelScope.

O modelo é construído com base no backbone Ling-3.0-flash do tipo mixture-of-experts e possui um tamanho total de 124 bilhões de parâmetros, ativando cerca de 5,5 bilhões de parâmetros para cada token. Ele é capaz de aceitar como entrada imagens, texto e vídeo, e a empresa indica uma janela de contexto de 256 mil tokens para processar documentos longos e materiais de vídeo. Os pesos nos formatos BF16 e FP8 foram publicados em 9 de setembro, e versões nos formatos FP4 e INT4 estão planejadas em breve.

Uma decisão de design chave foi a implementação de um ciclo de feedback baseado em visão. Este ciclo considera a percepção não como uma etapa única de geração de legendas, mas como parte integrante de um fluxo de trabalho contínuo. O modelo é instruído a observar, agir, verificar e corrigir seus resultados com base em dados visualmente exibidos ou gerados.

A Ant Group posiciona este modelo para automação de interfaces gráficas de usuário (GUI), geração de código frontend e análise de relatórios médicos. Em testes relacionados à conversão de imagens em páginas web, o modelo demonstrou capacidade de restaurar as relações entre componentes e layout, após o que revisava o código gerado, comparando-o com os resultados de renderização. Sob o pseudônimo linthium na Image-to-WebDev Arena, a Ant Group relatou que seu desempenho superou o do GPT-5.4.

Como agente GUI, o modelo sabe analisar a estrutura da interface e correlacionar ações entre diferentes ferramentas. Em cenários de relatórios clínicos, ele destina-se a consolidar informações de diferentes documentos e identificar riscos, e não apenas resumir o conteúdo de uma página.

De acordo com a Ant Group, o treinamento conjunto usando dados multimodais nativos melhorou tanto as capacidades textuais quanto as habilidades visuais do modelo. De acordo com o índice Artificial Analysis Intelligence Index v4.1.1, o Ling-3.0-flash-VL recebeu uma pontuação de 42, quatro pontos acima da versão textual Ling-3.0-flash.

Os materiais do Hugging Face estruturam a avaliação em três áreas: compreensão, raciocínio e ação. Essas áreas incluem o trabalho com layouts e documentos complexos, verificações multifásicas baseadas em evidências e a execução de tarefas controladas por interface. Essa abordagem está alinhada com o objetivo estratégico da empresa de que os pesos multimodais abertos devem ajudar os agentes a fechar ciclos nos fluxos de trabalho de software e clínicos, e não apenas responder a perguntas visuais estáticas.

A arquitetura do modelo combina um codificador de visão de resolução arbitrária e um projetor de duas camadas com codificação temporal VideoRoPE, seguido por um tronco linguístico híbrido de 42 camadas. Este tronco alterna blocos KDA e gated MLA na proporção de 5:1. Graças ao MoE esparso, a carga computacional permanece baixa mesmo durante sessões longas de chat visual e histórico de ações do agente.

Demonstrações estão disponíveis no Ling Studio. Além dos pesos, foram documentadas receitas para SGLang e um fork do vLLM configurado para Ling, incluindo parsers para raciocínio e chamada de ferramentas, adaptados ao template de chat Ling-3.

Para desenvolvedores, este lançamento aberto representa não apenas mais um gerador de legendas, mas um stack multimodal Ling aberto inicial que integra a visão nos processos de planejamento e verificação para tarefas de agentes. É também o primeiro lançamento aberto do Ling a incluir um caminho multimodal nativo com um ciclo de feedback visual explícito, e não apenas um pacote de funções visuais anexado.

Novo IA da Meta automatiza tarefas do usuário, desde envio de e-mails até reserva de passagens
Leia mais
www.aajtak.in

Novo IA da Meta automatiza tarefas do usuário, desde envio de e-mails até reserva de passagens

A Meta apresentou um novo agente de inteligência artificial (IA) autônomo, projetado para simplificar as tarefas diárias dos usuários. Este IA é capaz de executar várias funções autonomamente, incluindo o envio de e-mails, a publicação de anúncios de venda de carros e a reserva de passagens para viagens.

A empresa busca ir além da IA comum, criando um sistema que não apenas responde a perguntas, mas também executa ações em nome do usuário. Graças a esta nova ferramenta, muitas tarefas rotineiras podem ser realizadas com facilidade.

O novo IA da Meta representa um agente pessoal de inteligência artificial desenvolvido para automatizar obrigações diárias. Ele permite resolver tarefas que normalmente exigem um tempo significativo.

Diferente dos chatbots padrão, que principalmente respondem a solicitações, os aplicativos de outros desenvolvedores frequentemente têm dificuldade em abrir aplicativos, enviar mensagens ou concluir processos multifásicos. No entanto, o Muse da Meta foi especificamente criado para automatizar tais tarefas. O usuário só precisa dar uma tarefa à IA, e ela começa a executá-la.

O Muse AI, além de responder a perguntas, pode realizar diversas tarefas. Estas incluem preencher formulários, navegar na web, fazer compras, criar imagens e preparar documentos. Isso significa que o usuário não precisará realizar manualmente muitas operações pequenas; a IA pode ajudar a concluí-las por conta própria.

A inteligência artificial capaz de concluir tarefas autonomamente é chamada de IA de agente. O Muse da Meta é exatamente esse tipo de IA de agente, criada para facilitar o trabalho dos usuários. Quando o usuário lhe delega uma tarefa, o sistema verifica as habilidades integradas necessárias para sua execução. Em seguida, usando essas habilidades, a IA tenta completar a tarefa. Além disso, ele tem a capacidade de se conectar a outros aplicativos, permitindo-lhe realizar operações multifásicas.

O Meta Muse AI está disponível para uso gratuito. Pode ser baixado através da Apple App Store ou Google Play Store, embora possa haver certas restrições de uso ao ser utilizado gratuitamente.

Popular