GPUWorks Ascend, PPU, Hygon va NVIDIAni bitta klasterda qoʻllab-quvvatlovchi inferens platformasini ochdi
Batafsil
Pandaily
pandaily.com

GPUWorks Ascend, PPU, Hygon va NVIDIAni bitta klasterda qoʻllab-quvvatlovchi inferens platformasini ochdi

GPUWorks sunʼiy intellekt inferensi uchun yengil korporativ platforma sifatida Apache-2.0 litsenziyasi ostida 4-noyabr kuni ochiq kodli chiqarildi. Bu haqidagi maʼlumotlar IT Home nashri tomonidan eʼlon qilindi. Kod FlitAI tashkilotida GitHubda mavjud boʻlib, bu korxonalar va ishlab chiquvchilarga inferens va chiplarni moslashtirish shablonlaridan foydalanish, ularni oʻzgartirish yoki hissa qoʻshish imkonini beradi.

Bu platforma turli ishlab chiqaruvchilar va manbalardan kelgan akseleratorlarni bitta boshqariladigan pul ichiga birlashtiradi. U modellar va apparat taʼminotini moslashtiradi, GPU xotirasi talablarini baholaydi va shundan soʻng, OpenAI bilan mos keladigan API orqali ularga kirishni taʼminlaydigan shablonlardagi modellarini joylashtiradi. Qoʻllab-quvvatlanadigan chiplar orasida NVIDIA va AMD, shuningdek, Huawei Ascend, T-Head PPU va Hygon DCU mavjud.

Bare-metal serverlar, virtual mashinalar va bulutli konteynerlar kompaniyaning oʻz markazlari, xususiy yoki jamoat bulutlarida joylashganligidan qatʼi nazar, bitta klasterda ishlashi mumkin.

Platformaning xususiyatlari va samaradorligi

Ishlab chiquvchilar yechimning ixchamligini alohida taʼkidlaydilar: oʻrnatuvchi 40 MB dan ozgina ogʻir, taxminan 60 soniya ichida bitta buyruq bilan oʻrnatiladi va Kubernetesdan foydalanishni talab qilmaydi. Ichki tarmoqdagi foydalanuvchilar oʻrnatuvchini, model fayllarini va ishga tushirish muhiti tasvirini oflayn rejimda yuklab olishlari mumkin. Katalog 400 ga yaqin modellar uchun mingdan ortiq ishga tushirish konfiguratsiyalarini oʻz ichiga oladi, bunda har bir model va chip kombinatsiyasi uchun tasvir, inferens dvigateli, vazn versiyasi va ishga tushirish bayroqlari paketlanadi.

Sunʼiy intellektga asoslangan ichki yordamchi nosozliklarni diagnostika qilishga yordam beradi, va rejalashtiruvchi joylashtirish boʻyicha qabul qilingan har bir qarorni tushuntiradi. Jamoaning oʻz sinovlariga koʻra, bitta GPUWorks serveri 1003 ta GPU serverini boshqarishi va toʻrt daqiqada 500 dan ortiq inferens replikasini ishga tushirishi mumkin edi. Shu bilan birga, faqat toʻqqizta CPU yadrosi va 1,6 GB xotiradan foydalanib, natija sekundiga 69 000 tokenni yetkazdi. Joylashtirilgan DeepSeek-V4.1-Flash ning uygʻonish vaqti atigi 3,6 soniya davom etdi.

Uygʻonish funksiyasi bir nechta katta modellarining bir xil GPUlardan navbatma-navbat foydalanishiga imkon beradi. Birinchi darajadagi uyqu rejimi model vaznlarini host xotirasida saqlab turadi, bu dvigatelni qayta ishga tushirish yoki vaznlarni omboringizdan qayta yuklash zaruriyatini yoʻq qiladi. Otto karta NVIDIA H20 da oʻtkazilgan sinovda, u yerda uchta katta model barcha sakkiz karta boʻylab taqsimlangan edi, NFS omboridan sovuq ishga tushirish 16 dan 17,5 minutgacha vaqt olgan, ammo xotiradan uygʻonishdan keyin xizmatni tiklash taxminan toʻrtta soniya davom etdi, bu esa taxminan 200 baravar yaxshilanishdir. Administratorlar ustuvorlik siyosatlarini, band boʻlmaganda boʻshatish yoki rejalashtirilgan aylantirishni sozlash imkoniyatiga ega.

Katta yuklar uchun platforma koʻp tugunli parallelizm, koʻp nusxalar va preprocessing hamda dekodlashni ajratishni qoʻllab-quvvatlaydi, bu RDMA tarmoq aloqasini yoki Ascend HCCS kanallarini konfiguratsiya qilish imkonini beradi. Shuningdek, kengaytirishdan oldin quvvat va kechikishni tekshirish uchun ichki yuk sinovlari mavjud. Tizim har bir API kaliti, model va joylashtirish boʻyicha tokenlardan foydalanish va keshga tushishni, shuningdek, million chiqish tokenlari uchun karta soatini va ishlatilmayotgan GPUlarni kuzatib boradi. Tugun texnik xizmat koʻrinishida platforma eskilarini ishdan chiqarishni boshlamasdan replikalarni qoʻshadi va agar mashina ishdan chiqsa, xizmatlarni avtomatik ravishda boshqa mos keladigan tugunda tiklaydi.

Oʻxshash hikoyalar

Moore Threads ning Wuxi klasteri 2112 ta GPU bilan tijorat ekspluatatsiyasi boshlanganidan soʻng 92,9% yuklanishga erishdi
Batafsil
pandaily.com

Moore Threads ning Wuxi klasteri 2112 ta GPU bilan tijorat ekspluatatsiyasi boshlanganidan soʻng 92,9% yuklanishga erishdi

Moore Threads ning MTT S5000 grafik protsessorlari asosida qurilgan mahalliy hisoblash klasterining tijorat ekspluatatsiyasi Xuishan, Ussidagi joyda boshlandi. 2-noyabr sanidagi Zhidx hisobotiga koʻra, ushbu markaz iyun oyida birinchi bosqichini boshlagan, iyul oyida sinov rejimiga oʻtgan va oktyabrda tijorat xizmatlariga kirishgan.

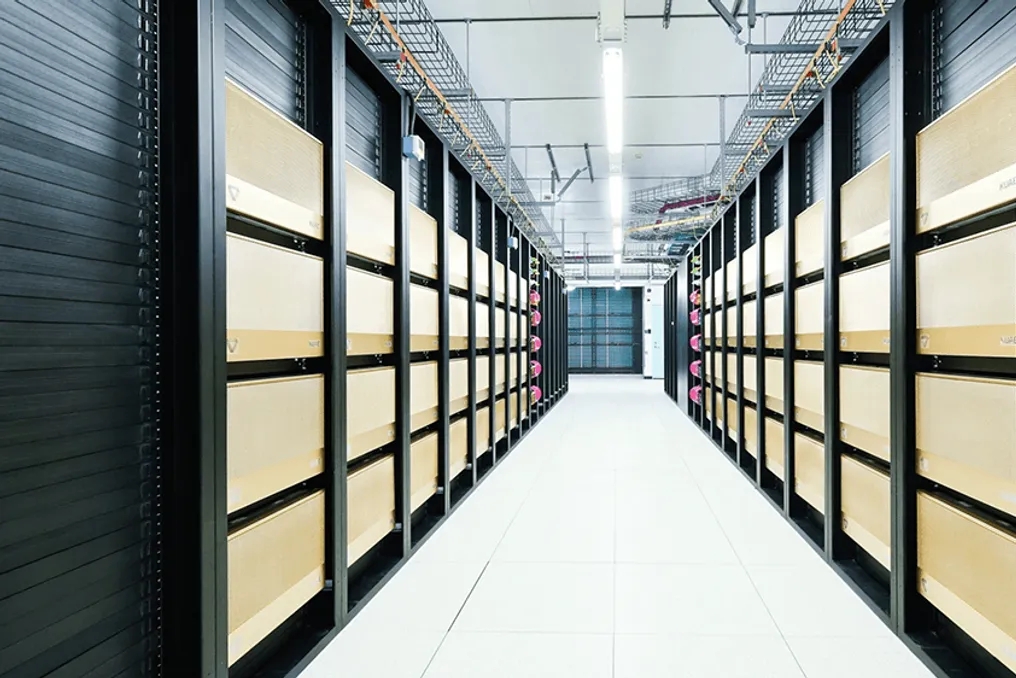
Klasterning joriy bosqichi 2112 ta S5000 kartasi bilan jihozlangan 264 ta serverni oʻz ichiga oladi. Zhidx tomonidan taqdim etilgan maʼlumotlarga koʻra, klaster yuklanishi 92,9% ga yetib borgan. Sinov davrida 55 ta mijoz jalb qilingan va 33 ta model joriy etilgan. Ish yuklarining 62% dan ortigʻi modellarni oʻqitishga toʻgʻri keladi, shu bilan birga aralash oʻqitish va chiqarish 14,7%, toza chiqarish esa 23,1% ni tashkil etadi.

Klaster toʻrtta moduldan iborat boʻlib, har biri taxminan 500 ta karta joylashtiradi va tayyor holda taqdim etilgan. U ishga tushgandan uch oy ichida toʻliq yuklanishga erishdi. Tizim Qwen, GLM, DeepSeek, Kimi va MiniMax kabi 30 dan ortiq model oilalarini qoʻllab-quvvatlaydi.

S5000 havzasidan foydalanib va DeepSeek V4 Flash modeli bilan chiqarishni sinovdan oʻtkazishda, 7 ming kiritma va 2 ming chiqish tokenlari uchun bitta mashinaning tranzmissiya tezligi sekundiga 994,97 token va samarali chiqarish sekundiga 1241 token darajasida qayd etildi. Tizim maqsadli xizmat darajasi (hisobotda H800 konfiguratsiyasining 92% darajasida teng sinovda belgilangan) doirasida 48 ta bir vaqtning oʻziga yuz keladigan soʻrovlarni hal qila oldi. Shuni taʼkidlash kerakki, bu koʻrsatkichlar klaster operatorlari tomonidan taqdim etilgan va mustaqil tekshirilmagan.

Klaster shuningdek, oldindan yuklash va dekodlashni ajratish orqali S5000 kartalarini boshqa tezlatgichlar bilan birlashtiruvchi aralash joylashtirish opsiyasini taklif qiladi. Hisobotda tilga olingan konfiguratsiyalardan birida, uchta S5000 karta ikkita H20 karta bilan birgalikda toʻqqizta H20 karta bilan taqqoslanadigan tranzmissiya tezligini taʼminladi, bu bazaviy darajadan taxminan 1,87 baravar yuqori, shu bilan birga birinchi tokengacha boʻlgan vaqtni taxminan ikki baravar kamaytirdi.

Avtonom transport vositalari ishlab chiqaruvchisi Neolix oʻz avtonomlik modellarini shu maydonda oʻqitishni rejalashtirmoqda, talab hozirgi klasterdagi karta sonidan taxminan besh barobar koʻtarilgan 10 000 karta darajasiga yaqinlashmoqda. Avvalroq Moore Threads S5000 asosidagi 10 000 kartalik klasteri 90% samarali oʻqitish va 95% chiziqli miqyoslash samaradorligi bilan 10 EFLOPS hisoblash quvvatini taʼminlashini eʼlon qilgan edi. Xuishanʼdagi kengaytirish bosqichma-bosqich amalga oshiriladi va hisobotda Moore Threads JD Cloud bilan 100 000 kartalik klaster yaratish boʻyicha ham hamkorlik qilishini eslatib oʻtadi.

Ussidagi maydon Xitoydagi mahalliy tezlatgichlar asosida qurilgan mintaqaviy hisoblash markazlarining oʻsib borayotgan sonining bir qismi hisoblanadi, chunki operatorlar namoyish stansiyalaridan model ishlab chiquvchilari va robototexnika kompaniyalariga katta miqyosda xizmat koʻrsatadigan klasterlarga oʻtishmoqda.

Moore Threads oʻz GPUlari ustida trilyon parametrli MoE modellarini oʻqitish uchun Megatron-MUSA-Titanni ochdi
Batafsil
pandaily.com

Moore Threads oʻz GPUlari ustida trilyon parametrli MoE modellarini oʻqitish uchun Megatron-MUSA-Titanni ochdi

Moore Threads kompaniyasi Megatron-MUSA-Titan loyihasini ommaga oshirdi va oʻzining katta modellarini oʻqitish uchun ishlab chiqqan infratuzilmani taqdim etdi. Ushbu loyiha Moore Threads ning 10 000 dan ortiq GPUdan iborat klasterlarida trilyon parametrli 'ekspertlar aralashmasi' (mixture-of-experts) kabi modellar bilan ishlash uchun moʻljallangan boʻlib, u oldindan oʻqitish va kuchaytirish orqali oʻqitishni qamrab oladi.

Loyihaning kodi GitHubda mavjud. Kompaniya bu tizimning 10 000 GPUli klasterlarda trilyon parametrli MoE ni oldindan oʻqitish uchun uzluksiz foydalanilganini taʼkidlaydi, bunda uzoq oʻquv sessiyalari modelning yuqori FLOPs foydalanishi va jarayon barqarorligini taʼminlagan.

Repositoriyda 1 trilyon parametrli Kimi-K2 uslubidagi MoE modeli uchun konfiguratsiya namunasi keltirilgan. Dizaynning asosiy tamoyili mavjud yechimlarga yaqinlikni saqlab qolish edi. Megatron-MUSA-Titan NVIDIA ning Megatron-LM freymvorki asosida qurilgan. torch_musa orqali PyTorch integratsiyasi va MUSA C ning CUDA C bilan mos kelishi tufayli, MUSA muhiti mavjud dasturchilar Megatron-LM, slime va miles ning rasmiy repositoriyalarini klonlab, kodni oʻzgartirish shartmasdan Moore Threads GPUlarida oʻqitishni boshlashlari mumkin.

Loyiha umumiy algoritmlar va xatolarni tuzatishlarni yuqori darajadagi loyihalarga yoʻnaltirish kerakligini koʻrsatadi, shu bois Moore Threads ikkita turdagi oʻzgarishlarga eʼtibor qaratadi: Moore Threads uskunalari va klasterlari uchun moslashtirilgan keng miqyosli optimallashtirishlar hamda MUSA ning maxsus muammolari uchun yechimlar.

Oldindan oʻqitish funksiyalari Moore Threads ning MT-TransformerEngineiga tayanadigan FP8 formatidagi blokli oʻqitishni oʻz ichiga oladi. MoE tokenlarini yoʻnaltirish va birlashtirish kompaniyaning Async Copy Enginei ustida ishlaydigan DeepEP yordamida tezlashtiriladi, bu esa ekspertlar kommunikatsiyasini hisoblashlar bilan parallel ravishda amalga oshirish imkonini beradi. Boshqa variantlar orasida virtual konveyer parallelizmi yordamida aktivatsiyalarni yuklash va bitta oldinga va bitta orqaga oʻtishni rejalashtirish, shuningdek, Mooncake RDMA orqali hisob-kitoblar bilan birgalikda konveyer parallel kommunikatsiyasi mavjud.

Tarqatilgan izlash tahlil asbobi har bir GPU dan PyTorch izlashlarini oʻqib, konveyer pufakchalari va past samaradorlikdagi tugunlar kabi sekin joylarni aniqlaydi. Loyiha 10 000 GPUda 1 trilyon parametrli MoE ishga tushirishni atigi bir necha soat ichida tahlil qilish qobiliyatiga ega ekanligini taʼkidlaydi.

Kuchaytirish orqali oʻqitish uchun stack slime va miles freymvorklarini qoʻllab-quvvatlaydi; Megatron oʻqitish bilan shugʻullanadi, MUSA-SGLang yigʻindisi esa oʻtishlarni yaratadi, bu esa bitta asosiy tizimga oldindan oʻqitish va RL ikkalasini ham xizmat koʻrsatish imkonini beradi. Mustaqil inferens uchun optimallashtirish ushbu loyiha doirasiga kirmaydi.

Milliy akseleratorlarni koʻrib chiqayotgan ishlab chiquvchilar uchun amaliy savol shundaki, mavjud oʻquv kodining qaysi qismi ishlayveradi. Moore Threads ning javobi shuki, Megatron ekotizimi kodi oʻzgarish talab qilmaydi.

Iluvatar CoreX Tiangai 300 GPU ishini namoyish etdi va uning samaradorligi H200 dan 1.05x oshganini bildirdi
Batafsil
pandaily.com

Iluvatar CoreX Tiangai 300 GPU ishini namoyish etdi va uning samaradorligi H200 dan 1.05x oshganini bildirdi

Iluvatar CoreX kompaniyasi Shanghayda oʻtkazilgan media kuni davomida umumiy maqsadli Tiangai 300 grafik protsessorini real uskuna ustida ishlaydigan holatda birinchi marta taqdim etdi. Bu safgacha kompaniyaning chiplar haqidagi jamoatchilik materiallari faqat arxitektura va yoʻl xaritasi bilan cheklangan edi, ishlayotgan tizimlar bilan emas.

Asosiy eʼlon samaradorlikni solishtirishdir. Iluvatar CoreX taʼkidlashicha, Tiangai 300 NVIDIA H200 darajasiga yetadigan oʻlchangan samaradorlikka ega boʻlgan birinchi mahalliy umumiy maqsadli GPU boʻldi. Bundan tashqari, maʼlumotlarni konvertatsiya qilishdan soʻng, uchinchi tomon sinovlari bitta karta umumiy quvvatining H200 ga nisbatan 1.05 barobar koʻrsatilishini koʻrsatdi. Muhim jihati shundaki, kompaniya sinov metodologiyasini, ishlatilgan modellar yoki yuklash sharoitlarini oshkor qilmagan, shuning uchun bu natija hozircha mustaqil tekshirib boʻlmaydi.

Bu chip IXL144 supertuguniga integratsiya qilish uchun moʻljallangan, bu tugun avval kompaniya tomonidan Xitoy xalqaro sanoat yarmushida taqdim etilgan edi. IXL144 ning bir stendining 144 ta GPU, 18 ta CPU va taxminan 10.1 TB GPU xotirasini birlashtiradi, bu Iluvatar CoreX uni sanoatdagi eng zich GPU supertuguni deb ataydi. Oʻz baholariga koʻra, bunday konfiguratsiya asosiy xalqaro yechimlarga qaraganda million effektli token uchun narxni 40% ga kamaytiradi.

Ochiq kunida heterogen joylashtirish haqida ham maʼlumotlar taqdim etildi. Iluvatar CoreX GPU va XPU oʻrtasida birinchi mahalliy AFD dezagregatsiyasi sxemasini amalga oshirganini maʼlum qildi, bu inferens kechikishini 60% gacha qisqartirishga imkon berdi. AFD dezagregatsiyasi odatda model hisoblash bosqichlarini, masalan, diqqat va toʻgʻri tarqatish qatlamlarini turli protsessor turlari oʻrtasida ajratishni anglatadi, toki har biri eng samarali bajaradigan ishni bajarsin.

Periferik qurilmalar borasida esa, kompaniya oʻzining Tongyang TY1200 chipi testlarda NVIDIA Thor T5000 dan ustun ekanligini maʼlum qildi, yana batafsil maʼlumotlarsiz. Avval AI va uygʻun intellektga ega kompyuterlar uchun 300 TOPS zich hisoblashlar bilan eʼlon qilingan TY1200, shuningdek, MuJoCo-Warp asosidagi GPU tezlatilgan fizikani simulyatsiya qila oladigan birinchi mahalliy periferik mahsulot sifatida nomlandi — bu robotlarni simulyatsiyada oʻqitish uchun juda muhim funksiya.

Umuman olganda, bu namoyishlar Iluvatar CoreX ning keyingi avlod mahsulot liniyasini qogʻoz spetsifikatsiyalardan ishlayotgan tizimlarga olib chiqmoqda. Keyingi kuzatilishi kerak boʻlgan nuqta — bu yuklashlar oshkor qilingan mustaqil benchmarklar boʻladi.

Mashhur