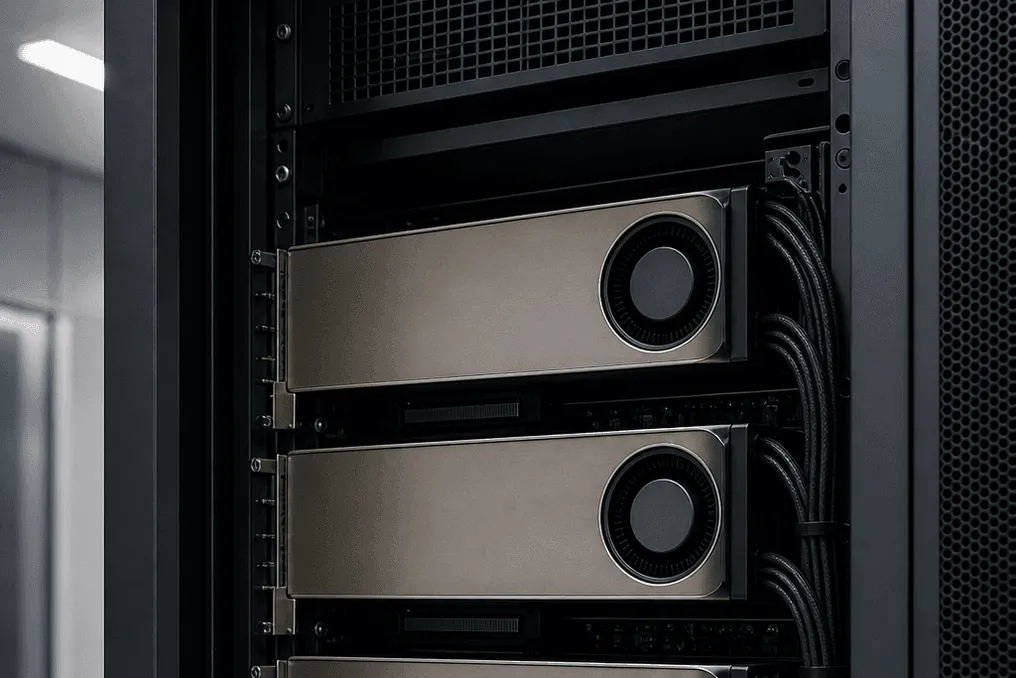
China Mobile Cloud katta til modellarini (LLM) aralash inferens uchun mahalliy gibrid tizimni taqdim etdi, u grafik protsessorlarni (GPU) va neyromorf texnologiyalarni birlashtiradi. Ushbu tizim 2026 yilda Hebei provinsiyasi, Lanfangdagi hisoblash quvvati konferensiyasida birinchi marta namoyish etildi.
Bu stekni ishlab chiqishda China Mobile Cloud, shuningdek, Xitoyning Nanhu elektronika texnologiyalari tadqiqot instituti (China Electronics Technology Nanhu Research Institute), Lynxi, Iluvatar CoreX, Tsinghua universiteti va Pekin universiteti ishtirok etdi. China Mobile Cloud ning neyromorf va optik laboratoriyasi texnik direktori Du Yujian taʼkidlaganidek, neyromorf imkoniyatlari mavjud GPU parklarini toʻliq almashtirish talab qilmasdan ularni tezlashtirishga qaratilgan.
Asosiy konsepsiya Transformerni ishning turli chip turlari oʻrtasida aniq ajratishdan iborat. Eʼtibor hisob-kitoblari Iluvatar CoreX ning mahalliy GPUlarida ularning umumiy tranzit quvvatidan foydalangan holda qoladi. Toʻgʻridan-toʻgʻri tarqatish bloklari (feed-forward network blocks), shu jumladan ekspertlar va ekspertlarni aralashtirish mexanizmi (mixture-of-experts) kabi kechikish uchun muhim boʻlgan bloklar Lynxi neyromorf kremiyasiga koʻchiriladi. Bu kremiy chip xotirada hisoblashlar va kristalda katta hajmdagi SRAM uchun optimallashtirilgan boʻlib, bu yuqori raqobatbardoshlikka ega tokenlarni xizmat qilishda bitta GPU arxitekturasidagi 'xotira devori' va 'quvvat devori' tomonidan yaratilayotgan bosimni kamaytirishga yordam beradi.
Bu ikki tuzilmani sinxronlashtirish uchun oʻzi ishlab chiqilgan model kompyutatori, yuqori tezlikdagi bogʻlanish protokoli va birlashtirilgan inferens mexanizmi qoʻllaniladi, ular vazifalarni dekompozitsiya qilish, birgalikda rejalashtirish va natijalarni agregatsiya qilish uchun javobgardir.
Test yuklamasi sifatida DeepSeek V4 Flash tanlandi. China Mobile Cloud boshqa mahalliy GPU klasterlariga qaraganda, ushbu gibrid stek inferens chiqishini va energiya samaradorligini ikki barobar oshiradi hamda biznes operatsion xarajatlarini 40% dan ortiq kamaytiradi deb daʼvo qiladi. Hamkorlar bu koʻrsatkichlarni yetuk mahalliy jarayonlar asosidagi arxitektura, tizim dasturiy taʼminoti va yuklamalarni joylashtirishga urgʻu berib, nafaqat jarayonlar va tugunlar yaroshiqiga bogʻliq boʻlishini tushuntiradilar. Ular shuningdek, bu modelni mahalliy GPUlardan foydalanayotgan boshqa operatorlar ham takrorlashi mumkin deb hisoblashadi.
Konferensiya materiallari shuni koʻrsatadiki, PD va Attention-FFN ajratilishining keyingi joriy etilishi maqsadlari token fabrikalari, AI kodlash, matndan videoga aylantirish, koʻp agentli oʻzaro aloqa, aqlli ishlab chiqarish, shuningdek, moliyaviy va kommunikatsiya xavfsizligi boʻladi.
Konsorsium heterogen dvigatelni takomillashtirish va asosiy freymvorkning qismlarini mahalliy GPU, neyromorf chiplar va hisoblash operatorlari ishlab chiqaruvchilari uchun asta-sekin ochish rejasini eʼlon qildi. Tokenning narxiga yoʻnaltirilgan bulut xizmatlari sotuvchilari uchun bu debiut bitta akseleratorning toj kiyishi emas, balki Attention-on-GPU + MoE FFN-on-neuromorphic rejalashtirish trafik konferensiya standidan chiqqandan soʻng kechikish, chiqish va foydalanishni qoʻllab-quvvatlay olishi tekshiruvi hisoblanadi. Ishga tushirish paytida hamkorlarning DeepSeek V4 Flash sozlamalaridan tashqari uchinchi tomon klasterlari uchun mustaqil benchmarklar chop etilmadi; bu maʼlumotlar paydo boʻlguncha hisoblash quvvati konferensiyasidagi debiut asosan tayyor SKU sigʻimi emas, balki dasturiy taʼminot va kremiyaning qayta tiklanadigan retseptini hujjatlashtiradi.